7096 Star 的「江山时序」:一个纯原生 JS 项目,怎么把两千四百年中国史做成可拖动的交互舆图
读史书时有个恒久的困惑:苏东坡被贬的黄州、韩愈勒马的蓝关、岳飞北伐的朱仙镇,放在今天的地图上到底在哪儿?长安在两千年里换过多少个名字?最近有个开源项目把这些问题装进了一张可以拖动时间轴的古舆图里——它叫 江山时序,7096 Star、831 Fork,GPL-3.0 协议,时间跨度从公元前 403 年三家分晋一直到今天。
让我感兴趣的不只是题材,而是它的工程实现:这样一个数据密集的历史 GIS,居然没有用任何地图框架。我把仓库克隆下来逐个文件读了一遍,这篇讲清楚它是怎么用纯原生 JavaScript 撑起两千四百年时空的,以及一个个人数字人文项目的可信边界在哪里。
一、先看家底:18 朝代、206 个 GeoJSON、3.4 万行零依赖代码
项目根目录没有 package.json,也没有 node_modules——这在今天的前端项目里相当罕见。我核对了它的实际构成:
js/下 17 个 JavaScript 模块,合计约 3.45 万行,最大的app.js有 10772 行;data/atlas/按 18 个历史时期分目录(战国、秦、西汉、东汉、三国、西晋、东晋、南北朝、隋、唐、五代、北宋、南宋、元、明、清、民国、当代),共 206 个 GeoJSON 文件,数据约 32MB;- 时序快照 205 个,每个都带年代标题和史事考辨文字;
- 提供简体、繁体、英文、日文四语言 README 和界面字典。
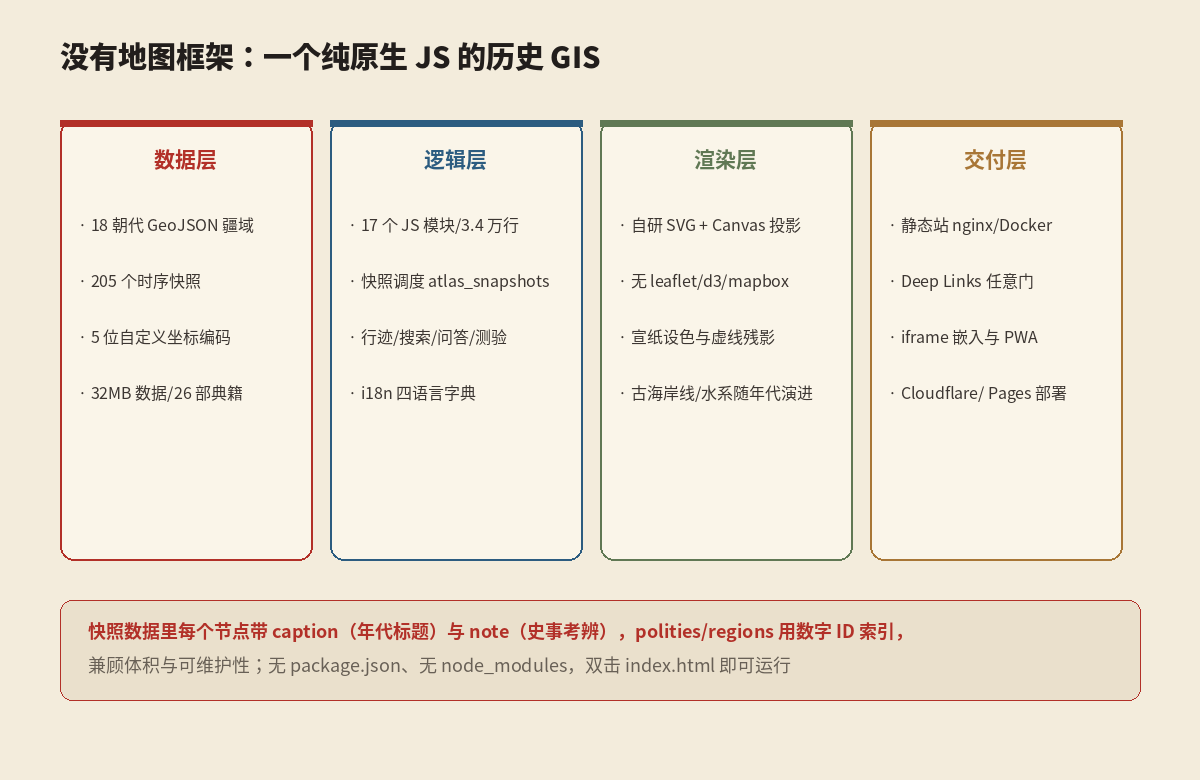
最关键的一点:我在 index.html 和启动脚本里没有找到 leaflet、mapbox、openlayers、d3 这些常见地图/可视化库的引用,地图投影、SVG 路径生成、交互命中全部是自研的。第三方资源只有 Google Fonts 的思源宋体、一个访问量统计和 Cloudflare 监控,换句话说,双击 index.html 就能离线跑起来整个应用。部署也极简,Dockerfile 只有三行,基于 nginx-alpine 直接托管静态文件。
二、四种玩法:把历史课本变成可交互的舆图
README 把功能归纳成四种玩法,我在源码里逐一对应到了实现模块。
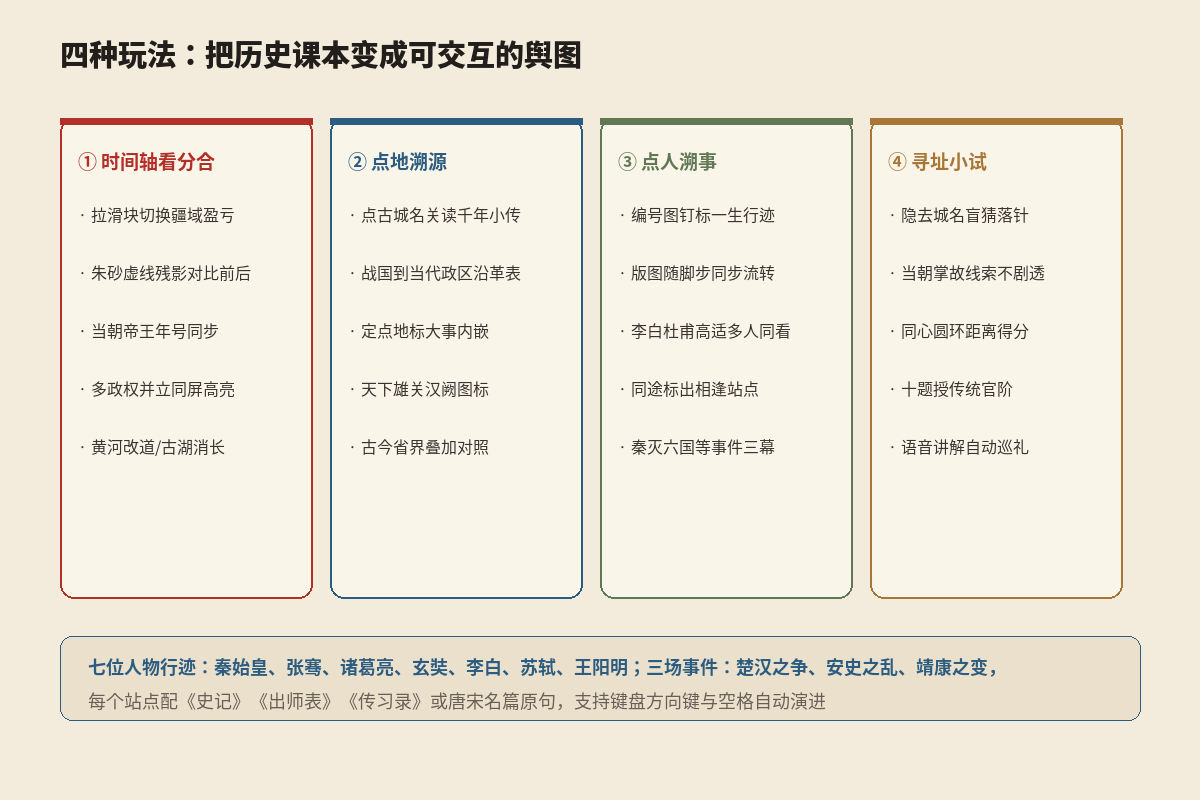
第一种是拉动时间轴看天下分合。 这是项目的主心骨。拖动滑块时,多个并立政权以高对比度的宣纸设色同屏呈现——战国七雄、三国群雄、宋辽西夏大理金的对峙都能一屏看全。切换到重大事件节点时,新版图浮现,上一阶段的疆域以朱砂虚线残影留在画面上,盈亏对比非常直观。时间轴上方的气泡会同步显示当年在位君主和年号,比如"西汉武帝·天汉元年";黄河改道、云梦泽和罗布泊的消长、历代长城与大运河、古海岸线进退,都会跟着年代一起变化。
第二种是点地溯源。 点击任意古城或名关,会展开一张卡片,顶部是这座城的题记小传,下面是从战国的郡、汉代刺史部、唐代的道、宋代的路,一直到元明清行省和现代省市的沿革表;本地发生过的大事(咸阳的商鞅变法、长安的玄武门之变、临安的风波亭)按朝代内嵌。函谷关、潼关、剑门关、玉门关等天下雄关用专门的汉阙城楼图标标注。右上角还能把今天的省界叠在古图上做古今对照。
第三种是点人溯事。 搜索任意人物,地图用编号图钉标出其一生行迹,随着"下一站"切换,年份、版图、年号跟着人物脚步流转。目前内置了七位人物的完整行迹:秦始皇、张骞、诸葛亮、玄奘、李白、苏轼、王阳明;还支持一次输入多个人物(比如"李白 杜甫 高适"),把他们的轨迹合并到同一时间轴,同年同地的相逢标为"同途"。重大事件则有楚汉之争、安史之乱、靖康之变三个,各以十个节点分三幕展开。
第四种是舆图寻址小试。 一个测验模式:隐去所有城名,给出当朝掌故线索(不剧透现代地名),让你凭山河水系的直觉在图上落针,按同心圆环距离打分,十题结束授予"太史令"“职方郎中"这类传统官阶。另外还有基于浏览器语音合成的自动讲解。
三、数据模型:一个疆域快照里装了什么
这个项目最见功夫的是数据组织。我打开 atlas_snapshots.js 看了它的快照结构。
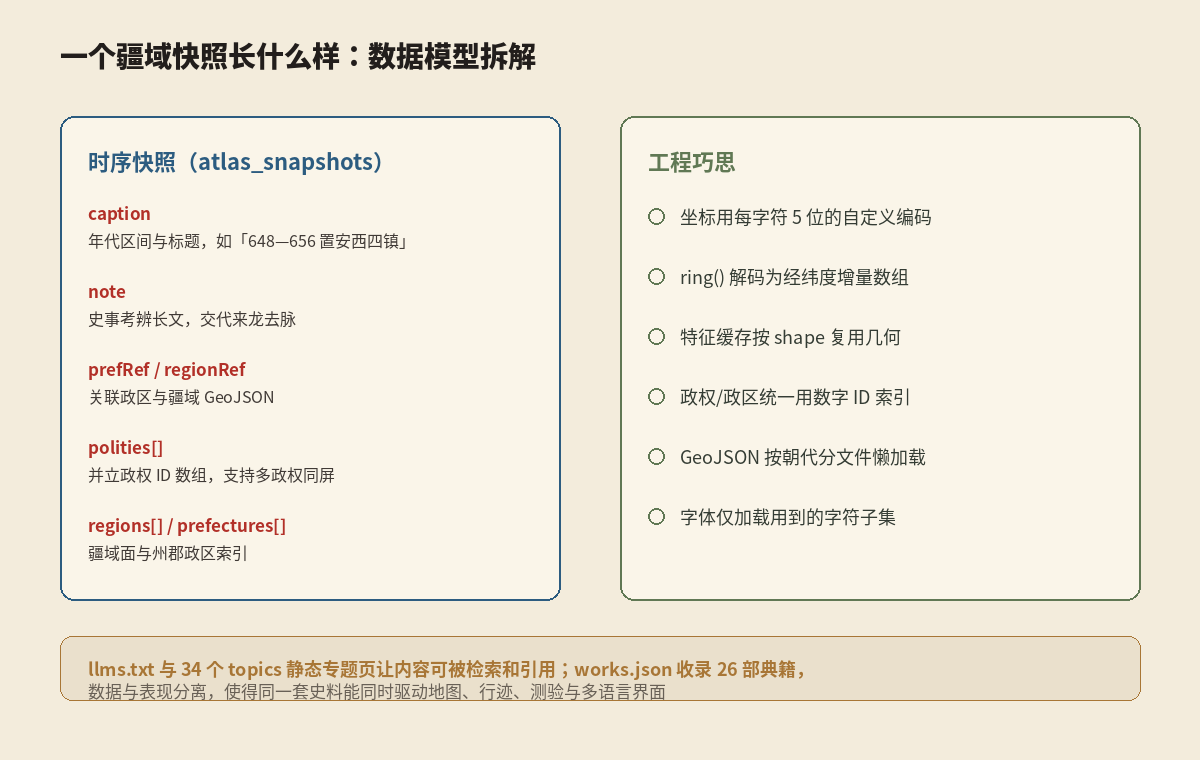
每个快照(比如 s_tang_a2b,对应 648—656 年阿史那社尔平龟兹、置安西四镇)包含这么几类字段:caption 是年代区间和标题,note 是一段完整的史事考辨文字,prefRef/regionRef 指向政区和疆域的 GeoJSON,polities 数组用数字 ID 列出当时并立的所有政权,regions 和 prefectures 则索引疆域面与州郡。这种设计让同一个时间点的"政权—疆域—政区—史事"形成了结构化关联,而不是一张孤立的地图图片。
为了把 32MB 的历史地理数据塞进一个纯静态站,作者做了几层压缩,我在解码函数里确认了实现:
- 地理坐标用每字符 5 位的自定义编码存储,
ring()函数把字符串解成经纬度增量数组——存相对位移而非绝对坐标,是典型的几何压缩思路; - 相同几何形状通过
shape特征缓存复用,避免重复存储; - 政权和政区全部用数字 ID 索引,快照之间靠引用而非复制数据;
- GeoJSON 按朝代拆文件按需懒加载,网页字体也只加载实际用到的字符子集。
此外,works.json 收录了 26 部典籍,topics/ 下有 34 个静态专题页(朝代综述、战役、人物行迹、诗词路线),根目录还放了 llms.txt 方便内容被检索和 AI 引用。数据与表现严格分离,使得同一套史料能同时驱动地图、行迹、测验和多语言界面。
四、Deep Links:让每个历史瞬间都有一个网址
一个容易被忽略但很实用的设计是深度链接。应用的每个状态都反映在 URL 参数里:?year=-403 跳到三家分晋,?year=208&place=赤壁 定位赤壁之战,?person=sushi 展开苏轼的贬谪路线,?year=1079,1080,1094,1097&place=湖州,黄州,惠州,儋州 能画出"黄州惠州儋州"的跨年路线,加 &embed=1 则进入适合 iframe 的嵌入模式。
这意味着老师讲安史之乱、博主写诗词文章时,可以把一个精确到年份和地点的历史画面作为链接分享,或者直接嵌进博客、Notion 和课程页面。配合 PWA manifest,它也能被安装成离线应用。
五、祛魅:数字人文作品的可信边界
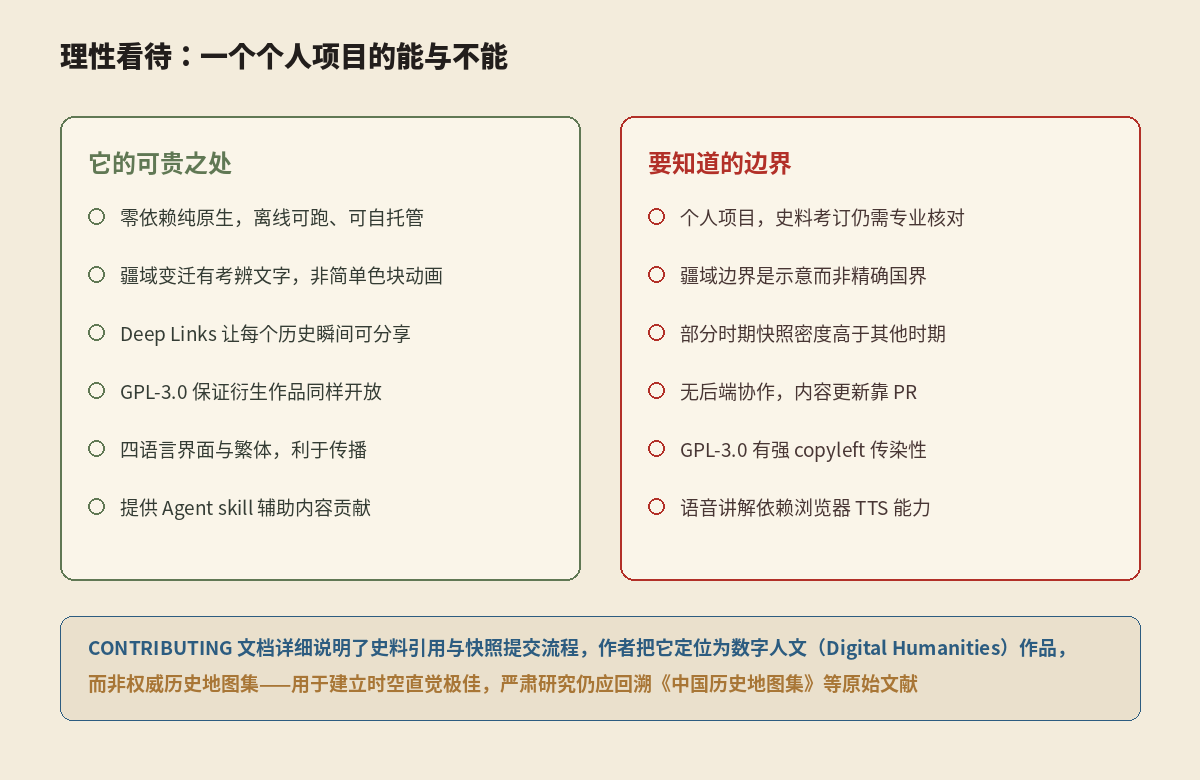
喜欢这个项目的同时,几条边界必须讲清楚。
第一,它是个人项目而非权威历史地图集。 作者在贡献指南里把它明确定位为数字人文(Digital Humanities)作品。疆域边界是示意性的,古代政权的实际控制线本来就难以精确还原,图上的色块不能当作精确国界来引用;严肃的历史地理研究,仍应回溯谭其骧主编《中国历史地图集》等原始文献。
第二,快照密度并不均匀。 战国、唐、清这些资料丰富或变动剧烈的时期切片很细,少数时期相对粗疏,这是史料分布决定的,使用时要意识到时间分辨率的差异。
第三,协议是 GPL-3.0 而不是宽松的 MIT。 这一点对二次开发很关键:GPL 有强 copyleft 传染性,如果你把它的代码或数据整合进自己的项目并分发,衍生作品通常也要以同等协议开源。只是个人学习、内部使用或仅做 iframe 嵌入则不受影响。
第四,内容更新依赖社区 PR。 它没有后端数据库,所有考订都在静态数据里,修正一条史料要走 GitHub 提交流程;语音讲解也依赖浏览器自身的 TTS 能力,不同设备音色和支持度有差异。
我的判断
江山时序最打动我的,是它用一种近乎古典的方式做现代数据可视化:不追框架、不堆依赖,靠 17 个原生模块和严谨的数据建模,把两千四百年的政权更迭、政区沿革和人物行迹组织成一个可探索、可引用、可离线运行的整体。那些写进每个快照的 note 考辨文字、虚线残影的盈亏表达、诗词路线的任意门,都说明作者真正在乎的是"让人建立时空直觉”,而不只是炫技。
对历史爱好者、语文和历史老师、内容创作者,它是一个难得的直观教具;对前端开发者,这个零依赖的自研 GIS 也是研究几何压缩和状态驱动渲染的好样本。只是别忘了它的定位——它是帮你走进历史的门,而不是替代原始史料的结论。