JdbcPagingItemReader 如何解决深分页?源码、联合主键与并发断点续读详解
用 Spring Batch 遍历 MySQL 大表,很多讨论最后都会落到一句“分页有性能问题”。这句话不够准确。offset 深分页、无索引过滤、大事务、并发恢复,是四种不同的问题,优化方法也不一样。
本文以 spring-batch-infrastructure:4.3.6 为准,看看 JdbcPagingItemReader 实际生成了什么 SQL,再讨论单主键、联合主键、失败重启和多线程读取。
MySQL 后续页不是 offset,而是排序键游标
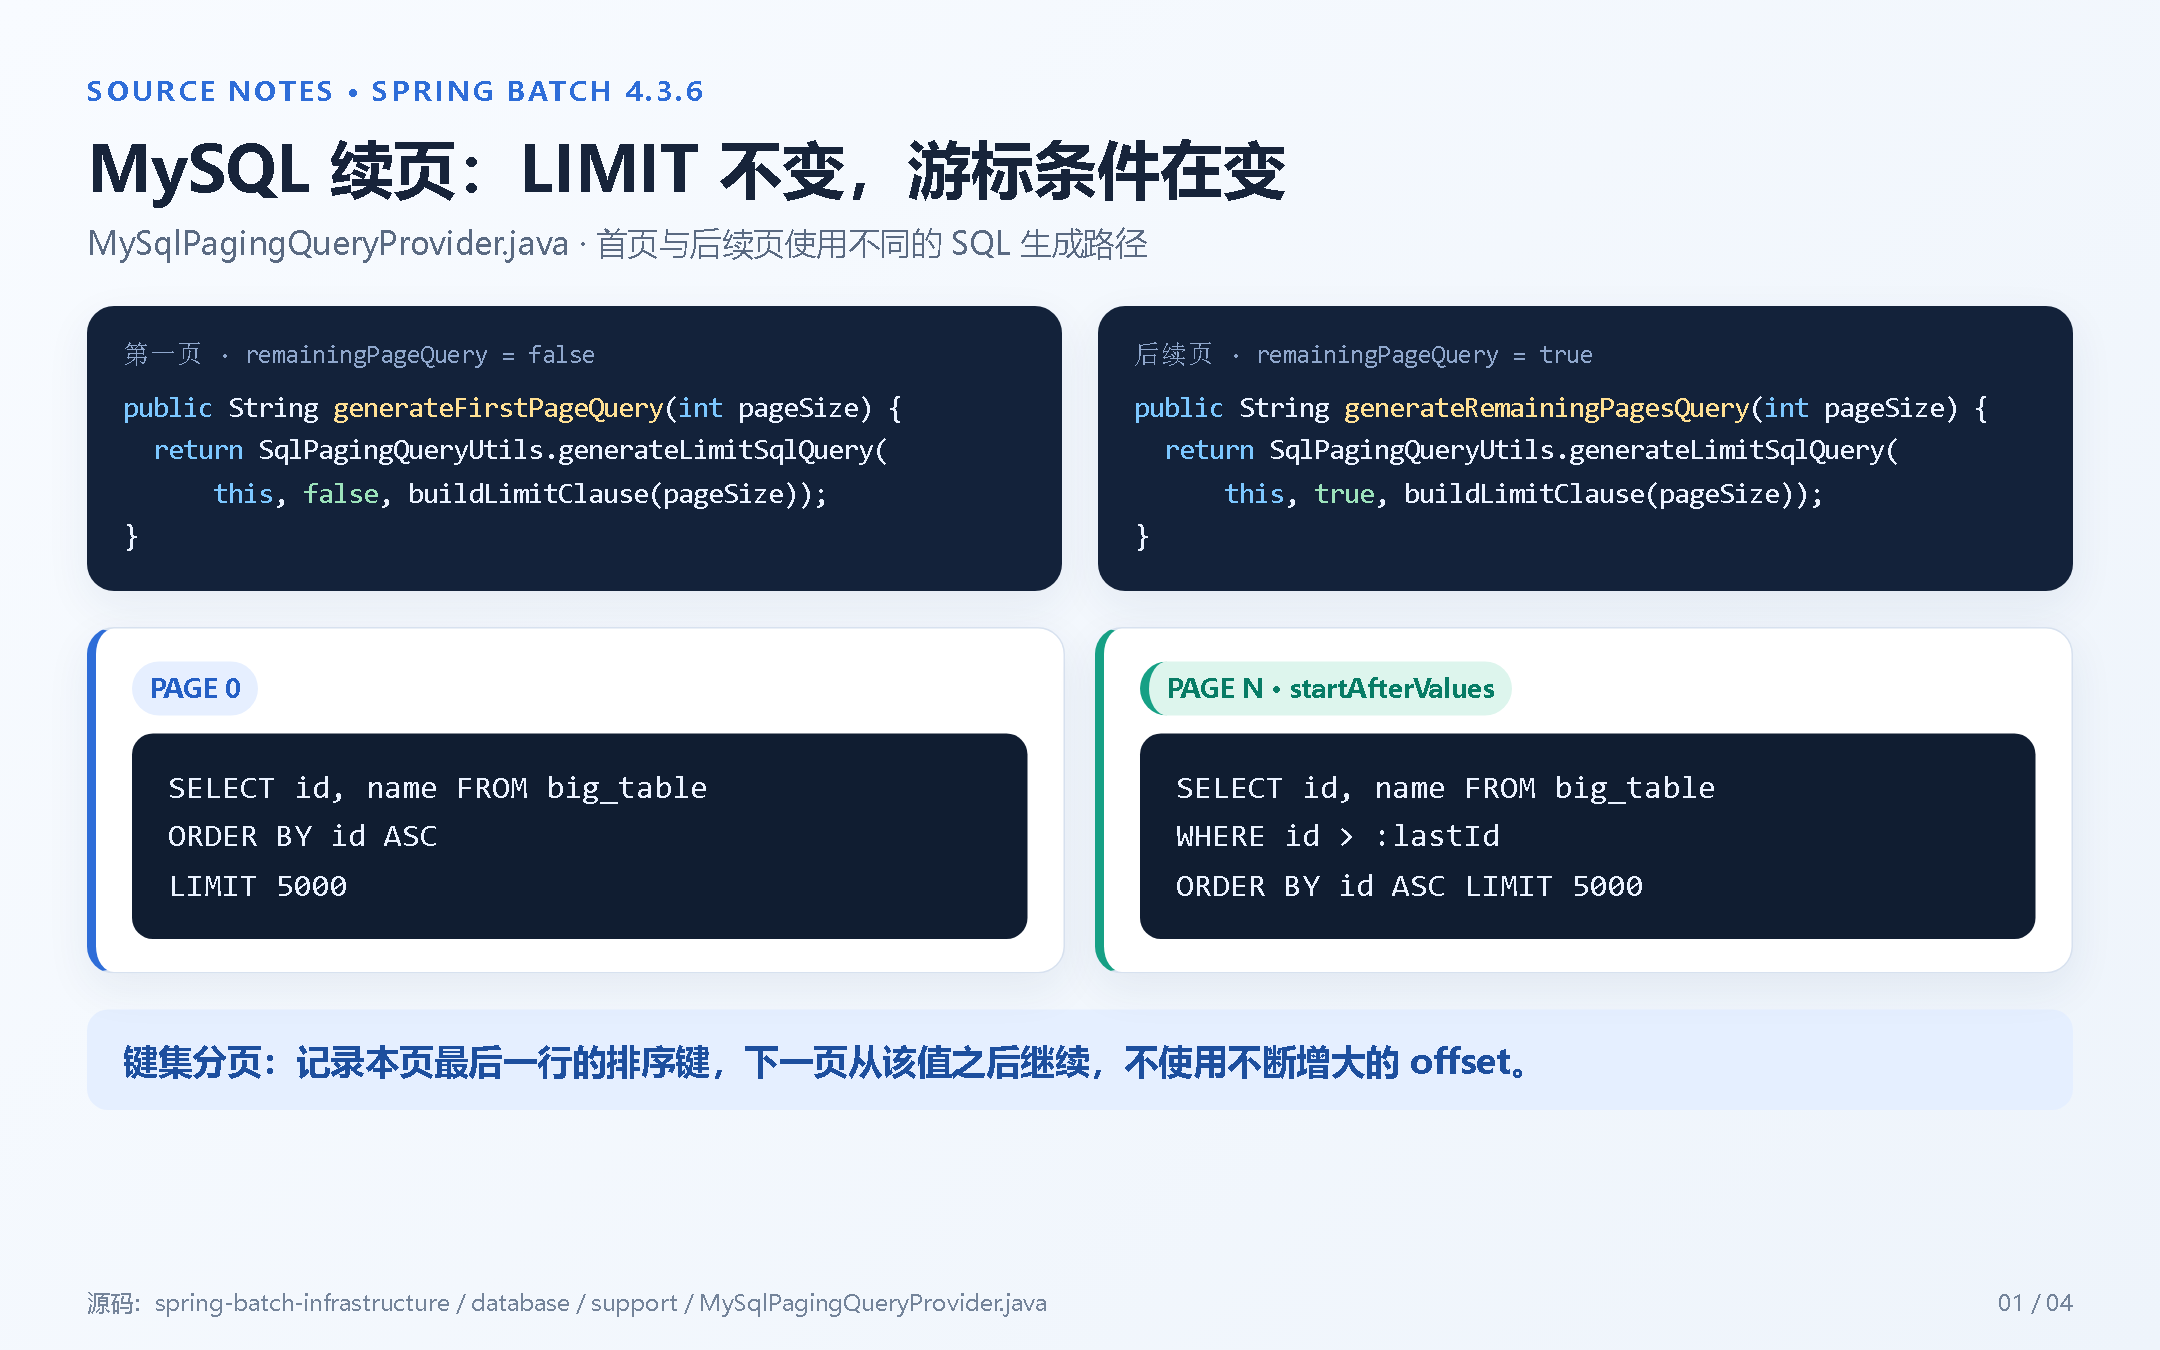
JdbcPagingItemReader 不直接拼 MySQL 方言 SQL,而是交给 PagingQueryProvider。使用 SqlPagingQueryProviderFactoryBean 并识别为 MySQL 后,实际实现是 MySqlPagingQueryProvider。
它的两个核心方法很能说明问题:
@Override
public String generateFirstPageQuery(int pageSize) {
    return SqlPagingQueryUtils.generateLimitSqlQuery(
            this, false, buildLimitClause(pageSize));
}

@Override
public String generateRemainingPagesQuery(int pageSize) {
    return SqlPagingQueryUtils.generateLimitSqlQuery(
            this, true, buildLimitClause(pageSize));
}
false 表示第一页,true 表示后续页。后续页会在原查询上追加排序键条件。
假设查询为:
SELECT id, name, status
FROM big_table
ORDER BY id ASC
每页 5000 条,第一页和后续页等价于:
-- 第一页
SELECT id, name, status
FROM big_table
ORDER BY id ASC
LIMIT 5000;

-- 后续页
SELECT id, name, status
FROM big_table
WHERE id > :lastId
ORDER BY id ASC
LIMIT 5000;
这里的 lastId 来自 JdbcPagingItemReader 内部的 PagingRowMapper。每映射一行,它都会执行类似下面的逻辑:
startAfterValues = new LinkedHashMap<>();
for (Map.Entry<String, Order> sortKey : queryProvider.getSortKeys().entrySet()) {
    startAfterValues.put(sortKey.getKey(), rs.getObject(sortKey.getKey()));
}
一页处理完后,Map 中留下的是本页最后一行的排序键。下一页从这个值继续,所以称为键集分页,也叫 Seek Pagination。
传统深分页则是另一种执行方式:
SELECT ...
FROM big_table
ORDER BY id
LIMIT 100000000, 5000;
MySQL 通常要先找到并跳过前面的一亿行。offset 越大,无效扫描越多。键集分页通过主键 B+ 树定位到上一页末尾,再向后读取,避免了反复扫描前面的页。
但有一件事不能混淆:遍历一亿行本来就有 IO、CPU、网络和 Writer 处理成本。键集分页解决的是“越翻越慢”,不会让全表遍历变成轻量操作。
单主键与联合主键:区别在 sortKeys,不在 Reader 是否认识主键
Reader 不会读取数据库的主键定义。它只使用你配置的 sortKeys,主键只是最常用的排序键,因为唯一且非空。
单字段主键
对于 PRIMARY KEY(id),配置一个升序排序键即可。后续页条件是:
WHERE id > ?
ORDER BY id ASC
LIMIT 5000
游标只保存一个 ID,主键索引与排序顺序天然一致,执行计划通常也比较直观。
联合主键
假设表结构是:
PRIMARY KEY (tenant_id, id)
排序键应该按联合索引顺序配置:
Map<String, Order> sortKeys = new LinkedHashMap<>();
sortKeys.put(tenant_id, Order.ASCENDING);
sortKeys.put(id, Order.ASCENDING);
这里用 LinkedHashMap 不是为了形式好看。字段顺序会决定 ORDER BY、游标条件和参数绑定顺序。
SqlPagingQueryUtils.buildSortConditions() 使用两层循环展开排序条件。上面的联合排序键会生成:
WHERE (
    tenant_id > ?
    OR (tenant_id = ? AND id > ?)
)
ORDER BY tenant_id ASC, id ASC
LIMIT 5000;
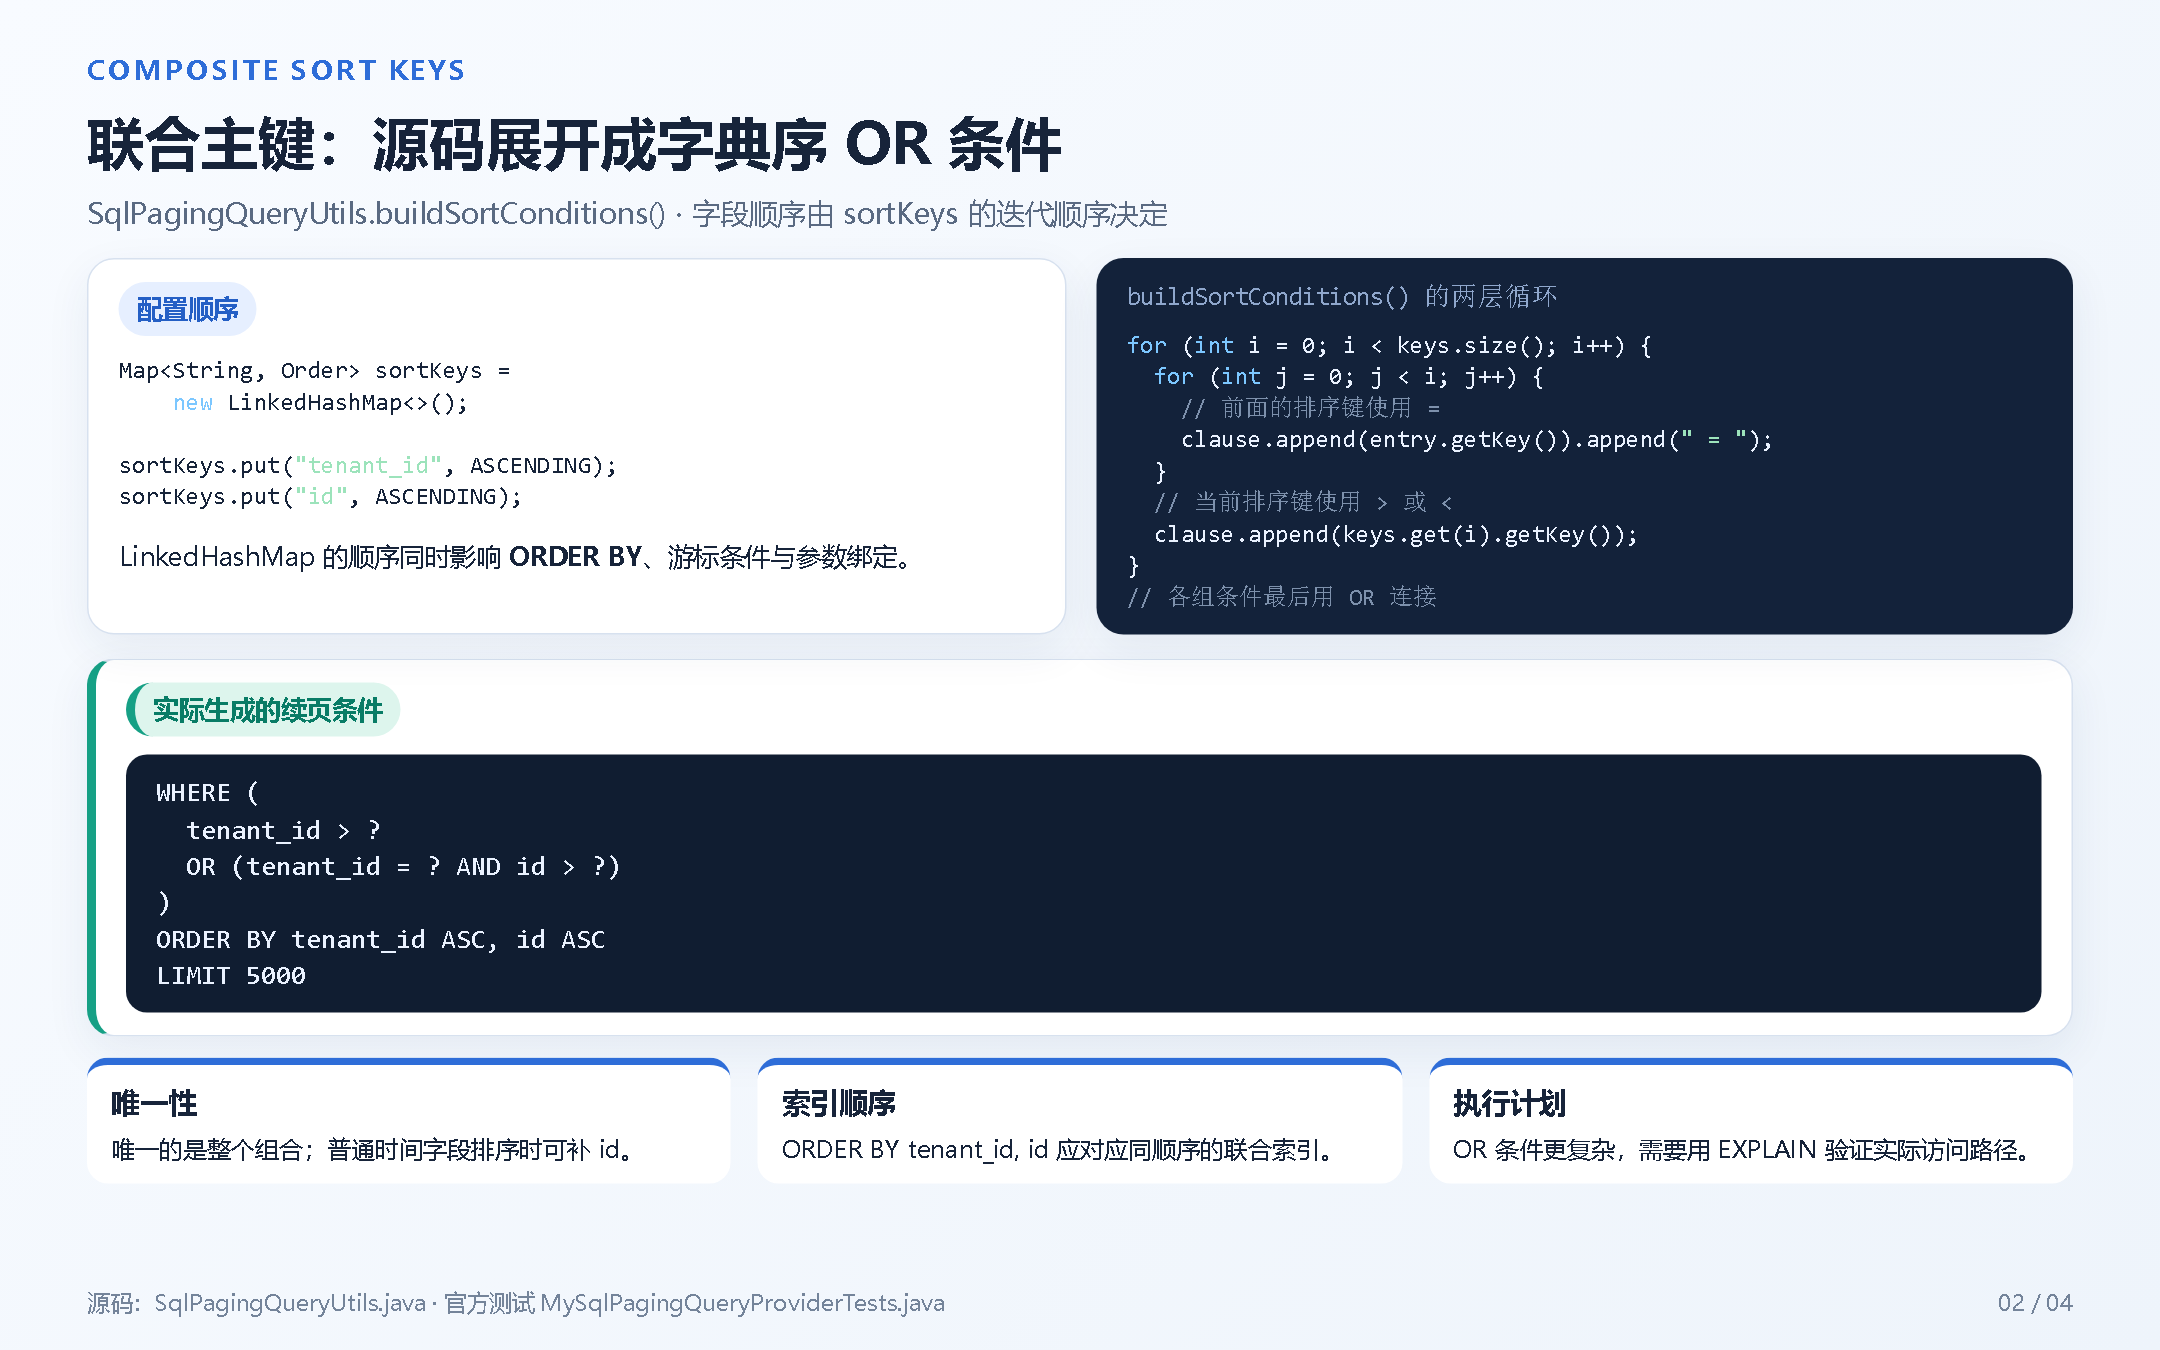
这就是字典序比较:先比较 tenant_id,相等时再比较 id。不能写成 tenant_id > ? AND id > ?,后者可能漏掉合法组合。
如果配置为 name ASC, id DESC,4.3.6 官方测试断言的后续页 SQL 是:
WHERE (bar = 1)
  AND ((name > ?) OR (name = ? AND id < ?))
ORDER BY name ASC, id DESC
LIMIT 100;
联合主键重启时,保存的也是一整组游标值,例如 {tenant_id=100, id=500000}。恢复逻辑与单主键相同,只是比较条件更多。
实践中要注意三点:
- 唯一性指整个排序键组合唯一。按
updated_at排序时,通常要补一个id,不能只依赖可能重复的updated_at。 ORDER BY tenant_id, id应与PRIMARY KEY(tenant_id, id)或对应联合索引的顺序一致。换成ORDER BY id, tenant_id,可能无法利用索引顺序。- 多字段
OR条件比单主键范围查询复杂,必须用EXPLAIN验证。没有深分页,不代表执行计划一定理想。
单线程断点续读:恢复到最后保存的 chunk,而不是异常现场
单线程场景下,saveState 默认是 true,Reader 会把两类状态写入 ExecutionContext。
第一类是 read.count。AbstractItemCountingItemStreamItemReader.read() 每读一条都会增加 currentItemCount,update() 再保存这个计数。
第二类是 start.after。JdbcPagingItemReader.update() 根据当前位置保存排序键:
if (isAtEndOfPage() && startAfterValues != null) {
    executionContext.put(getExecutionContextKey(START_AFTER_VALUE), startAfterValues);
}
else if (previousStartAfterValues != null) {
    executionContext.put(getExecutionContextKey(START_AFTER_VALUE), previousStartAfterValues);
}
假设 pageSize=100,最后保存的 read.count=250。Reader 已经加载第 201~300 行,但只消费到第 250 行,此时会保存上一页末尾,也就是第 200 行的 ID。
重启后发生三件事:
- 用
id > 第200行ID重新查询第 201~300 行。 jumpToItem(250)算出页内位置为 50。- 跳过当前页前 50 条,从第 251 条继续返回。
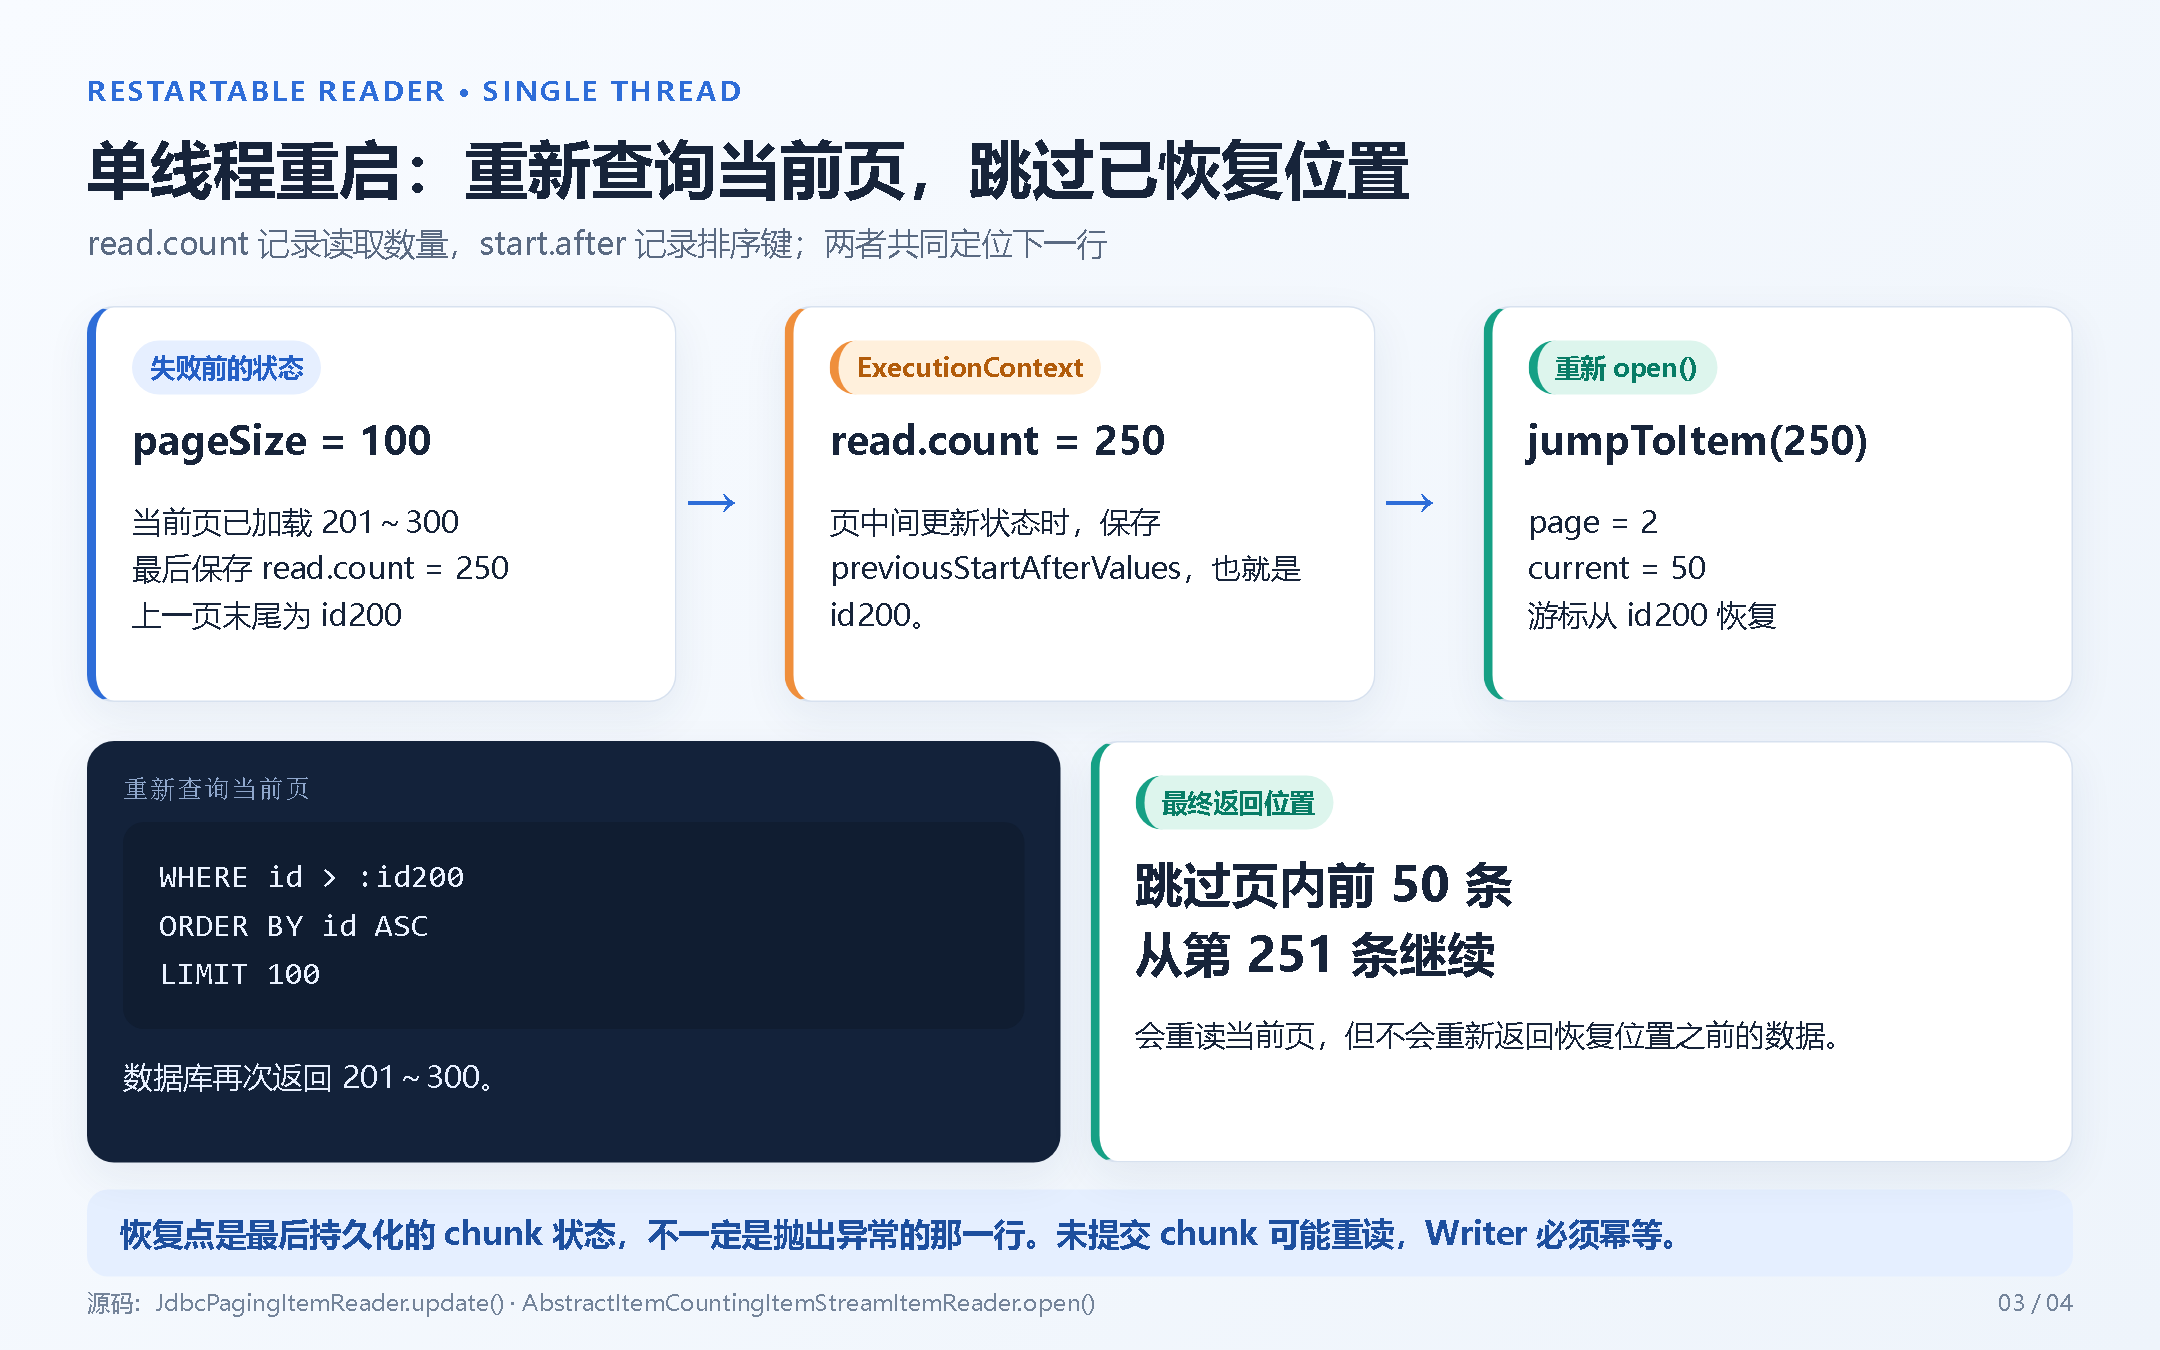
所以,准确说法是“从最后一次持久化的 Reader 状态恢复”。失败时尚未提交的 chunk 可能重新读取,数据库事务可以回滚,但 RPC、消息发送等外部副作用未必能回滚,Writer 仍应幂等。
还需要几个前提:使用持久化 JobRepository;Reader 的 name 固定且唯一;以相同 JobInstance 正常重启;Job 和 Step 允许重启。换了标识性 Job Parameters,通常就是另一个 JobInstance,不会接着旧位置读。
多线程共享 Reader:线程安全,不等于可以断点续读
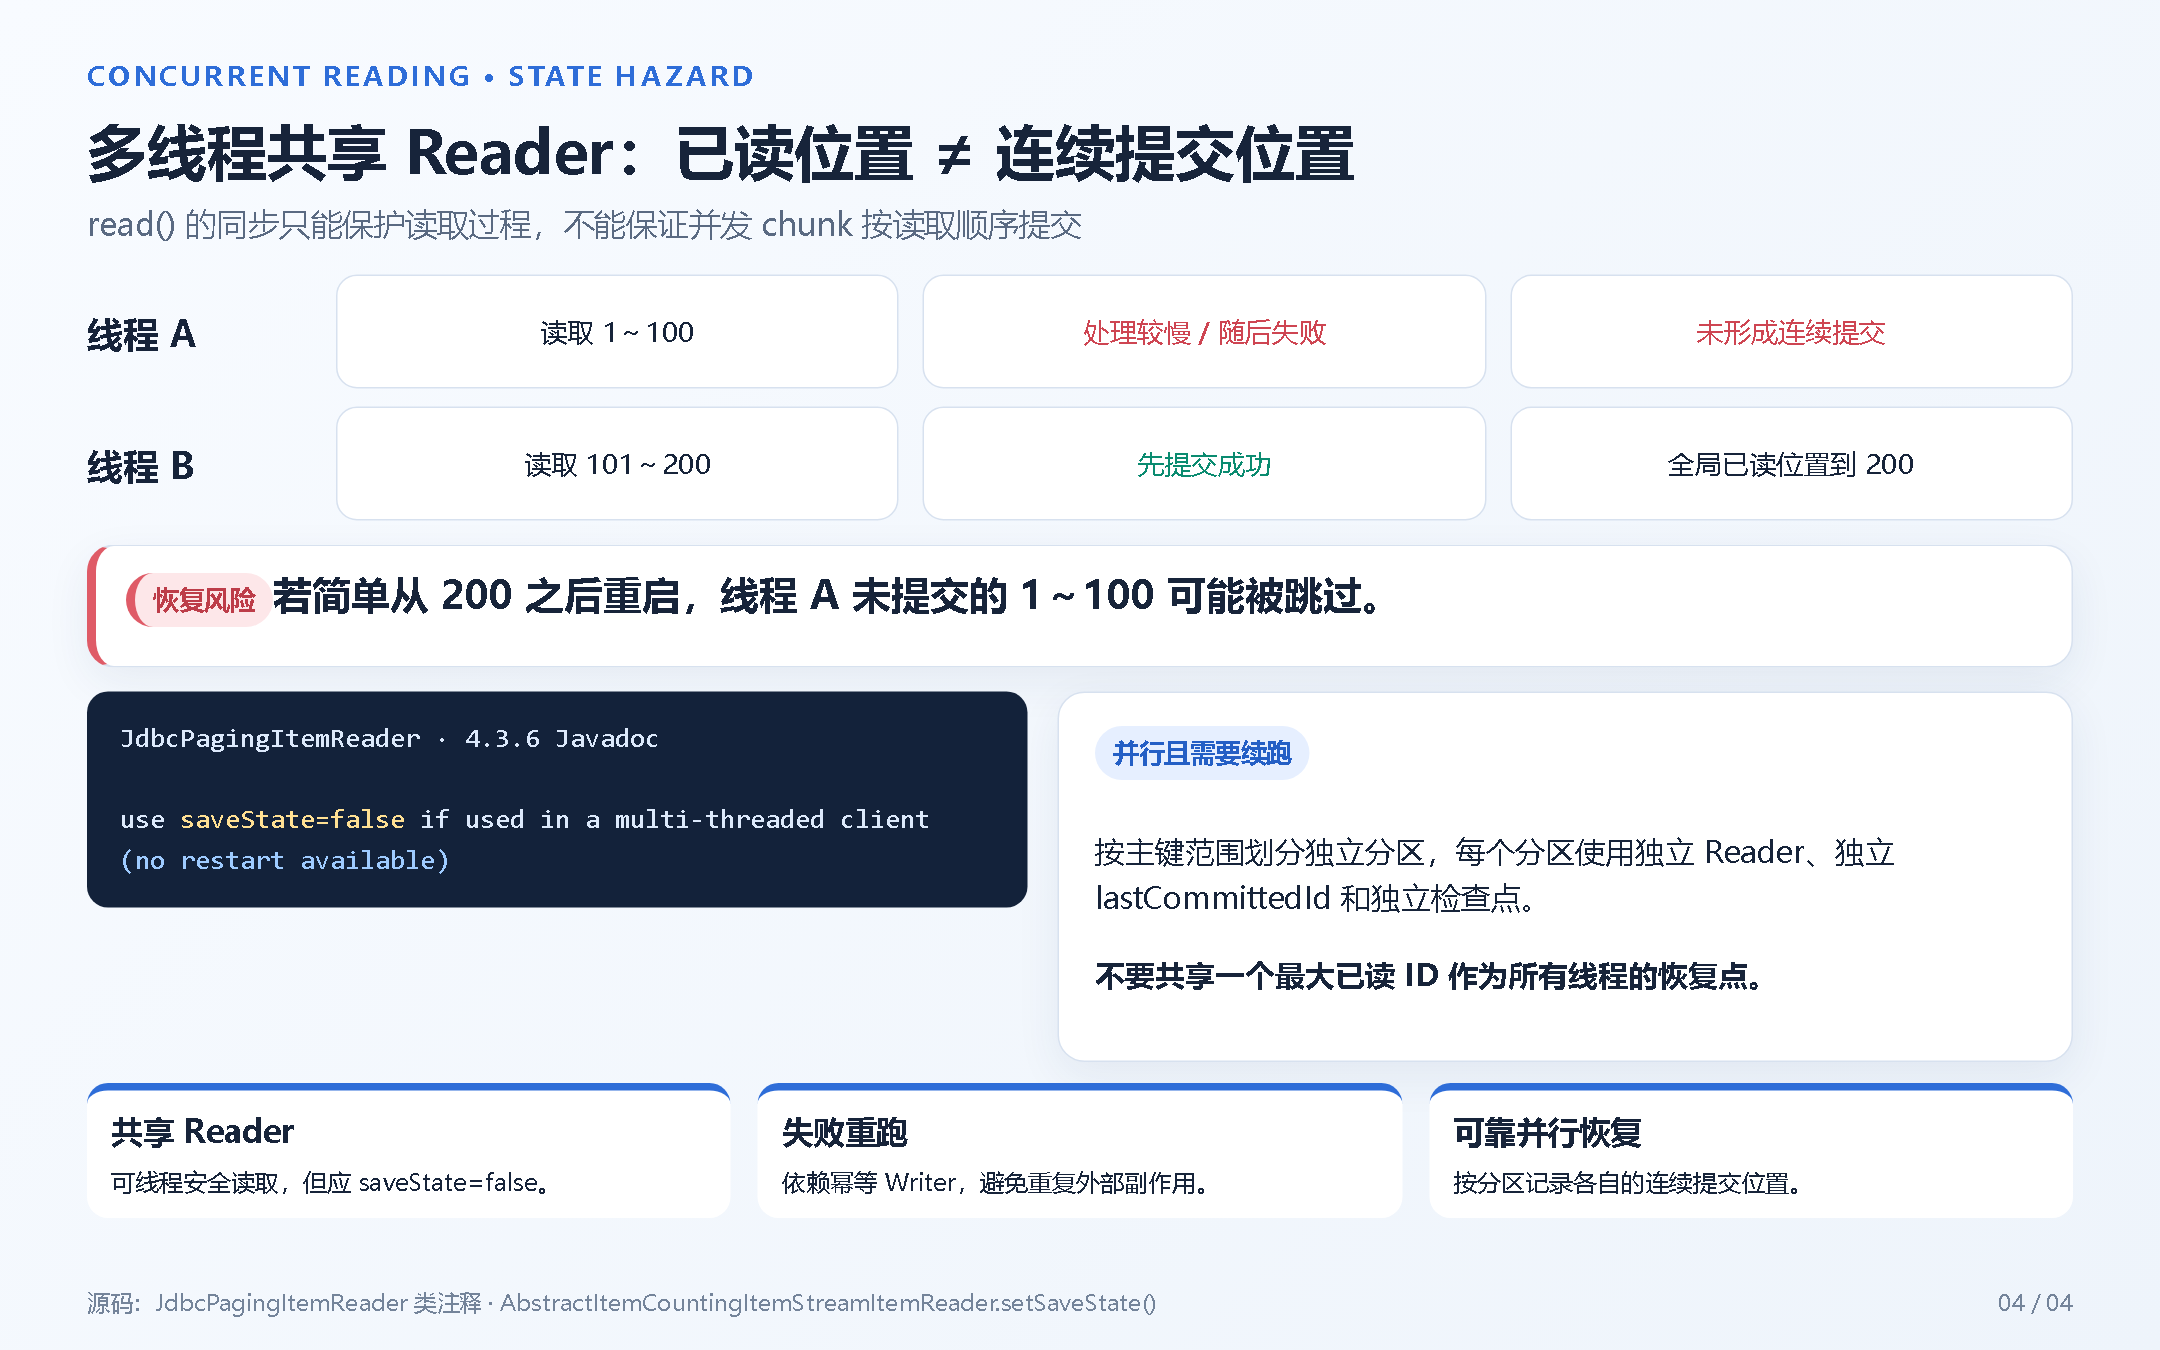
4.3.6 的类注释对此写得很直接:实现可以在多线程客户端中安全读取,但多线程时要设置 saveState=false,并明确标注 no restart available。
原因不在 read() 有没有加锁,而在 chunk 的提交顺序。
假设线程 A 读取 1~100,线程 B 读取 101~200。B 先提交,全局读取位置已经到 200;A 随后失败。如果重启时简单从 200 之后继续,A 对应的数据就可能被跳过。
这里有两个不同的位置:
- 已读位置:Reader 已经把数据分发到哪里。
- 连续提交位置:从起点开始,哪些数据已经完整、连续地提交成功。
并发时二者可能不一致。内置状态只记录全局读取进度,没有跟踪每个并发 chunk 的完成情况,也无法计算连续提交水位。
因此,多线程共享一个 Reader 时,合理配置是:
saveState(false)
这表示放弃 Reader 内置恢复状态。失败后重跑时必须通过幂等 Writer 防止重复副作用,不能把 saveState=true 当成并发断点续传开关。
如果既要并行又要续跑,可以按主键范围分区。每个分区使用独立 Reader、独立范围和独立游标,例如分别保存 partition_id、range_start、range_end、last_committed_id、status。重启时按各分区的连续提交位置恢复,而不是共享一个最大已读 ID。
WHERE 字段没有索引,LIMIT 也救不了扫描成本
看这条查询:
SELECT id, name, status
FROM big_table
WHERE status = :status
  AND id > :lastId
  AND id <= :maxId
ORDER BY id
LIMIT 5000;
id > :lastId 负责分页,status = :status 负责过滤。如果 status 没有合适索引,MySQL 可能沿主键扫描并逐行检查 status,直到凑够 5000 条。
LIMIT 5000 限制返回行数,不保证只扫描 5000 行。匹配记录稀疏时,一页可能扫描几十万行;后面没有匹配记录时,最后一条 SQL 可能扫完剩余范围。
普通 InnoDB SELECT 通常是一致性非锁定读,但仍会消耗 IO、CPU、Buffer Pool 和连接资源,也可能拖慢在线业务或只读副本的回放。
一次性全量回刷
更合适的路径是只读副本或一致快照,配合主键键集分页:
SELECT id, needed_col1, needed_col2
FROM big_table
WHERE id > :lastId
  AND id <= :maxId
ORDER BY id
LIMIT 5000;
任务开始时记录 maxId,每批短事务提交,只查必要字段,并根据慢查询、CPU、IO 和复制延迟限流。pageSize 可以从 1000~5000 开始压测,不要机械追求更大的批次。
如果要求严格的同一时点一致性,只记录 maxId 不够,因为旧行仍可能更新或删除,需要一致快照,必要时再叠加 CDC 补偿。
反复执行等值过滤
对于 status = ? 加单主键分页,可以评估 (status, id) 联合索引。对于同样的过滤加 (tenant_id, id) 排序,可以评估 (status, tenant_id, id)。
思路是等值过滤列在前,分页和排序列在后。是否需要覆盖索引,要结合 SELECT 字段、回表成本和写入放大判断。
亿级表加索引本身也会消耗磁盘、IO 和 CPU,并可能带来复制延迟。要确认当前 MySQL 版本和索引类型支持的 Online DDL 能力,在变更窗口执行并持续监控。
持续增量同步
如果目标是长期同步,通常更合理的是“首次全量快照,之后读取 binlog”,例如使用 Canal 或 Debezium。这样不必反复扫描大表寻找变化。
如果不能加索引,又必须按无索引字段过滤全表,就没有办法从根本上避免扫描。此时应把任务放到只读副本或离线环境,按 ID 范围分批并限流。上线前用 EXPLAIN 看访问路径,再通过慢查询日志中的 Rows_examined 验证真实扫描量。
落地时怎么选
- 单线程批处理:默认 MySQL Provider、唯一且非空的排序键、
saveState=true,按最后保存的 chunk 状态恢复。 - 联合主键:用
LinkedHashMap配置全部排序键,保证字段顺序与联合索引一致,并用EXPLAIN验证多字段条件。 - 多线程共享 Reader:设置
saveState=false,接受无法使用内置 Reader 状态续读的事实,Writer 必须幂等。 - 并行且需要续跑:按主键范围分区,每个分区独立 Reader、独立游标、独立检查点。
- 一次性无索引扫描:只读副本或快照、键集分页、短事务、限流。
- 高频条件查询:评估过滤字段与排序字段组成的联合索引。
- 长期增量同步:首次全量后使用 CDC。
JdbcPagingItemReader 负责把“一页一页向后读”做得稳定,并提供单线程恢复所需的游标状态。它不会替无索引过滤消除扫描,也不会自动把共享 Reader 的全局位置变成并发环境下的连续提交位置。把这几件事分开,方案就好选了。