1.46 万 Star 的 Aperant:给 Claude Code 套上 12 路并行的桌面军团,我把源码翻了个底朝天
AI 编程工具这一年卷得厉害,但大多数产品的形态高度趋同:一个对话框,你提需求、它改代码、你 review。真正在"并行"和"自主"上动刀子的不多。今天这个项目选择了一个很硬核的方向——让十几个 AI agent 同时在你的代码库里分头干活,还互不干扰、能自己测、自己合。
它叫 Aperant,前身是 Auto Claude,目前 1.46 万 Star、1890 Fork,主语言 TypeScript,AGPL-3.0 协议。我把仓库克隆下来,通读了 1146 个 TypeScript 文件、约 31.4 万行代码。这篇不讲营销话,回答三个我最好奇的问题:它怎么做到 12 个 agent 并行还不把代码库搞乱、“自主编码"到底有多少真东西、以及它现在这个特殊阶段还值不值得上手。
一、先定性:它不是新模型,是 Claude Code 的工程化军团
这是最需要先讲清楚的一点,避免你产生错误预期。
我在 src/main/agent/agent-process.ts 里看到,agent 的运行方式是通过 Node 的 child_process.spawn 拉起 Claude Code CLI 子进程,并用 CLAUDE_CONFIG_DIR、CLAUDE_CODE_OAUTH_TOKEN 等环境变量做 profile 隔离。Aperant 自己不训练、也不内置大模型,它做的是 Claude Code 之上的那一层工程化外壳:任务编排、环境隔离、状态管理、质量回路和自动合并。
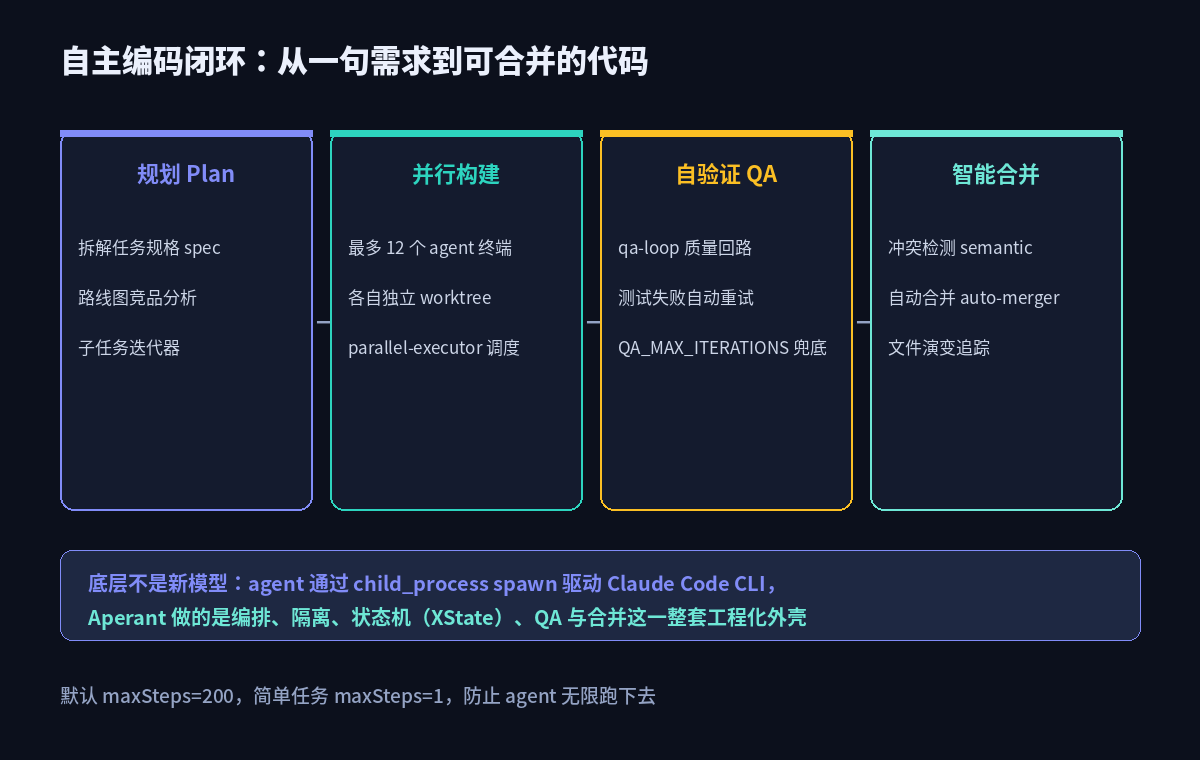
所以它的前置依赖写得很直白,三条缺一不可:Claude Pro/Max 订阅、本地安装 Claude Code CLI、一个已初始化 git 仓库的项目。想清楚这个定位很重要——它放大的是你已有的 Claude Code 生产力,而不是一个能脱离 Anthropic 独立运行的替代品。
二、自主编码闭环:从一句需求到可合并代码
把 src/main/ai/orchestration/ 目录展开,能看到一条完整的流水线。
规划阶段,spec-orchestrator 和 subtask-iterator 把你的自然语言需求拆成结构化的任务规格(spec)和可独立执行的子任务,还带路线图和竞品分析能力。
并行构建阶段,parallel-executor 负责调度多个 agent 同时开工。这里有两个我很认可的工程细节:一是 ai/client/factory.ts 里默认 maxSteps=200、简单任务 maxSteps=1,从规则上杜绝 agent 无限跑下去烧钱;二是每个 agent 的状态用 XState 状态机管理(仓库里有专门的 XSTATE_MIGRATION_SUMMARY),生命周期可控、可暂停恢复(pause-handler、recovery-manager)。
自验证阶段是它区别于"聊天式改代码"的核心。qa-loop.ts 构成质量回路:测试失败会自动驱动 agent 修正再跑,由 QA_MAX_ITERATIONS 兜底防止死循环,还能生成 QA 报告和人工测试计划。
合并阶段,ai/merge/ 下的 conflict-detector、semantic-analyzer、auto-merger、file-evolution、timeline-tracker 协同工作——注意它强调的是语义级冲突分析而非纯文本 diff,配合文件演变追踪,把多个 agent 的产出安全地并回主干。
三、并行不乱的根基:git worktree 隔离
12 个 agent 同时改一个代码库,最大的风险是互相覆盖。Aperant 的答案是 git worktree。
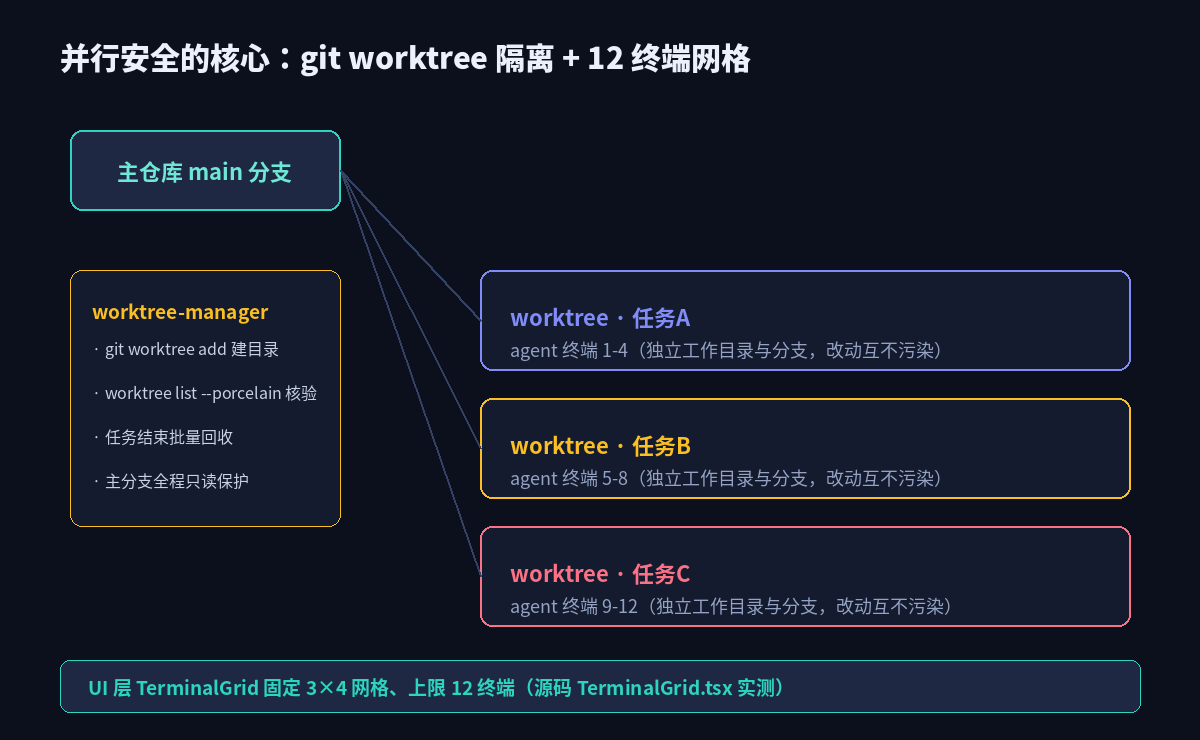
ai/worktree/worktree-manager.ts 负责为每个任务创建或复用独立的 git worktree——本质是给同一个仓库挂多个工作目录、每个绑定独立分支。我核对了实现,它用 git worktree add 建目录、git worktree list --porcelain 核验状态、任务结束批量回收,而主分支全程只读保护。这样任务 A 的改动天然被关在它自己的工作区里,碰不到任务 B,更碰不到 main。
UI 层的 TerminalGrid.tsx 则把这套能力可视化:固定 3×4 网格、上限 12 个终端,界面上直接显示 terminals.length / 12 terminals。这个"12"不是宣传数字,是源码里写死的网格布局和监听器配置(preload 层注释明确写了为 12 终端调大 max listeners)。
四、记忆层:用图数据库让 agent 跨会话记住项目
单次会话聪明不难,难的是跨会话的项目记忆。Aperant 在 ai/memory/ 下做了一套相对完整的体系。
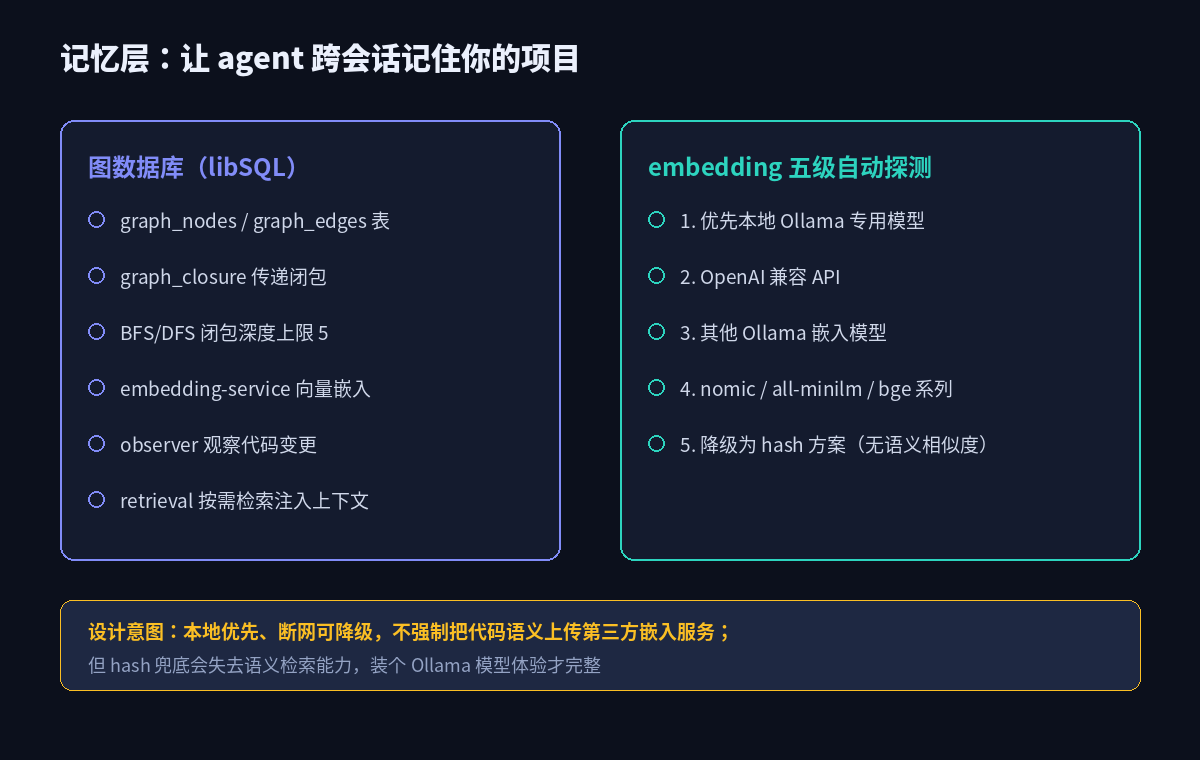
存储用的是 libSQL(SQLite 的开源分支)做图数据库,核心是 graph_nodes、graph_edges、graph_closure 三张表,其中闭包表用 BFS/DFS 预算节点的可达关系,且把传递闭包深度上限设为 5(MAX_CLOSURE_DEPTH)来控制性能。observer 监听代码变更更新图谱,retrieval 在 agent 运行时按需检索、把相关记忆注入上下文。
嵌入服务(embedding-service.ts)的设计体现了本地优先思路,是一套五级自动探测降级链:优先本地 Ollama 专用模型 → OpenAI 兼容 API → 其他 Ollama 模型 → nomic/all-minilm/bge 系列 → 最终降级为 hash 方案。要诚实指出最后一级的代价:hash 兜底没有语义相似度,只剩字面匹配,所以想拿到完整的记忆检索体验,本地装个 Ollama 嵌入模型几乎是必须的。
五、安全模型与当前阶段:必须讲清的边界
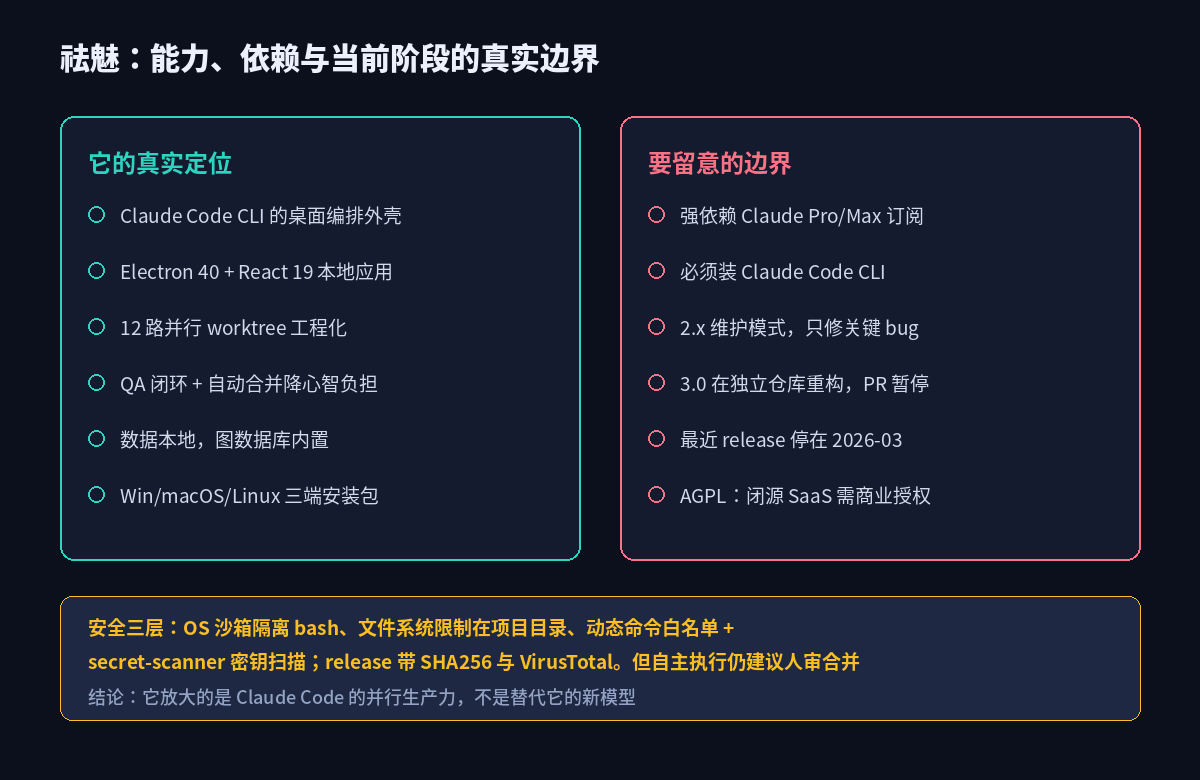
让 AI 自主跑 bash 命令是有风险的,Aperant 在 ai/security/ 下给了四层防线:OS 沙箱隔离 bash 执行、文件系统操作限制在项目目录内(path-containment)、基于项目技术栈动态生成的命令白名单(bash-validator + command-parser + denylist)、以及 secret-scanner 防止密钥泄露。发布物还带 SHA256 校验和 VirusTotal 扫描,macOS 做代码签名。但即便如此,自主执行的代码我仍建议人工 review 后再合并,工具能降低风险,不能消除风险。
更关键的是项目当前的生命周期,这点直接影响你要不要现在投入:
- 2.x 已进入维护模式。README 明确写着当前桌面应用稳定但只接受关键修复,稳定版停在 v2.7.6,最新 beta v2.8.0-beta.6 的发布时间是 2026 年 3 月,距今已数月没有新 release。
- 3.0 在独立仓库从零重构,方向是在本地桌面体验之上叠加云端能力,仍保持 AGPL-3.0 开源。官方解释"仓库看起来安静"是因为主力开发转移了,并非弃坑。
- PR 暂时关闭。由于代码库要推倒重来,针对当前 app 的代码 PR 无法合并、会被关闭,现阶段社区只能通过 issue、discussion 和 Discord 参与。
- 许可边界。AGPL-3.0 下自用、修改、内部部署都自由,但若想做成对外的闭源 SaaS 或网络服务,会触发开源义务,需要联系作者拿商业授权。
我的判断
Aperant 真正的价值,是把"AI 写代码"从单线程的对话升级成多线程的工程系统:worktree 解决并行安全、QA 回路解决质量、状态机解决可控性、图数据库解决跨会话记忆。对已经重度使用 Claude Code、又苦于多个任务只能排队手动切的开发者,这套编排能力确实能成倍放大产能。
但要理性看待两件事:其一,它始终是 Claude Code 的"军团指挥官"而非独立模型,护城河建立在 Anthropic 的能力和你的订阅之上;其二,它正处在 2.x 维护、3.0 重构的青黄不接期,现在适合尝鲜和评估,不建议在关键生产流程上 all-in,等 3.0 落地再做长期投入决策更稳妥。