1644 Star 的 PostBot 迭代到 v1.4.1:从单体扩展拆成 35 个模块包,我把新架构逐个文件点了名
两个月前,我写过一篇 PostBot 的源码实测,当时它还在 v1.1.20,是一个约 1.9 万行 TypeScript 的单体浏览器扩展,我重点拆解的是"不上传账号密码怎么实现一键分发"的隐私机制。
两个月后再看这个项目——PostBot 内容同步助手,Star 从 1376 涨到 1644,main 分支版本号来到 v1.4.1。这次最值得讲的已经不是"它能不能发",而是它的工程架构被彻底重构了:单体代码被拆成 35 个 @gitcoffee-os 作用域的独立包,新增了插件引擎、AI 适配层、独立发布引擎,还长出了 SDK、CLI 和国际版。
我把当前 main 分支重新克隆下来,逐个目录、逐个文件点了一遍名。这篇就专注讲清楚一件事:这两个月,它的架构是怎么从"一个扩展"演进成"一套平台"的。 隐私机制那部分旧稿讲透了,这里不再重复。
一、先看最直观的变化:依赖列表说明了一切
打开 v1.4.1 的 package.json,最显眼的是 35 个 @gitcoffee-os/* 开头的内部依赖。在 v1.1.20 时代,这些能力大多塞在同一个 src 目录里;现在它们被拆成了职责单一、可独立版本化的包。
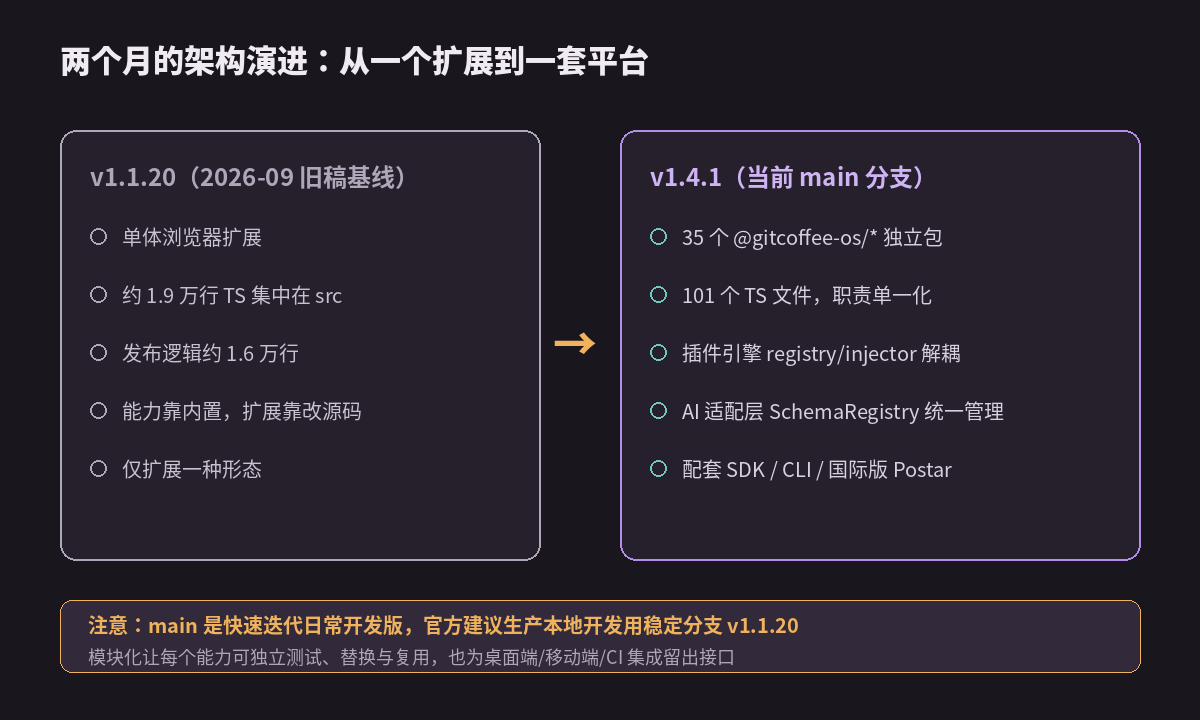
几个关键数字对比:
- 代码规模从集中式的约 1.9 万行,变成 101 个 TypeScript 文件、约 1.95 万行——总量没暴涨,但结构从"一坨"变成了"一格一格"。
- 后台脚本拆出
adapter.background.ts、cdp.background.ts、message.background.ts等独立入口。 - 插件能力独立成
postbot-plugin-engine,AI 能力独立成postbot-ai-adapter,发布能力独立成postbot-publish-engine和publisher-cn/it/industry/debug一组包。
需要先泼一盆冷水:README 顶部有明确警告,main 是"快速迭代日常开发版",官方建议本地开发和生产使用稳定分支 v1.1.20。想尝鲜新架构可以跟 main,要稳还是切稳定 tag。
二、35 个模块怎么分工:四层架构
把这 35 个包按职责归置一下,其实是一个很清晰的四层结构。
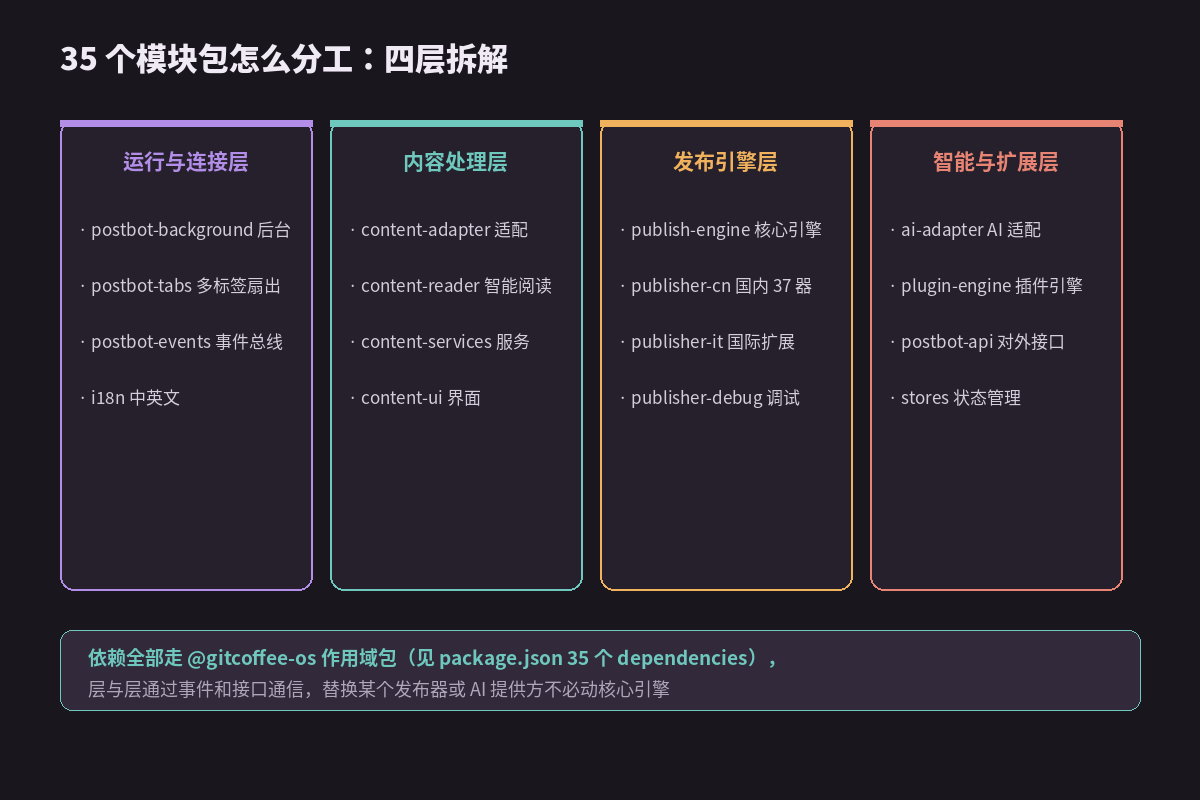
第一层,运行与连接层。 postbot-background 管扩展后台生命周期,postbot-tabs 负责多标签页扇出(这是它能同时往多个平台发的基础),postbot-events 做事件总线,外加 i18n 提供中英文。
第二层,内容处理层。 content-adapter 负责把内容适配成不同平台要的格式,content-reader 是那个"智能网页阅读器",content-services 和 content-ui 分别承接业务逻辑与界面。
第三层,发布引擎层。 publish-engine 是默认的核心同步引擎——README 特别强调它运行时完全不消耗 AI Token;publisher-cn 装国内发布器,publisher-it 留给国际扩展,publisher-debug 做调试。
第四层,智能与扩展层。 ai-adapter 统一管理 AI 能力,plugin-engine 提供插件注册与注入,postbot-api 对外暴露接口,stores 管状态。
这种分层的实际好处是:层与层通过事件和接口通信,你想替换某个发布器、或者换一个 AI 提供方,都不用动核心引擎。这正是它能从"扩展"走向"平台"的前提。
三、37 个发布器:按内容形态组织,而不是按平台堆按钮
我在 src/media/publisher/platform/ 目录里把所有 *.publisher.ts 文件数了一遍,一共 37 个发布器,按内容形态分成四类。
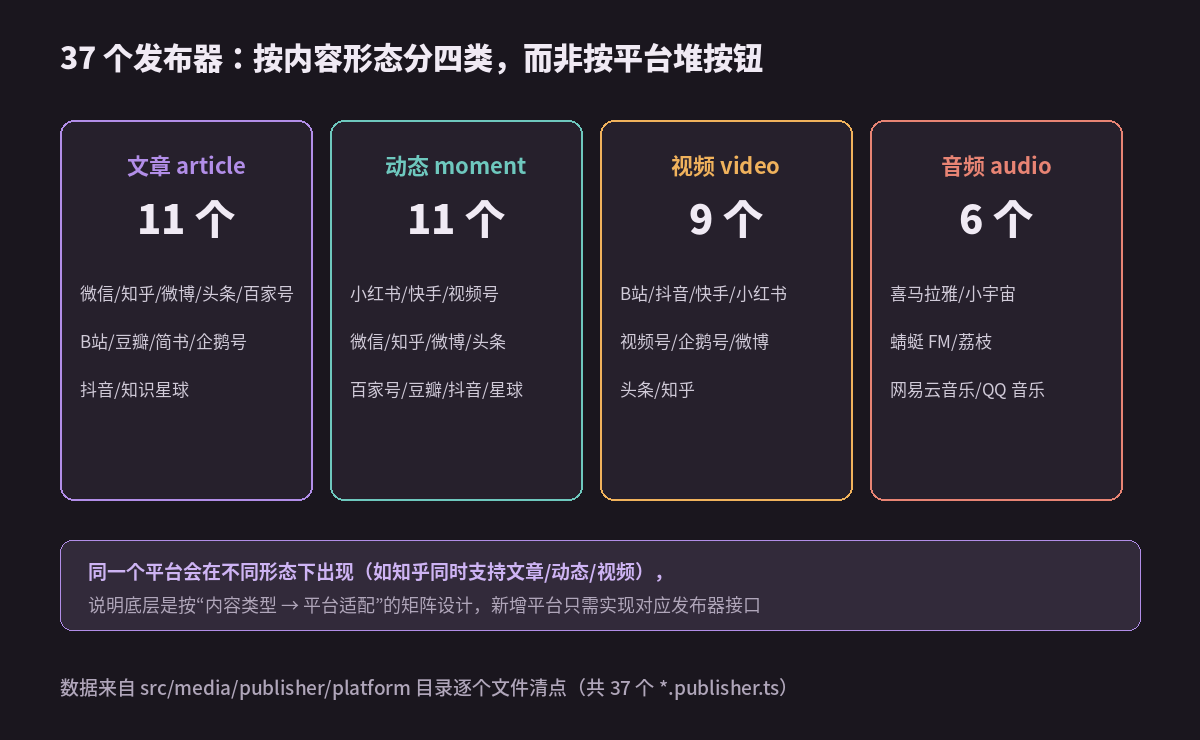
- 文章 article:11 个——微信、知乎、微博、头条、百家号、B站、豆瓣、简书、企鹅号、抖音、知识星球。
- 动态 moment:11 个——小红书、快手、视频号,加上微信、知乎、微博等。
- 视频 video:9 个——B站、抖音、快手、小红书、视频号等。
- 音频 audio:6 个——喜马拉雅、小宇宙、蜻蜓 FM、荔枝、网易云音乐、QQ 音乐。
注意一个设计细节:同一个平台会在不同形态下重复出现,比如知乎同时支持文章、动态、视频。这说明底层不是"一个平台一个按钮",而是"内容类型 → 平台适配"的矩阵。新增一个平台,只要实现对应内容形态的发布器接口即可,不必重构整体——这和模块化重构是同一套思路的延续。
四、插件引擎与 AI 适配层:这次真正的新增量
如果说模块化是"重新装修",那这两块是"新加的房间"。
插件引擎在 src/plugins/ 下能看到四个核心文件:registry.ts(注册中心)、injector.ts(依赖注入)、types.ts(类型定义)、debug.plugin.ts(调试插件示例)。它定义了 PluginBase、PublisherConfig、AIConfig 等一套契约,第三方可以按契约写插件,而不用改主程序源码——这正好解决了旧版"能力靠内置、扩展靠改源码"的问题。
AI 适配层的核心是 SchemaRegistry。我读了 src/ai-adapter/adapter.shared.ts,它用懒单例模式在 background、content、sidepanel 各上下文里维护注册中心,通过 chrome.storage 同步,还能用存量的 DebugConfig 建立 schema 基线(ensureBaselines,幂等不覆盖)。一句话概括:它把"接哪个 AI、参数长什么样"抽象成了可注册的 schema,而不是写死在代码里。
这也解释了 README 里那句"默认引擎零 Token、同时支持集成 Playwright、PageAgent、OpenClaw、Hermes Agent、DeepSeek Harness"——默认发布走纯 DOM 自动化不花钱,高级引擎通过适配层按需插拔。不过要诚实说明:我在主仓库 src 里没有检索到这些高级引擎的具体实现代码,它们是通过独立生态包/可选集成提供的,不属于这个仓库的核心交付。
五、祛魅:能力边界与许可红线
最后照例把边界讲透,这比优点更重要。
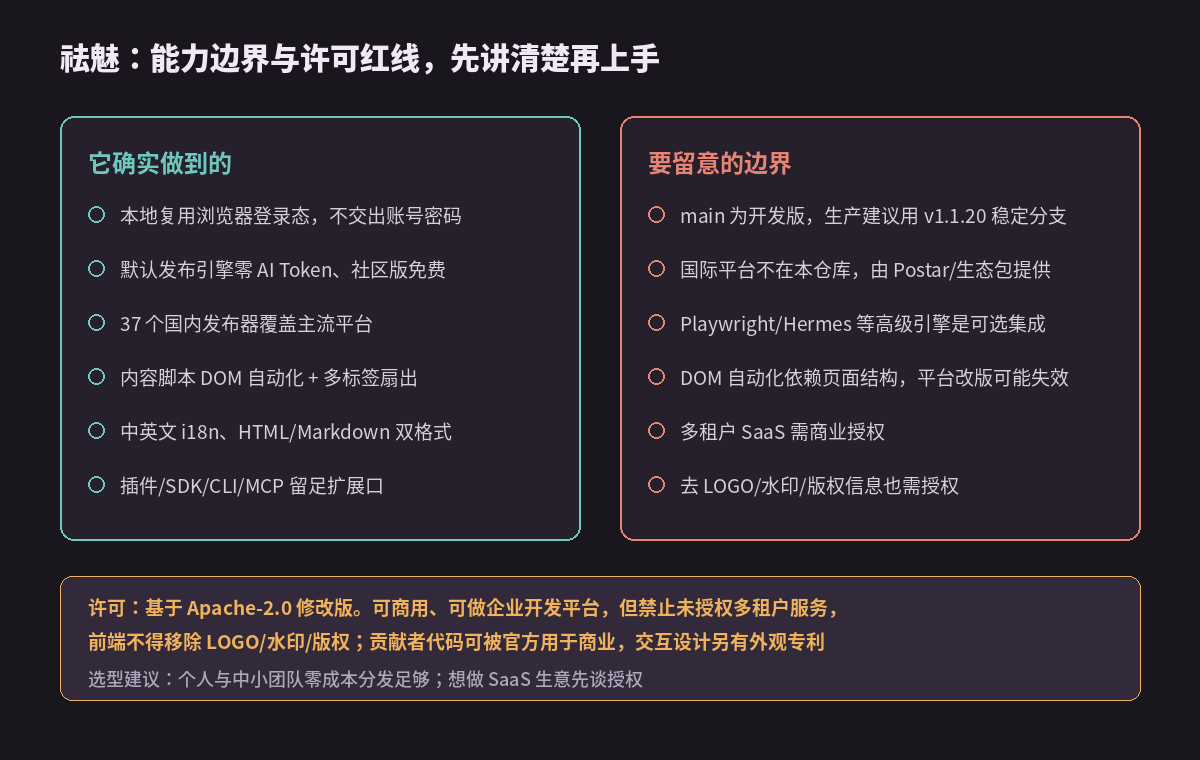
技术边界上:
- main 分支是开发版,生产请用 v1.1.20 稳定分支。
- 国际平台(X、Facebook、TikTok 等)不在这个仓库,由独立的国际版 Postar 和生态包承接。
- Playwright/Hermes 等高级自动化引擎是可选集成,不是开箱即用。
- 它本质仍是内容脚本 DOM 自动化,强依赖各平台页面结构,平台一旦改版,对应发布器可能失效,需要跟着维护。
许可红线尤其要看清。 它用的不是标准 Apache-2.0,而是 修改版 Apache-2.0,在原版基础上加了额外条件:
- 可以商用,也能做企业内部开发平台;但未经书面授权,不得用它的源码运营多租户(multi-tenant)服务——协议里把"一个租户"定义为"一个工作区 workspace"。
- 使用其前端时,不得移除或修改控制台里的 LOGO、水印、作者和版权信息(不涉及前端的使用不受此限)。
- 贡献者需同意:官方可以调整开源协议的松紧,且你的贡献代码可被用于包括云业务在内的商业用途。
- 产品的交互设计还受外观专利保护。
我的判断
PostBot 这两个月的演进,方向非常明确:从一个"能用的工具",长成一个"能被集成的平台"。 35 个模块包解决可维护性,插件引擎解决可扩展性,AI 适配层解决模型供应商的不确定性,再用 SDK/CLI 把能力延伸到浏览器之外。对个人自媒体和中小团队,它依然是零成本、不交出账号密码的分发利器;但如果你想基于它做对外的多租户 SaaS 生意,先把许可协议里的商业授权条款谈清楚。
它还在快速迭代,架构远没到定型的一天。但"模块化 + 插件化 + 适配层"这三步棋走下来,这个项目的天花板,已经和两个月前那个单体扩展不在一个量级了。