4.1万 Star、用 Zig 从零写的无头浏览器:Lightpanda 凭什么比 Chromium 省 16 倍内存
做网页自动化的人,大概率都被 Headless Chrome 的内存账单折磨过:一个实例轻轻松松吃掉一两 GB,并发开到几十个,服务器内存先扛不住。主流方案要么是 Chromium 套壳,要么是 WebKit 改造,内核几十年的历史包袱都在。
今天这个项目选择了一条少有人走的路:不 fork Chromium、不 patch WebKit,用 Zig 语言从零写一个专门跑在服务端的无头浏览器。它叫 Lightpanda,目前 4.16 万 Star、2070 Fork、累计 1.19 万次提交,主语言 Zig,采用 AGPL-3.0 协议,仓库昨天还在更新。
我把仓库克隆下来、通读了 README 和官方基准仓库,这篇讲清楚它到底做成了什么、性能数据怎么来的、适合谁用,以及它眼下的真实边界。
一、先看最有冲击力的一组基准
Lightpanda 最常被引用的口号是"比 Chromium 轻 16 倍、快 9 倍"。这种数字不能只看营销页,得看测试协议。官方在 demo 仓库的 BENCHMARKS.md 里把方法、机器、对照版本全部公开了。
测试环境是一台 AWS EC2 m5.xlarge、全新 Ubuntu,对照浏览器是 Google Chrome 143,用 Go 写的 chromedp 爬虫抓取一个 demo 站点的 933 个真实 URL,内存用 smem 统计 PSS、CPU 用 ps 每 100ms 采样取峰值。
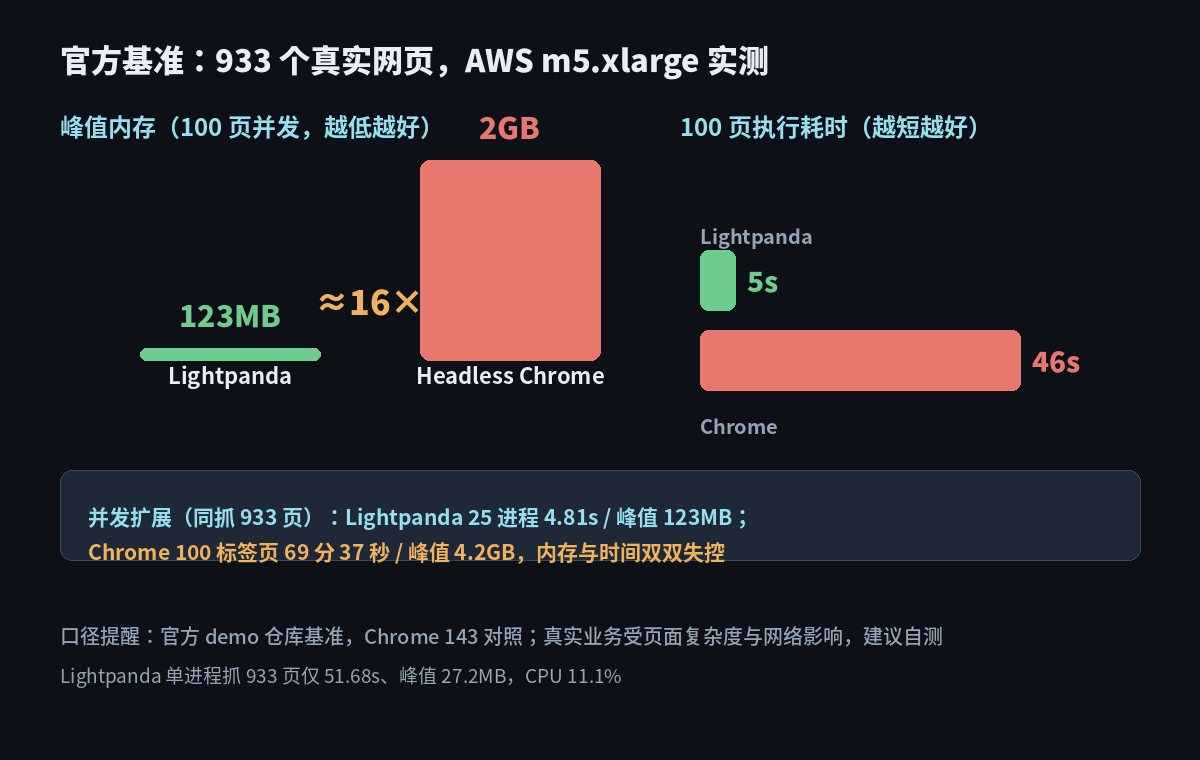
几个关键数据:
- 100 页并发:Lightpanda 峰值内存 123MB、耗时 5 秒;Headless Chrome 峰值 2GB、耗时 46 秒。
- 单进程抓完 933 页:Lightpanda 用时 51.68 秒、峰值内存仅 27.2MB、CPU 11.1%;Chrome 单标签用时 82.83 秒、峰值 1.3GB。
- 极限并发对照:Lightpanda 开 25 进程抓完 933 页只要 4.81 秒、峰值 123MB;而 Chrome 开 100 标签页跑同一任务,用时飙到 69 分 37 秒、峰值 4.2GB。
差距的根源不在某个优化技巧,而在架构取舍——这正是下一节要讲的。需要提醒的是,基准来自官方自建 demo 站,真实业务受页面复杂度、网络和 JS 框架影响,落地前务必用自己的页面回归测试。
二、为什么要从零造一个浏览器
README 的 “Why Lightpanda” 一节给出了完整论证,核心是两个判断。
第一,现代网页的 JavaScript 执行是刚需,简单 HTTP 请求不够用了。 今天的网站大量依赖 Ajax、单页应用、无限滚动、即时搜索,React/Vue/Angular 框架渲染的内容,不执行 JS 根本拿不到。所以 requests + BeautifulSoup 那一套在很多场景已经失效。
第二,把完整桌面浏览器搬上服务器,规模化时极不经济。 Chrome 为了兼顾普通人上网,带了图形渲染、多媒体、扩展、多进程隔离等一大堆无头场景用不上的东西,实例一多,内存和 CPU 成本就失控,部署维护也重。
Lightpanda 的选择是:既要真实的 JS 执行能力,又要服务端的极致轻量,那就只能推倒重来。
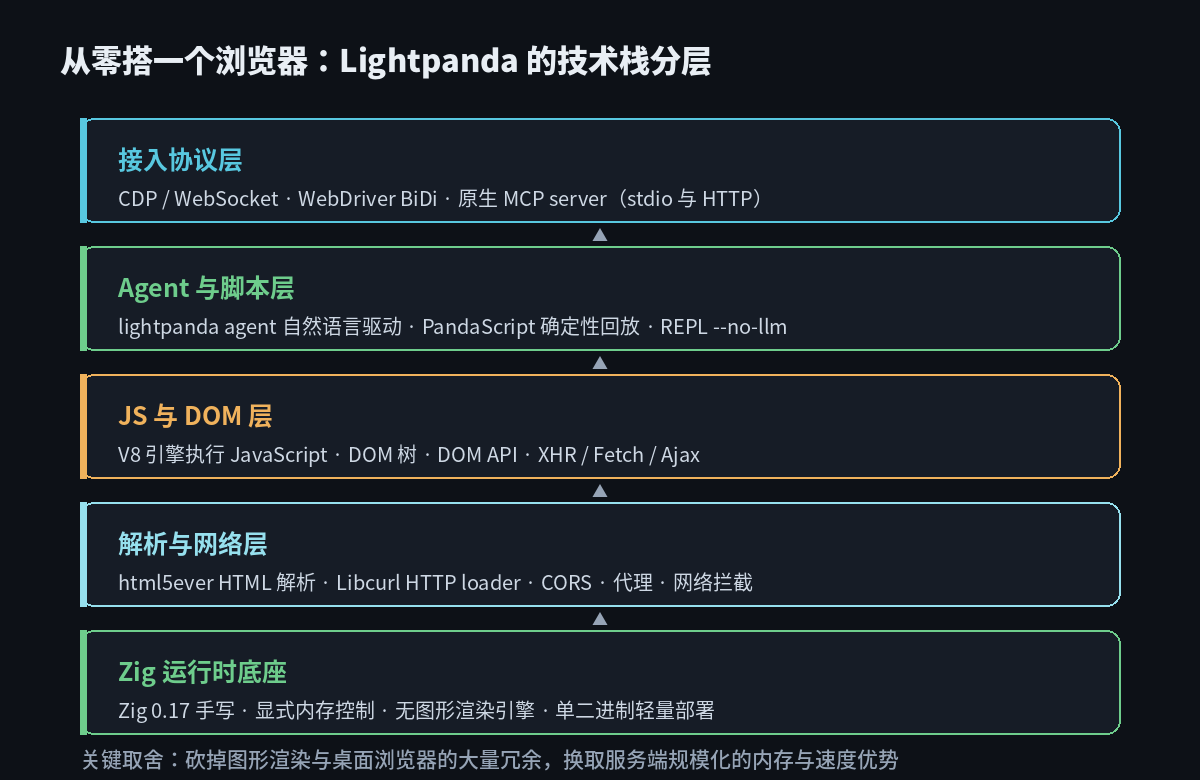
它的技术栈分层很清晰:
- Zig 运行时底座:用 Zig 0.17 手写,显式内存控制,编译成单个二进制,而且没有图形渲染引擎——这是它省内存的关键,无头自动化本来就不需要画像素。
- 解析与网络层:HTML 解析用 Servo 项目的 html5ever,HTTP 加载用 Libcurl,支持 CORS、代理、网络拦截。
- JS 与 DOM 层:集成 Google 的 V8 引擎真正执行 JavaScript,实现 DOM 树、DOM API、XHR、Fetch、Ajax。
- Agent 与脚本层:内置
agent自然语言驱动和 PandaScript 确定性脚本。 - 接入协议层:提供 CDP/WebSocket、WebDriver BiDi,以及原生 MCP server。
换句话说,它不是"简化版 Chrome",而是一个针对自动化场景重新选型、重新组装的浏览器。
三、四种用法,覆盖从命令行到多 Agent
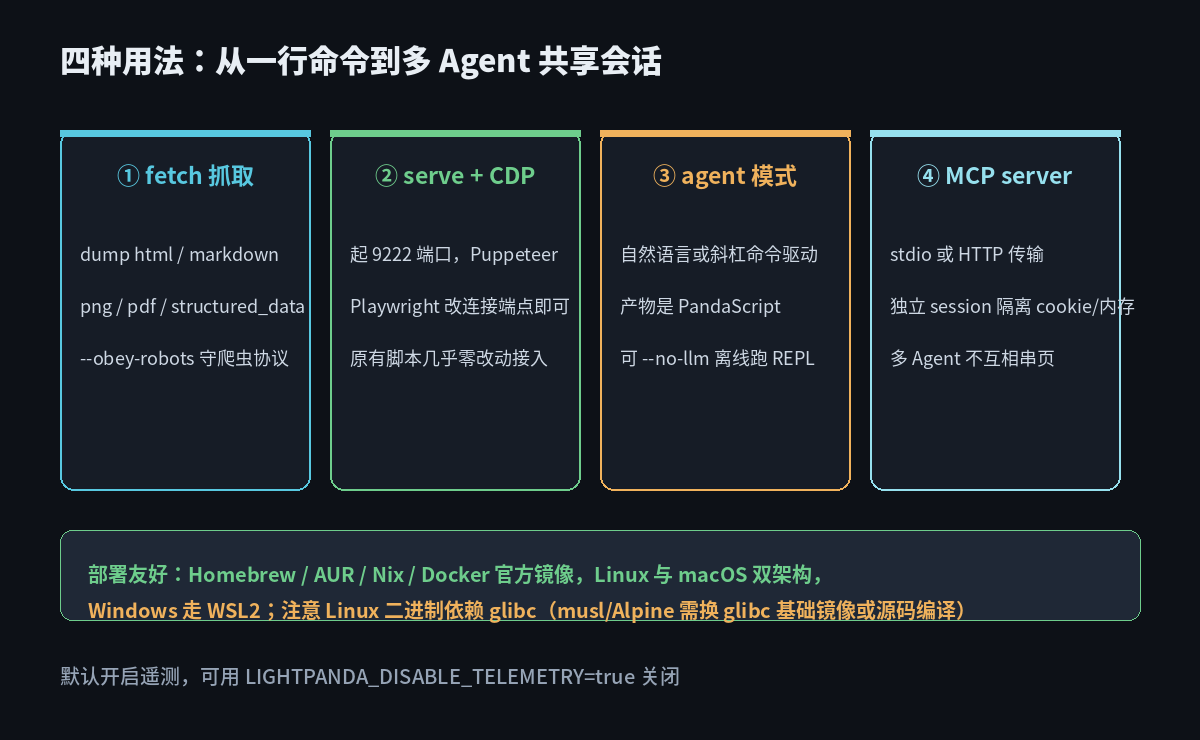
① fetch:一行命令抓取。 不需要起服务,直接 dump 页面,支持 html、markdown、png、pdf、structured_data(JSON-LD/OpenGraph/meta)多种输出,还能用 --obey-robots 遵守 robots 协议:
./lightpanda fetch --obey-robots --dump html \
  https://demo-browser.lightpanda.io/campfire-commerce/
② serve + CDP:无缝接入现有 Puppeteer/Playwright。 起一个 CDP 服务后,把连接端点指向 Lightpanda,原有自动化脚本几乎不用改:
./lightpanda serve --host 127.0.0.1 --port 9222
import puppeteer from 'puppeteer-core';
const browser = await puppeteer.connect({
  browserWSEndpoint: "ws://127.0.0.1:9222",
});
// 后面的 createBrowserContext/newPage/evaluate 写法完全不变
③ agent 模式:让浏览器听懂自然语言。 lightpanda agent 内置原生智能体,用大白话或斜杠命令描述任务,它就能导航、点击、填表、抽数据。最妙的是它的产物是 PandaScript——一段原生 JS 加少量浏览器原语,可以用 lightpanda run 离线、确定性、不耗 token 地回放。也就是说,用 LLM 做原型,用脚本上生产。它支持 Anthropic、OpenAI、Gemini、OpenRouter、Vercel AI Gateway、Ollama 等一大串提供商,也能 --no-llm 进纯 REPL。
④ 原生 MCP server:给多 Agent 当共享浏览器。 通过 stdio 或 HTTP 暴露 MCP 协议,每个连接分配独立的 browsing session(独立页面、cookie、内存),多个 Agent 各用各的会话不会互相串页,也可以用同一个 Mcp-Session-Id 共享上下文协作。
部署也对运维友好:Homebrew、AUR、Nix、官方 Docker 镜像都有,Linux/macOS 双架构,Windows 走 WSL2。
四、祛魅:它很强,但还不是 Chrome 替代品
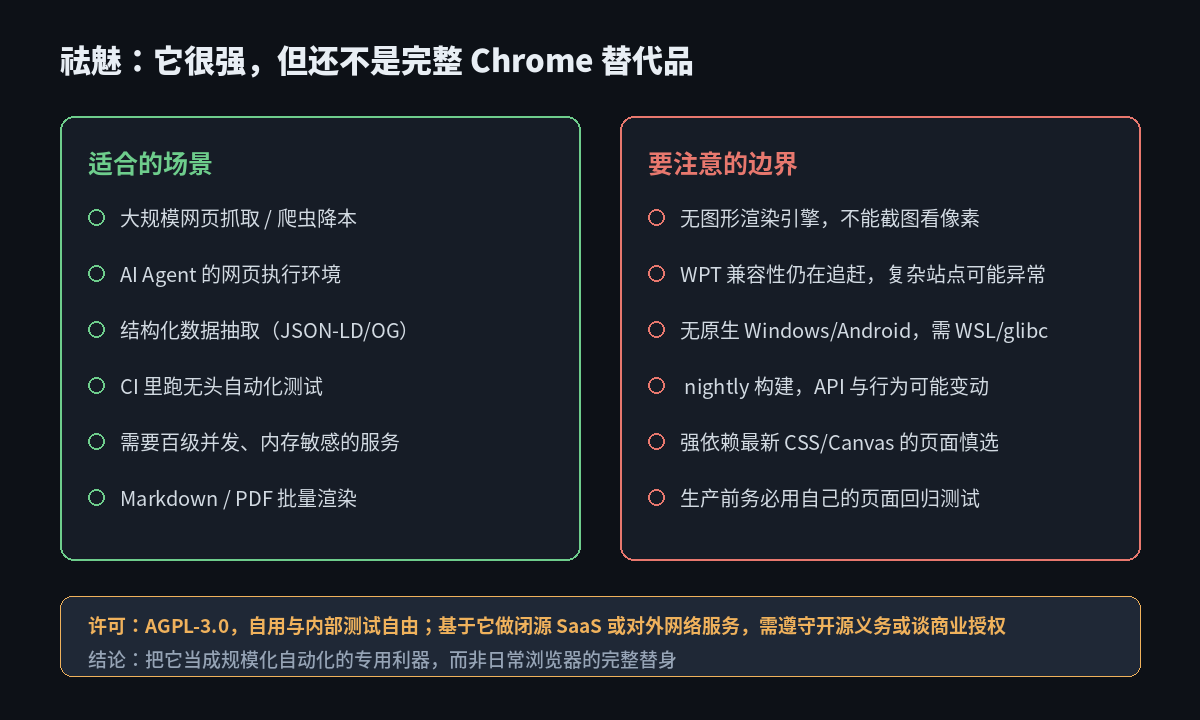
把话说全,是对读者负责。Lightpanda 当前有几个明确边界:
- 没有图形渲染引擎。它能输出 png/pdf,但本质是文本化渲染,不适合做像素级视觉回归、截图比对这类任务。
- WPT 兼容性仍在追赶。它每天跑标准化的 Web Platform Tests 并公开结果,但离完整浏览器的兼容度还有距离,强依赖最新 CSS、Canvas、复杂 Web API 的页面可能表现异常。
- 只提供 nightly 构建。API 和行为都可能变动,官方也在 README 里承认"not yet fully compliant"。
- 平台与 libc 限制。没有原生 Windows/Android 包;Linux 二进制依赖 glibc,Alpine 这类 musl 系统会报
cannot execute: required file not found,需换 glibc 基础镜像或源码编译。 - 默认开启遥测,介意的话用环境变量
LIGHTPANDA_DISABLE_TELEMETRY=true关闭。
许可方面要特别注意:项目是 AGPL-3.0。自己用、内部测试、学习都没问题;但如果你想基于它做对外提供网络服务的闭源 SaaS,AGPL 的网络分发条款会触发开源义务,这种场景需要评估合规或联系作者谈商业授权。
五、我的判断
Lightpanda 真正打中的,是 AI 时代一个越来越痛的点:当 Agent 需要大规模、低成本地操作网页时,为人类上网设计的 Chrome 太重了。 用 Zig 从零写、砍掉图形层、原生支持 CDP 和 MCP、还能把 LLM 操作沉淀成可离线回放的脚本,这套组合拳让它在爬虫降本、AI Agent 执行环境、结构化数据抽取、CI 无头测试这些场景里有明确的性价比优势。
但它不是要取代你日常用的浏览器。把它定位成"规模化自动化的专用利器",而不是"完整 Chrome 替身",预期就不会错。如果你正在为无头浏览器的内存账单发愁,值得拉下来用自己的页面跑一轮基准——毕竟它连测试方法都公开了,好不好用,你自己的服务器最有发言权。