4800 Star 的开源 AI 影视工厂:剧本到成片全自动,我拆了它的 10 万行 TypeScript
AI 视频工具现在分两类:一类是给你一个对话框、输入提示词吐一条 5 秒片段的"玩具";另一类是冲着批量生产去的生产线——你给剧本,它负责把剧本变成分镜、定住角色长相、配好场景、调度十几个模型任务,最后拼成能看的成片。
今天拆的 moyin-creator(魔因漫创)属于后者。4,826 Star、966 Fork,AGPL-3.0 双许可,TypeScript 写的 Electron 桌面应用,代码约 10.7 万行,主打一句话:剧本到成片全流程批量化,深度集成字节的 Seedance 2.0 视频模型。
我把仓库克隆下来通读了核心引擎和更新日志,这篇讲清楚它怎么把"拍剧"这件事流水线化、工程上有哪些真东西,以及几个不能忽略的边界。
一、它在解决什么:AI 视频生产的三个老大难
用单条提示词做视频的人都知道三个痛点:角色不一致(同一个人下一个镜头换了张脸)、流程断裂(剧本、分镜、生图、生视频散在五六个工具里手工搬运)、无法批量(一条片子几十上百个镜头,手工点到死)。
魔因漫创的产品结构就是对着这三个问题设计的,五大板块环环相扣,上一步的产出自动流入下一步:
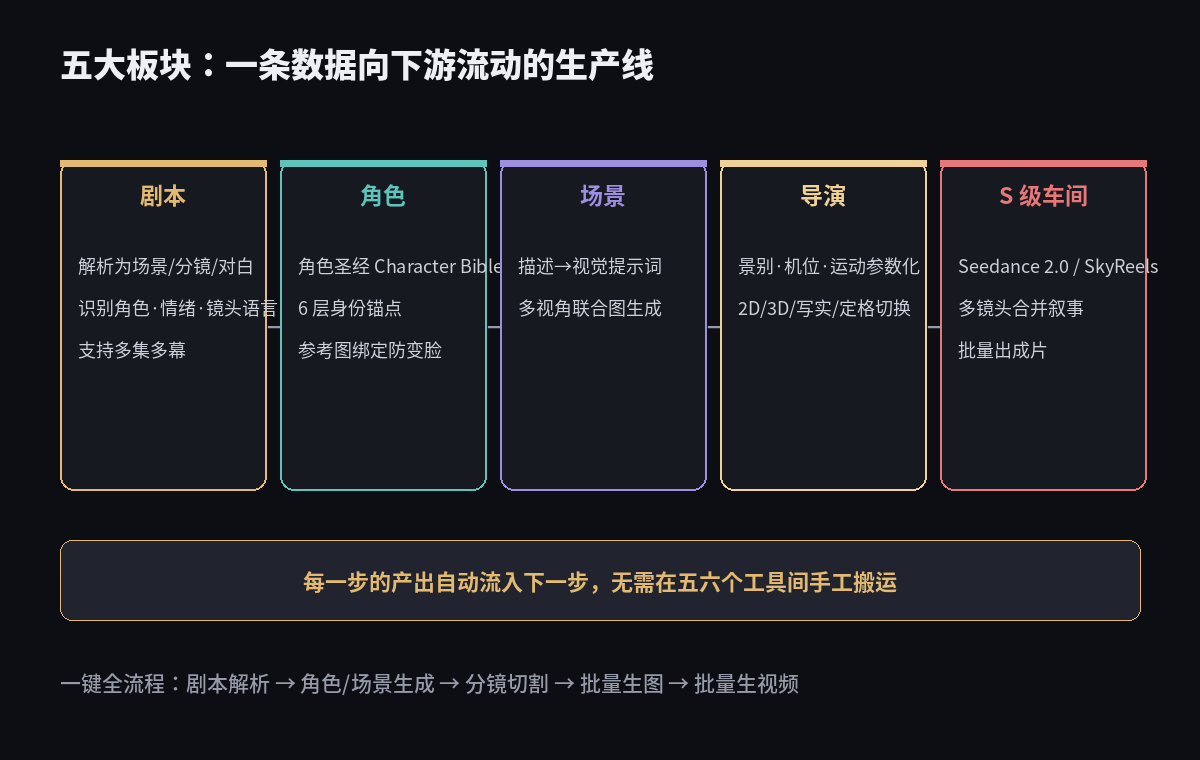
- 📝 剧本:粘贴剧本文本,解析引擎自动拆成场景、分镜、对白,识别角色、场景、情绪、镜头语言,支持多集/多幕结构;
- 🎭 角色:建立角色圣经(Character Bible),用 6 层身份锚点保证同一个角色跨分镜外观一致,并绑定参考图;
- 🌄 场景:场景描述自动转视觉提示词,生成多视角联合图;
- 🎬 导演:专业分镜系统,景别、机位、运动方式这些电影摄影参数化,2D/3D/写实/定格等视觉风格一键切换;
- ⭐ S 级板块:最终的视频生成车间,对接 Seedance 2.0 / SkyReels-V4,把分镜批量变成视频。
它不是自己训练视频模型,而是站在各家生成 API 之上做编排和品控——这个定位决定了它的价值和局限,后面细说。
二、最硬核的部分:S 级板块怎么喂饱 Seedance 2.0
Seedance 2.0 这类多模态视频模型的能力很强,但 API 约束也很具体:一次请求最多 9 张图、3 段视频、3 段音频,prompt 不超过 5000 字符。手工给每个分镜凑这些素材、卡这些限制,是纯体力活。魔因漫创把这层自动化了,核心是一个叫 GroupRefManager 的引用管理器。
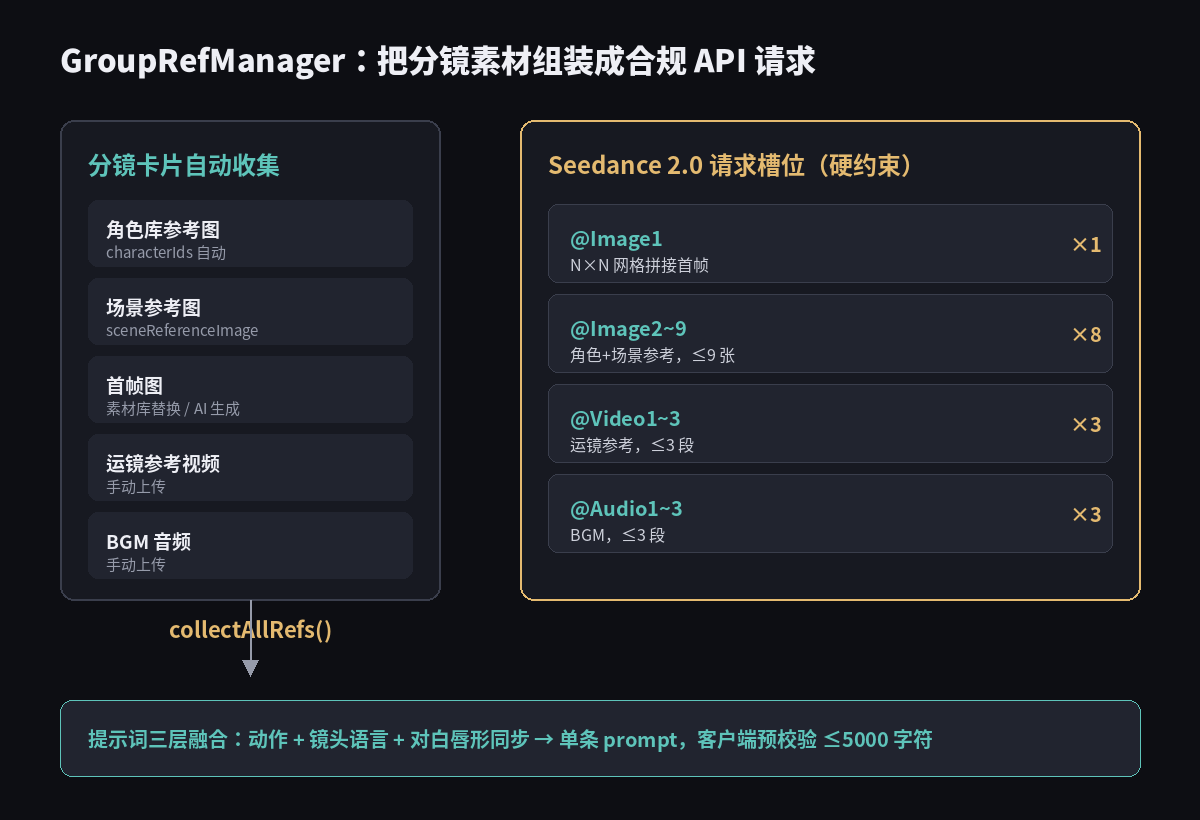
每个分镜卡片(split-scene-card)会自动收集三类素材:角色库里的角色参考图、场景参考图、首帧图(来自素材库或 AI 生成),统一交给 GroupRefManager;运镜参考视频和 BGM 音频则手动上传。collectAllRefs() 在发请求前完成组装和约束校验:
- @Image1~9:首帧图走 N×N 网格拼接策略(多角色/场景参考拼成格子图),其余槽位放角色和场景参考,硬上限 9 张;
- @Video1
3 / @Audio13:运镜与配乐参考,各 3 个上限; - 提示词三层自动融合:动作描述 + 镜头语言 + 对白唇形同步,编译成一条完整 prompt,并在 5000 字符红线内截断校验;
- 多镜头合并叙事:把多个分镜分组合并生成一条连贯叙事视频,而不是每条片段各自为政。
参数超限不是报错让你自己猜,而是在客户端先做约束自动校验。这套"引用收集 → 网格拼接 → prompt 编译 → 约束校验 → API 请求"的链路,是整个项目工程密度最高的地方,也解释了它为什么敢叫"生产级"。
三、角色一致性:6 层身份锚点 + 角色圣经
AI 短剧最大的穿帮就是"变脸"。它的解法分两层:
数据层是角色圣经(character-bible 服务):每个角色有一份结构化档案,外貌特征、服装、性格、关系等信息被固化,后续所有分镜引用同一份档案而不是每次重新描述。
生成层是 6 层身份锚点:通过角色参考图绑定 + 多模态引用(@Image 槽位强制带上角色图)+ 首帧网格拼接,让模型在每个镜头都能"看到"角色长什么样。v0.1.3 的更新日志专门提到,分镜卡片现在会自动把角色参考图、场景参考、首帧统一打包进 GroupRefManager,目的就是提升跨镜头一致性。
客观说,这不是什么独门黑科技——本质是"强参考图约束 + 结构化角色档案"的组合拳,效果仍取决于底层模型的参考跟随能力。但它把这套方法论产品化成了默认行为,不用用户每次自己记得贴图,这是工具的价值。
四、批量生产:队列、重试与多 Key 轮询
要做番剧级别的体量,单条生成毫无意义。它的批量化靠三个机制:
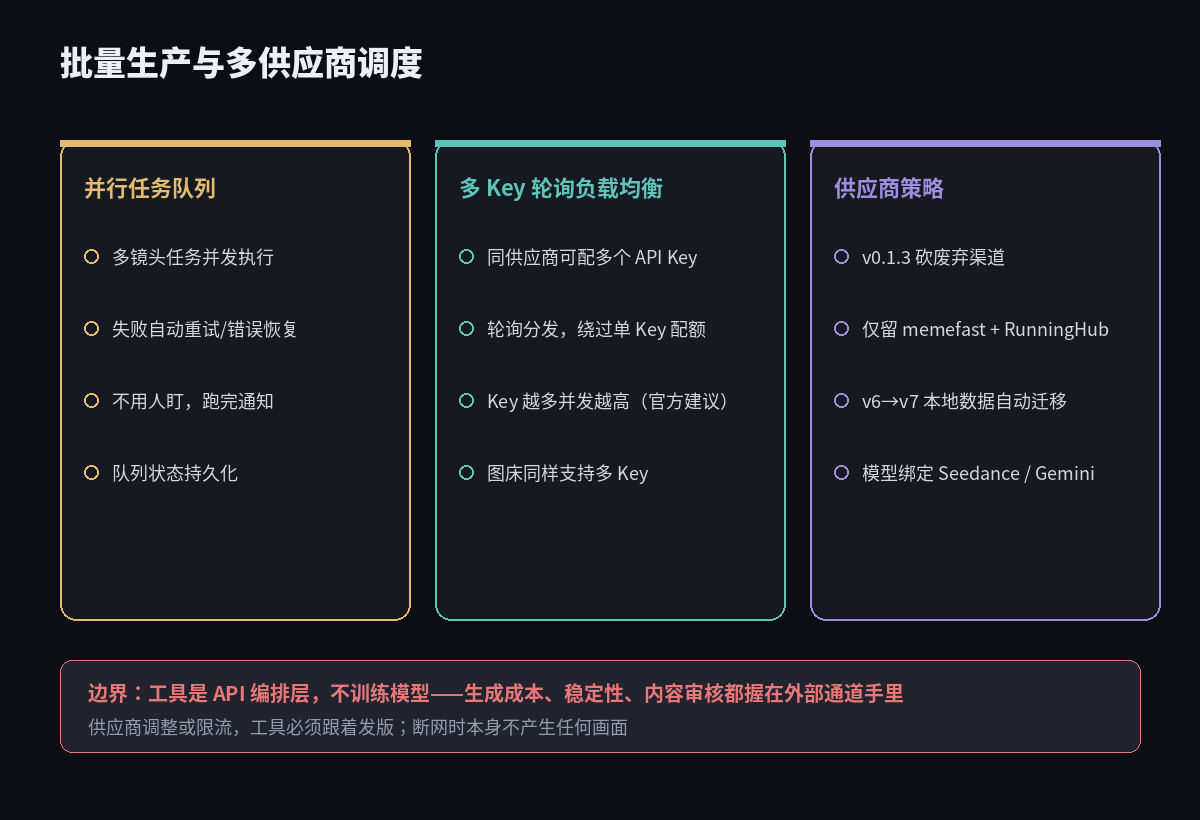
- 一键全流程:剧本解析 → 角色/场景生成 → 分镜切割 → 批量生图 → 批量生视频,一条任务链跑通;
- 并行任务队列 + 自动重试:失败任务进入错误恢复机制重跑,不需要人盯着;
- 多供应商调度 + Key 轮询负载均衡:可以配置多个 AI 服务商的多个 API Key,轮询分发请求。官方文档甚至直白建议"Key 越多并发线程越高、批量越快"——因为视频生成 API 普遍有并发和速率限制,堆 Key 是绕过单 Key 配额的现实做法。
供应商策略在 v0.1.3 做过一次大精简:砍掉 dik3、nanohajimi、apimart、zhipu 等废弃渠道,只保留魔因 API(memefast)和 RunningHub 两个核心供应商,并写了 v6→v7 的本地数据迁移逻辑自动清理旧配置。这也带出一个需要注意的事实:它的模型能力依赖第三方 API 通道,供应商一旦调整,工具就得跟着发版。
五、技术架构:标准的 Electron 生产级配置
技术栈选得很主流,没有炫技:
| 层级 | 选型 |
|---|---|
| 桌面框架 | Electron 30(主进程管存储/文件系统/协议,preload 做安全桥接) |
| 前端 | React 18 + TypeScript |
| 构建 | electron-vite(Vite 5) |
| 状态管理 | Zustand 5 |
| UI | Radix UI + Tailwind CSS 4 |
| AI 核心 | 内部包 @opencut/ai-core(prompt-compiler、character-bible、任务轮询) |
代码组织上,src/packages/ai-core 是真正的引擎:providers/ 抽象供应商、services/prompt-compiler.ts 负责提示词编译、services/character-bible.ts 管角色档案、protocol/ 定义内部通信协议。UI 面板按五大板块拆在 components/panels/,状态进 Zustand store,分层是清楚的。
几个能看出工程习惯的细节:内置演示项目(“灌篮少女”)通过数据播种机制让新用户打开就有东西可看;本地存储做了版本化迁移(v6→v7);导演面板 ResizablePanel 的 min-w-0 这类经典 Flex 布局坑也在 changelog 里有明确修复记录。对一个 2 月才建仓的年轻项目,这种规范度不错。
六、必须说清的三个边界
1. AGPL-3.0 双许可:商用不是随便用
很多人看到"开源"就以为能随便拿。它采用的是 AGPL-3.0 + 商业许可的双重模式:
- 个人学习、研究、非商业项目自由用,但你修改后的代码必须以同样协议开源;
- 关键在 AGPL 的网络传染性——哪怕你不分发二进制,只是基于它做 SaaS 给别人用,用户也有权索取完整源代码;
- 想闭源集成、做 SaaS 不开源、去掉协议约束,必须联系作者购买商业许可(仓库里有独立的 COMMERCIAL_LICENSE.md)。
想拿它包装成自己的商业产品的团队,这条务必先过法务。
2. 它是编排层,不是模型层
魔因漫创自己不训练任何模型,所有生图/生视频能力都来自外部 API(Seedance、Gemini 图像模型等),而且 README 顶部就挂着赞助商 Memefast API 中转聚合服务的广告位,默认供应商也是魔因 API。换句话说:你用它产生的成本、稳定性、内容审核,最终都握在 API 通道手里;工具的价值在工作流和品控,不在生成能力本身。断网或 API 涨价,它本身不产生任何画面。
3. 项目仍在早期
几个客观信号:最新打包版本 0.1.7(对应开源源码,另有百度网盘分发),package.json 版本 0.2.3;仓库最后一次 push 停在 2026-08-27,距今两个多月;33 个 open issues;README 里截图位还留着"后续替换为实际截图"的注释;v0.1.8 的 changelog 显示它甚至存在一个本地闭源版本(G:\moyin-creator),开源版与闭源版逐行对比修 bug——说明作者手里有更新的闭源版,开源仓库可能不是最前沿代码。用于严肃生产前,建议先验证当前版本对你目标供应商的可用性。
七、适合谁,怎么上手
适合:想批量做短剧、动漫番剧、预告片的个人创作者和小团队;想学习"多模型 API 编排 + 长流程工作流"工程实现的开发者(ai-core 包是很好的教材)。
不适合:追求完全离线/自研模型的人(强依赖外部 API);想直接闭源商用又不想买商业许可的团队(AGPL 限制);只需要偶尔生成单条视频的轻度用户(流水线的复杂度反而是负担)。
上手路径:Node.js ≥18,git clone 后 npm install、npm run dev,然后在设置里填 AI 服务商 API Key(还要配图床 Key 托管参考图),即可从剧本板块开始。不想跑源码的可以下作者打包的 Windows 安装程序。
结语
魔因漫创的价值主张很清晰:把 AI 视频从"一句提示词抽卡"改造成"一条可复用的生产线"。GroupRefManager 的多模态引用组装、角色圣经的一致性约束、多 Key 队列的批量调度,都是冲着真正的产能问题去的,工程上也撑得住"生产级"这三个字的一半。
但另一半要清醒:它解决的是流程,不是生成质量;它站在 API 之上而非模型之内;AGPL 协议和项目早期状态也决定了它现在更适合个人创作和技术学习,而不是无脑搬进商业系统。如果你正在认真做 AI 短剧,它值得装一遍——哪怕最后不用,它对"剧本到成片"这条链路的拆解方式,本身就值得抄作业。
项目地址:https://github.com/MemeCalculate/moyin-creator | 官网:moyincreator.com 协议:AGPL-3.0(商业使用需单独授权)| 版本:v0.2.3(安装包 0.1.7)| 数据基准:2026-11-05
本文基于仓库源码、CHANGELOG 与官方文档撰写,模型能力与供应商政策以官方最新信息为准。