7 万 Star 的 MediaCrawler 值得学吗?我通读 3.3 万行代码,顺便把合规坑说清楚
先交代背景:今年 6 月我写过一篇 MediaCrawler 入门教程,那时它 1.3 万 Star。四个多月过去,这个数字变成了 70,232,Fork 1.33 万,稳坐中文爬虫项目的头部。
入门教程讲"怎么装、怎么跑",这篇换个角度:我把仓库完整克隆下来,通读了约 3.3 万行 Python,回答两个更值得认真对待的问题——它的代码架构到底值不值得学?以及,用它的合规边界到底在哪里?
第二个问题可能比第一个更重要。先说一个很多人没注意的事实:MediaCrawler 不是严格意义上的"开源软件",这个后面专门讲。
一、先看它解决了什么难问题
七个平台(小红书、抖音、快手、B 站、微博、贴吧、知乎)的爬虫,传统做法的噩梦是 JS 逆向:每个平台都有自己的签名算法(比如小红书的 x-s、抖音的 a_bogus),加密参数随版本更新,逆向门槛高、维护成本更高,常常算法一改全站脚本报废。
MediaCrawler 的核心取舍是:放弃逆向,改用浏览器自动化绕开签名问题。 用 Playwright 起一个真实浏览器,你自己扫码登录,程序在这个保留了登录态的浏览器上下文里执行 JS 表达式,直接从页面环境里取已经算好的签名参数再发请求。浏览器自己会算签名,你只需要"借"结果。
这不是什么黑科技,但它把一个逆向工程师的活,降到了会用 Python 就能上手的程度——这是它能涨到 7 万 Star 的根本原因。
二、架构拆解:一套抽象,七个同构实现
代码的目录结构本身就是最好的架构文档:
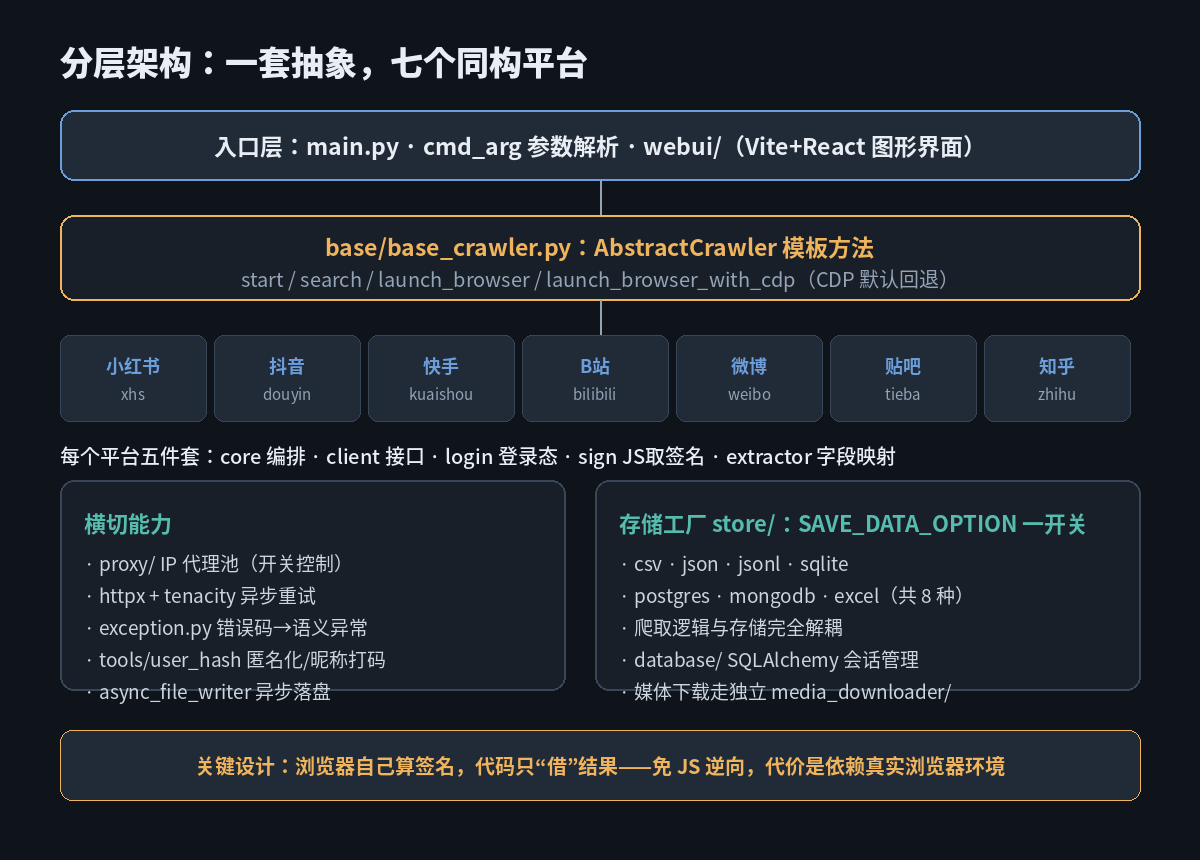
1. 模板方法:base/base_crawler.py
所有平台爬虫都继承 AbstractCrawler,它用抽象方法钉死了每个平台必须实现的骨架:start、search、launch_browser,以及配套的 AbstractLogin(begin、login_by_qrcode、login_by_mobile)。
class AbstractCrawler(ABC):
    @abstractmethod
    async def start(self): ...
    @abstractmethod
    async def search(self): ...
    @abstractmethod
    async def launch_browser(self, chromium, playwright_proxy,
                             user_agent, headless=True) -> BrowserContext: ...
这是标准的模板方法模式:父类控制流程骨架,子类(如 XiaoHongShuCrawler)填充平台差异。好处是七个平台的代码读起来结构完全一致——看懂一个,其余六个可以平移。新版还在基类加了 launch_browser_with_cdp 的默认实现(回退到普通模式),为 CDP 模式留了统一入口。
2. 平台内部分层:每个平台都是五件套
以 media_platform/xhs/ 为例,七个平台目录高度同构:
| 文件 | 职责 |
|---|---|
core.py | 主流程编排(搜索/详情/创作者三种爬取类型的状态机) |
client.py | 封装平台 HTTP 接口,带重试和异常映射 |
login.py | 扫码/手机号登录,登录态落盘缓存 |
playwright_sign.py / xhs_sign.py | 在浏览器上下文执行 JS 取签名 |
extractor.py / field.py | 响应 JSON → 统一数据模型的字段映射 |
还有专门的 exception.py 把平台返回的错误码翻译成语义化异常(IPBlockError、NoteNotFoundError、PlatformAccessError),这比满屏判断 status_code == xxx 干净得多。
3. 存储工厂:八种后端一个开关
store/ 下每个平台都有自己的工厂类,靠配置里一个 SAVE_DATA_OPTION 字符串选择实现:
class XhsStoreFactory:
    STORES = {
        "csv": XhsCsvStoreImplement, "db": XhsDbStoreImplement,
        "postgres": XhsDbStoreImplement, "json": XhsJsonStoreImplement,
        "jsonl": XhsJsonlStoreImplement, "sqlite": XhsSqliteStoreImplement,
        "mongodb": XhsMongoStoreImplement, "excel": XhsExcelStoreImplement,
    }
csv、json/jsonl、sqlite、postgres、mongodb、excel 共八种后端,爬取逻辑和存储逻辑彻底解耦——这是新手最值得抄走的设计:别在业务代码里直接 open(file, 'w')。
4. 横切能力:代理、重试、匿名化
proxy/是 IP 代理池抽象,ENABLE_IP_PROXY开关控制;- HTTP 层基于
httpx+tenacity做异步重试(RetryError在 core 里被捕获并降级处理); - 一个容易被忽略的细节是
tools/user_hash.py:提供anonymize_user_id和mask_nickname,落库前对用户标识做匿名化、昵称打码。写爬虫时主动内置隐私处理工具,说明作者对个人信息问题是有认知的——虽然这不能替代合规义务,但比同类项目光着身子存数据强。
三、CDP 模式:今年最重要的架构升级
6 月那版教程时,主力还是"Playwright 自己启动浏览器"。现在仓库默认配置 ENABLE_CDP_MODE = True,tools/cdp_browser.py 里的 CDPBrowserManager 成了新主角,这是反检测思路的一次升级。
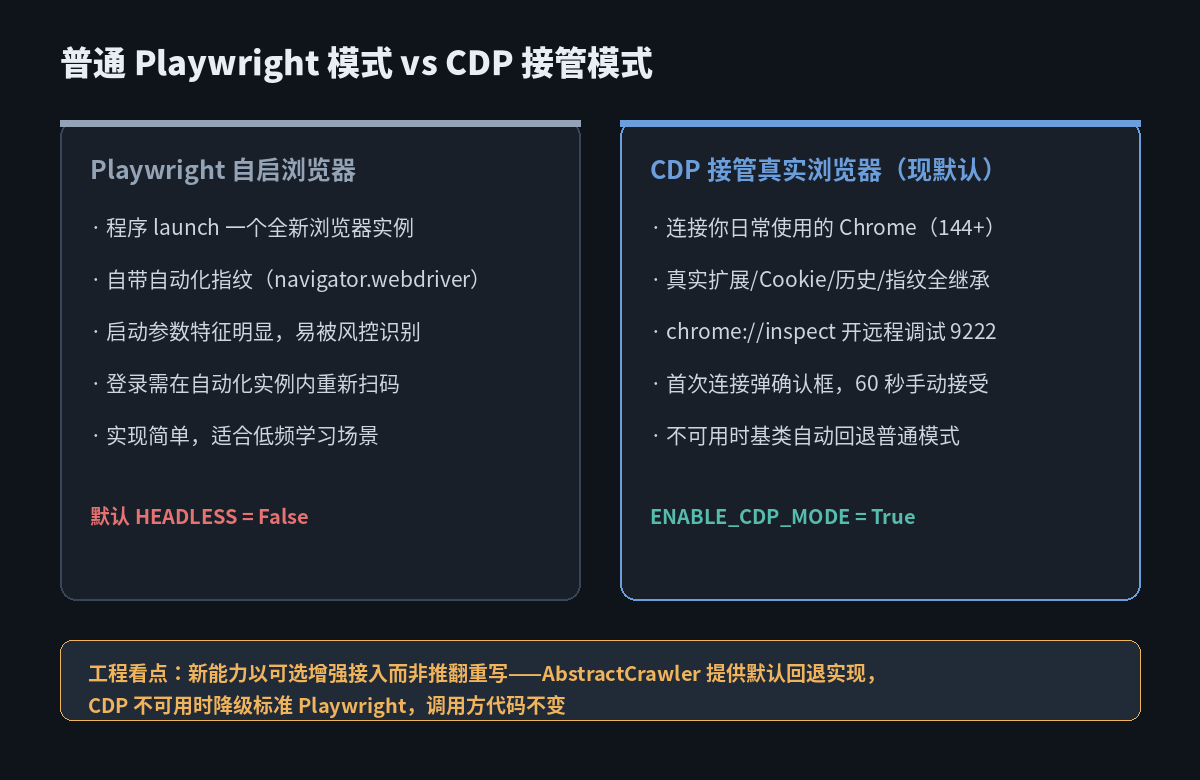
普通 Playwright 启动的浏览器自带自动化特征(navigator.webdriver=true、特定的启动参数指纹),平台风控容易识别。CDP(Chrome DevTools Protocol)模式的做法是接管你自己日常使用的那个 Chrome:
- Chrome 144+ 地址栏打开
chrome://inspect/#remote-debugging,勾选允许远程调试,本地 9222 端口就绪; - 程序通过 CDP 连上这个真实浏览器——它带着你的全部扩展、Cookie、历史记录和真实指纹;
- 首次连接时 Chrome 会弹确认框,60 秒内手动点"接受",不存在静默接管。
文档对两种 CDP 用法也做了区分:连接已有浏览器(反检测最好,默认推荐)和启动新实例。工程上值得学的点是:它没有抛弃旧路径,而是在 AbstractCrawler 基类用默认方法做了回退,CDP 不可用时自动降级到标准 Playwright 模式——新能力以可选增强接入,而不是推翻重写,这是成熟项目的演进方式。
另外仓库现在还带了一个 Vite + React + Radix UI 的 webui/(mediacrawler-webui),给不想敲命令行参数的用户提供图形界面,通过后端 API 驱动同一个爬虫内核。
四、泼冷水:这三个坑,入门教程不会重点讲
1. 它不是 OSI 意义上的开源软件
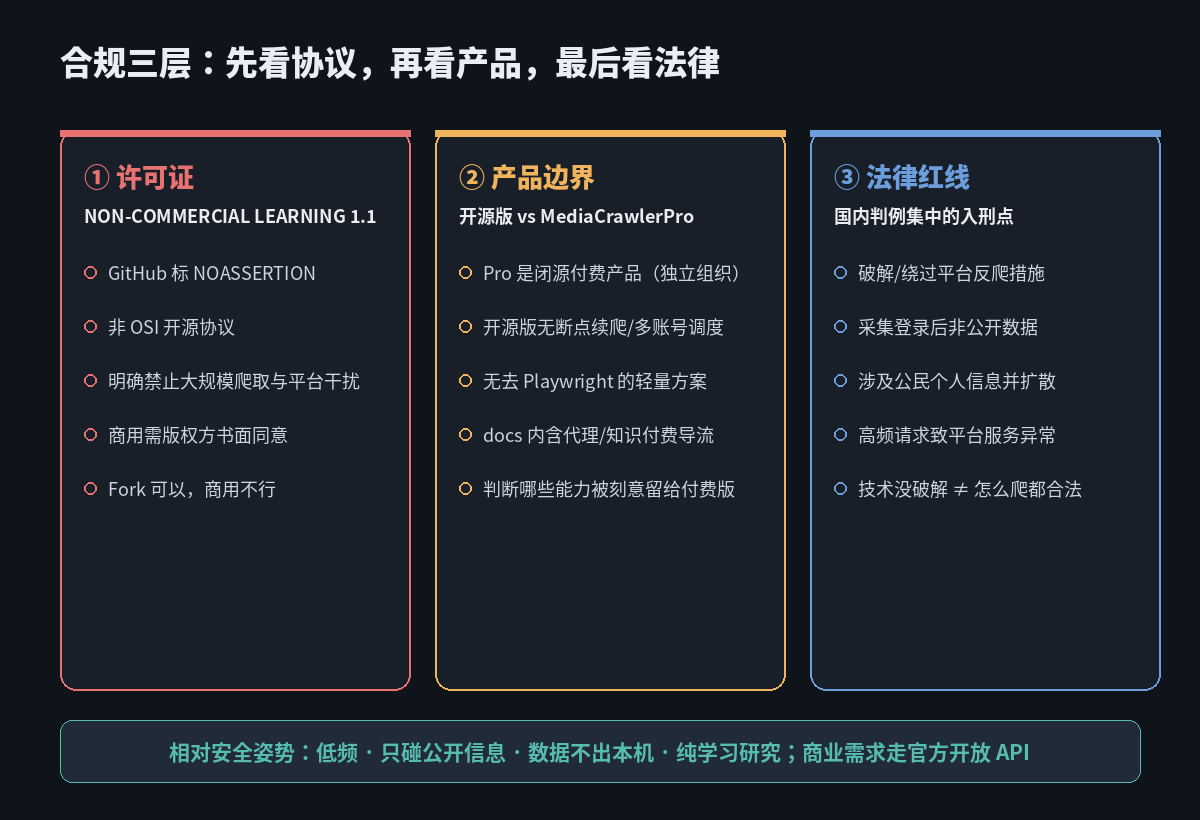
GitHub API 返回的 license 字段是 NOASSERTION,实际协议是项目自撰的 NON-COMMERCIAL LEARNING LICENSE 1.1(非商业学习使用许可证)。我逐条读了,三条硬限制写得很死:
- 仅限非商业的学习和研究目的;
- 禁止大规模爬取和任何干扰平台运营的行为;
- 未经版权方书面同意,不得用于任何商业用途。
这意味着:公司里拿它做竞品分析、做数据产品、接进商业系统,哪怕只是内部用,都落在协议禁止区。Apache/MIT 那种"随便用"的自由在这里不存在。技术上可以 Fork,法律上不能商用。技术选型时这一条的权重应该排在架构优点前面。
2. 开源版和 Pro 版是两个东西
README 里折叠了一块 MediaCrawlerPro 的推广,这是组织 MediaCrawlerPro 下的闭源付费产品。开源版明确没有的能力:断点续爬、多账号调度、去掉 Playwright 依赖、完整 Linux 支持。开源版跑到一半网络断了,重新开始的成本不低;这些恰是生产环境最需要的。另外 docs/ 里还有知识付费、代理服务商(快代理、豌豆 HTTP)的导流文档——理解项目的商业化结构,有助于你判断哪些能力是刻意留给付费版的。
3. 法律红线是真实存在的,不是免责声明走过场
README 顶部挂着 爬虫违法违规案件合集 的链接,每个源码文件头部都印着五条使用原则,这不是形式主义。国内近年的判例里,爬虫入刑主要集中在:绕过/破解平台反爬措施(计算机信息系统安全类罪名)、抓取需登录才能见的非公开数据、采集公民个人信息并扩散、以及高频请求造成平台服务异常。
技术事实也要讲清楚:MediaCrawler 采集的是你本人登录后有权看到的内容,CDP 模式没有破解任何加密、没有伪造登录凭证,签名是浏览器在正常页面环境里生成的——它处在"自动化操作自己的账号"这个区间,和盗号撞库、破解接口有本质区别。但"技术上没破解"不等于"怎么爬都合法":请求频率、数据用途(尤其商用和二次分发)、是否涉及他人个人信息,三条线任何一条越界,风险性质就变了。学习研究、低频、只处理公开信息、数据不出本机,是相对安全的姿势。
五、那它到底值不值得学?
我的结论分两层:
作为学习素材,非常值得。 抛开采集用途本身,这个仓库是一份高质量的 Python 异步工程教材:模板方法 + 策略工厂的组合拳、七平台同构的目录组织、HTTP 异常的语义化封装、八后端存储抽象、CDP 接管与降级、异步文件写入(async_file_writer.py)、滑块工具(slider_util.py)、配置与代码分离。3.3 万行读下来,能学到的工程模式比大多数玩具项目扎实得多,这也是它区别于"脚本合集"类爬虫仓库的地方。
作为生产工具,要极度谨慎。 非商业协议封死了商用路径,开源版缺断点续爬等生产特性,而法律风险不会因为"大家都在用"而消失。真有合规的数据需求,正路是平台开放平台的官方 API、有授权的数据服务商,或者至少先过一遍法务。
它的 7 万 Star,我觉得一半是给"免逆向采集七平台"这个点子的,另一半是给这套架构的。前者带着争议,后者经得起读。
项目地址:https://github.com/NanmiCoder/MediaCrawler | 协议:NON-COMMERCIAL LEARNING LICENSE 1.1(非商业学习,非 OSI 开源) 数据基准:2026-11-05(70,232 Star / 13,308 Fork / 220 open issues)| 代码规模:约 3.3 万行 Python
本文是架构学习笔记,不构成任何采集行动建议。请仅在法律允许、平台授权、非商业研究的前提下使用相关工具,遵守目标平台 robots 协议与服务条款。配套入门教程见本站 6 月文章。