零粉丝新号 13 天 37 万播放:这个开源 Agent Skill,让代码一帧一帧画出整条短视频
“一句话让 AI 生成视频"如今已经不稀奇,但真做过内容的人都知道那是什么体验:像抽卡。出来什么样、为什么是这样、下一条还能不能复现,全都不可控。
今天这个开源项目走的是一条完全相反的路。它叫 charles-video-maker,是一个装进 Claude Code / Antigravity 这类 AI 编程工具里的 Agent Skill:你给文字稿,它交付一条带配音、逐字字幕、封面和发布文案的成片——而画面,是让模型写一个会按时间 t 自己绘制的网页,再一帧一帧截图合成出来的。
最有话题性的是作者甩出来的一组真实数据:零粉丝新号,2026 年 10 月 20 日开号,13 天做到 37 万+ 播放,0 投流,代表作一条 78 秒的视频拿了 23.1 万播放、7053 次分享。
我把仓库克隆下来通读了 SKILL、14 份参考文档和全部脚本(约 2.9 万行)。这篇讲清楚它到底怎么工作、为什么"代码画视频"反而更可控,以及那 37 万播放里有多少是工具的功劳、有多少不是。
一、它是什么:一个给 Agent 的「视频制作 SOP」,不是剪辑软件
先厘清形态。它不是 Premiere、剪映那种你手动操作的软件,也不是 Sora/Veo 那种输入提示词直接吐视频的生成模型。它是一份教 AI 编程助手如何做视频的技能包:
npx skills add anneheartrecord/charles-video-maker
装好后,你在 Agent 里说一句:
把这篇文章做成一条 60 秒的竖版视频,要配音和字幕
剩下的由 Agent 按技能包里固化的流程执行。核心机制一句话:Opus/Claude 这类编程模型自己不会输出视频,但会写网页。于是让它写一个暴露了 render(t) 函数的动画网页——t 是时间(秒),画面随 t 变化;脚本用 Playwright 把每一帧截下来,FFmpeg 合成为 MP4,声音用 TTS 合成。
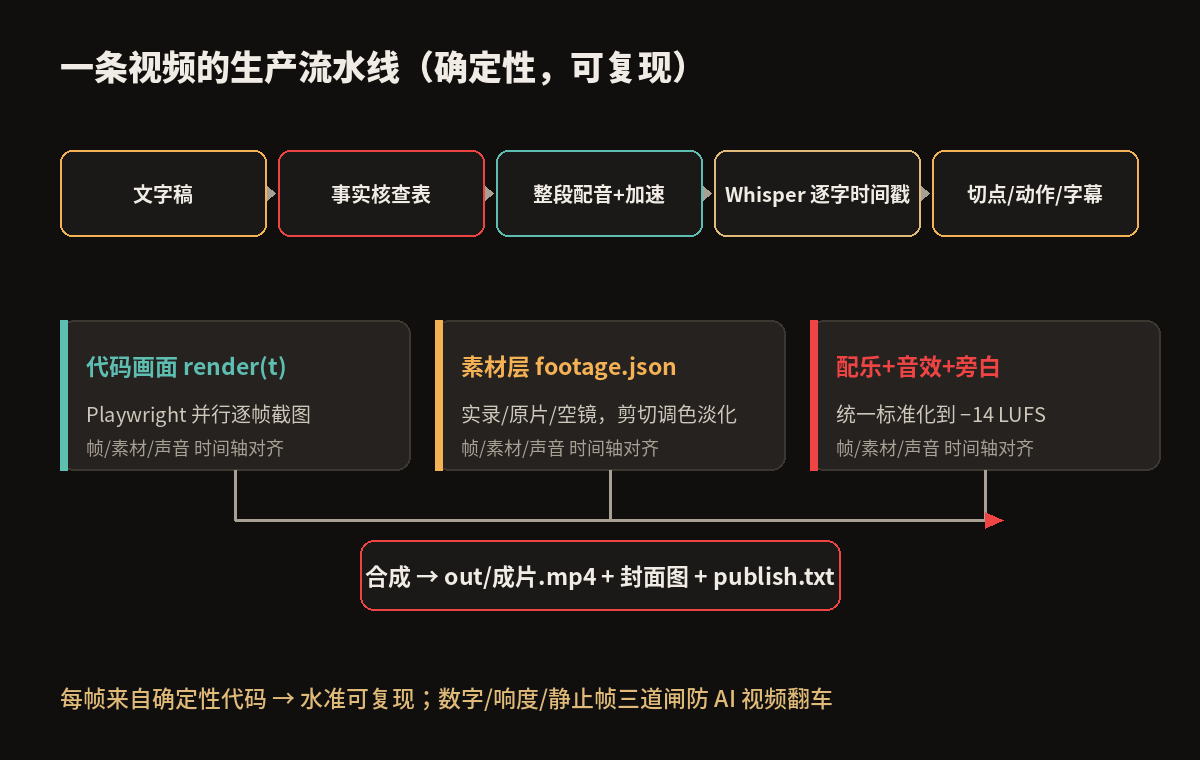
这带来一个关键区别:因为每一帧都来自确定性的代码,“下一条还能不能做出同样水准"是可控的;而且任何一个画面元素、时间点、数据都可以精确到帧地修改和复核——这正是"抽卡式生成视频"做不到的。
二、四种画面路线:不只是代码动画
它并不是只会画代码动画,SKILL 开头先做"分流”,根据你要讲的东西选路线:
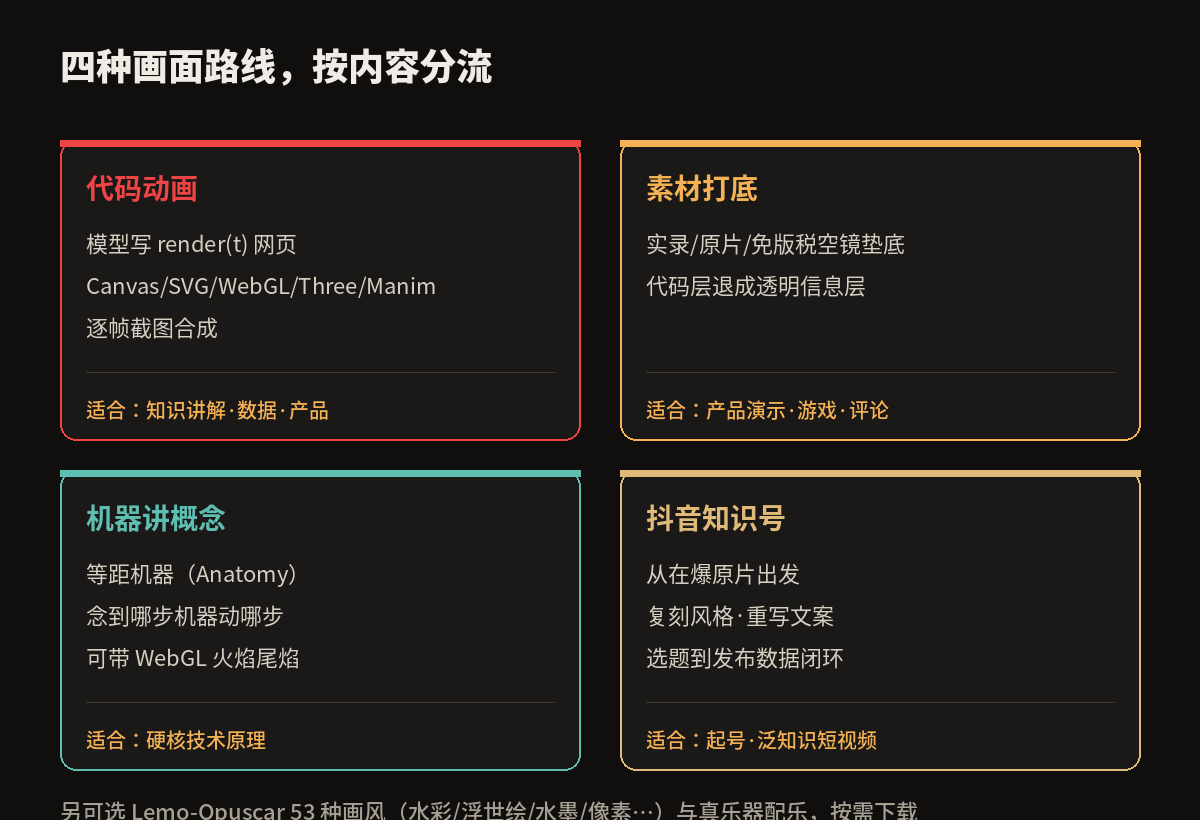
- 代码动画(code-rendered):模型写按时间绘制的网页(Canvas / SVG / WebGL / Three.js / Remotion / Manim 都行),逐帧截图合成。适合知识讲解、数据可视化、产品介绍。
- 素材打底(footage layer):用实录画面、原视频片段、Pexels/Pixabay 免版税空镜或生成图垫在底层,代码画面退成一个透明信息层叠上去。适合产品演示、游戏介绍、评论视频——解决"画面全是插图不够真实"的问题。
- 机器讲概念(Anatomy):把一个技术概念造成一台会动的等距(isometric)机器——百分表、抽屉柜、绘图仪,甚至带 WebGL 尾焰的猛禽发动机。旁白念到哪一步,机器就做哪一个动作,读者因为"认出了机器"而理解原理。
- 抖音知识号模式(Douyin mode):这是最特殊的一条,从一条正在爆的原片出发,选题、复刻风格、重写文案、配乐、渲染、定时发布、拉数据一路做完。
另外还能可选接入 Lemo-Opuscar 的 53 种画风(油画厚涂、水彩、浮世绘、水墨、像素 RPG……)和真乐器配乐,但风格库按需下载(约 350MB,采样库另约 1.3GB),不强制塞进仓库。
三、一条视频的生产流水线:细节里全是工程
最能体现这个项目成色的,是它把"做一条能看的视频"拆成的这条严谨流水线:
文字稿 → 事实核查表 → 配音(整段合成+加速)→ Whisper 逐字时间戳
      → 场景切点/动作点/字幕
代码画面 render(t) → 逐帧截图(并行渲染)─┐
素材层 footage.json → 剪切/调色/淡化    ├→ 合成 → 成片+封面+publish.txt
配乐+音效+旁白 → 标准化到 -14 LUFS      ┘
逐个说几个我觉得专业的点:
1. 配音对齐——整段合成,再用 Whisper 对回原文。 TTS 不是一句一句拼,而是整段合成(更自然)、可加速(默认 Gemini TTS 1.25 倍速),然后用 Whisper 做逐字时间戳,把识别结果对齐回稿子原文。这样场景切换、画面动作、音效、字幕全都绑定在"念到哪个词"上,而且识别错的字不会污染字幕——字幕显示的是你的原稿。Apple Silicon 用 mlx-whisper,其他机器用 faster-whisper。
2. 事实核查闸门(factcheck)。 只要稿子里出现价格、额度、数据、产品功能、截止日期,或"最新/现在"这种会过期的说法,就必须先调研、建一张核对表(factcheck.py extract)。正式渲染前还有一道闸:factcheck.py gate 同时校验旁白文案和画面代码里出现的数字,退出码非 0 就不许出片。这是专门防 AI 视频最容易犯的"一本正经编数字”。
3. 音频按广播标准做。 混完统一标准化到 -14 LUFS(YouTube/抖音等平台的响度规范),还要过真峰值(true peak)检查,避免不同平台音量忽大忽小。
4. 静止检查(still_check)。 自动找出"画面停住超过 2 秒"的段落,以及"字幕已经换了、画面却没跟上"的地方——这俩是 AI 生成视频最常见的划水痕迹。
5. 三方案先确认,再动手。 普通模式不会闷头直接做,而是先给三个方案(每个都写清封面和开头黄金几秒)+ 关键帧/几秒预览,你确认后写成 brief.md,再从封面和开头逐镜头制作、逐镜头自检。一句话抽卡变成了"先规划后施工"。
四、最受关注的抖音模式:一条 23 万播放是怎么来的
仓库里最"出圈"的是抖音知识号模式,README 直接放了三条代表作和真实数据。它的逻辑很值得内容创作者琢磨——不从"我想讲什么"出发,而从"一条正在爆的视频"出发:
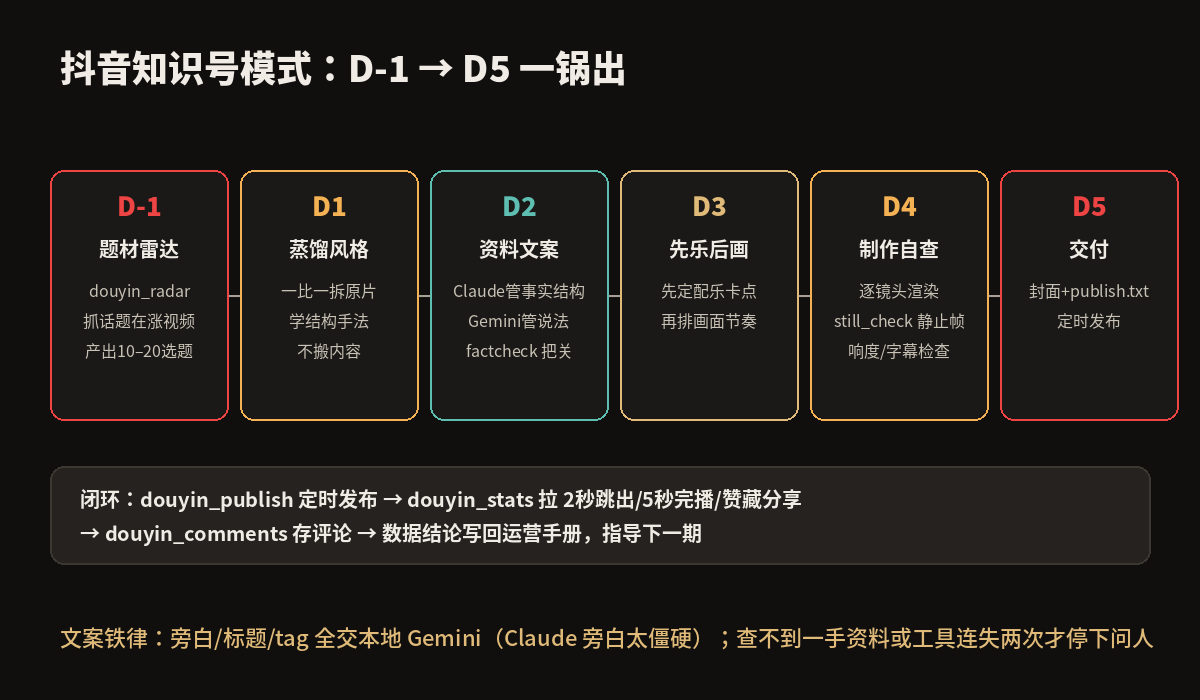
D-1 题材雷达 → D1 蒸馏风格 → D2 资料与文案 → D3 先测配乐再排画面 → D4 制作自查 → D5 交付
                                                                    │
        数据结论写回运营手册 ← douyin_stats/comments ← douyin_publish ↘
- D-1 题材雷达:
douyin_radar.py抓某个话题下正在涨的视频并排名,一次产出 10–20 个选题; - D1 蒸馏风格:一比一拆解原片的风格,但内容不搬运,而是在画面冲击力、质感、卡点上力求做得比原片更好;
- 开头 3 秒专门有一份
douyin-opening.md,拆了一批头部爆款的开头,画面、第一句、声音各有检查表; - 文案分工很有意思:旁白、标题、简介、tag 全部交给本地 Gemini(Antigravity CLI
agy)写,Claude 只负责事实和结构——作者明确注释"Claude 写的旁白太僵硬"(2026-10-22 用户定的规矩)。Claude 写任务单(查实的事实、每句时长、画面在演什么),Gemini 写说法,再用check做硬校验(字数塞不塞得进时长、有没有编数字),最多返工两轮; - D3 先定配乐再排画面,让卡点有依据;
- 发布与复盘闭环:
douyin_publish.py定时发布,douyin_stats.py拉 2 秒跳出、5 秒完播、点赞、收藏、分享,douyin_comments.py存评论,数据结论写回你自己维护的"运营手册",指导下一期选题。
它的授权哲学也写得很直白:一次授权就一路做到交付,只有查不到一手资料、或同一个工具连续失败两次时才停下来问人。
但请注意 README 里同样诚实的一句话:“同一套流水线也做出过几十播放的片子:流量主要由选题和开头 3 秒决定,工具负责把成品质量稳定在同一个水平。” 这是理解这个项目价值的关键——它是一个质量稳定器和产能放大器,不保证爆款。37 万播放里,选题判断和前 3 秒钩子仍然是人的功劳。
五、工程与协作:合并了两个开源项目,来源标得很清楚
这个 Skill 不是凭空造的,致谢和协议部分写得很规范,这在中文 AI 项目里值得肯定:
- 视频流程、文档和渲染脚本起步于周行(Kianzzz)的 xilo-opus-video,本仓库在其上加了配音流水线;
anatomy/目录原样收录自 Ryan(@wheresryan22)的 Anatomy,未改动,再用bridge/把静态的等距机器变成可逐帧渲染的视频画面;- 抖音起号打法改写自蔚蓝 WEILANX 的《Opus 5.5 抖音起号超级保姆级万字教程》第五、六章;
- 风格库、真乐器采样器、Kokoro 离线配音、阅读时长检查来自 LemoLab 的 Lemo-Opuscar,按需下载、不并入仓库。
依赖也分层清晰:必需的是 Python 3.9+(numpy/scipy/playwright + Chromium)、FFmpeg、Node 20.10+(Anatomy 构建只用内置模块)、一个 TTS(Gemini TTS 或免费 edge-tts,Kokoro 可离线)、Whisper;可选的是 yt-dlp、Pexels/Pixabay Key(空镜)、登录过抖音创作者中心的浏览器配置、Lemo 风格库。一个安全细节:所有 API Key 只从环境变量读,不写进任何文件。
六、开工四选与边界
普通模式开工时它会问你四件事(都有默认值,抖音模式跳过):画面(代码/素材/风格库画风)、规格(默认竖版 1080×1920 30fps、第一帧即封面;可选横版 1920×1080 24fps 电影节奏)、配音(Gemini TTS 1.25×/edge-tts/Kokoro 离线/无)、流程(三方案确认 / 只问一次直接做)。
为了不写成软文,也要明确它不做什么(来自 SKILL 的 Not for 声明和 ROADMAP):
- 不做用 Veo 这类视频模型生成素材(在 ROADMAP 里还"等确认预算再接");
- 不是 Premiere/剪映/AE 那样的剪辑器,也不是给一条已有视频加字幕的工具;
- 空镜目前还要人工看编号拼图挑选(自动打分挑选在待办里);插入原片时旁白的停顿衔接还要手动安排;
- 抖音模式需要你自己登录创作者中心、维护工作目录(默认
~/Desktop/video/vibe-video/)和运营手册——没有手册也能出片,只是跳过"读手册"和"数据写回"; - 它是早期项目:仓库 2026-10-19 才建,到本文只有 49 Star、约两周历史,脚本和打法都还在快速迭代,复刻爆款也涉及平台规则与版权灰色地带,务必只用你有权使用的素材、遵守抖音条款。
七、适合谁
- 想做泛知识/科普短视频但不会动效和剪辑的开发者:你只要会写稿、会用 Claude Code,画面动效交给代码渲染;
- 追求批量稳定产能的知识号运营者:抖音模式把"选题→复刻→制作→发布→复盘"流水线化,但选题和钩子仍需你把关;
- 要给产品/游戏做演示视频的团队:素材打底模式能把实录和代码信息层结合;
- 做技术教育内容的人:Anatomy 的"机器讲概念"是把抽象原理讲明白的稀缺能力。
结语
charles-video-maker 最打动我的,不是 37 万播放这个数字,而是它背后的方法论:与其追求一句话抽卡式的"生成",不如把视频制作拆成可规划、可核查、可复现的工程——先出方案、数字过事实核查、配音逐字对齐、响度达标、静止帧自检、发布后数据回流。 画面用代码一帧帧画出来,看似绕远,实则换来了确定性。
它把 xilo-opus-video、Anatomy、Lemo-Opuscar 这些散落的开源能力缝合成一条完整 SOP,又诚实告诉你"工具只保证质量下限,爆款仍靠选题"。如果你正在认真做(而不只是玩)AI 短视频,这条"代码画视频"的路线很值得花一个下午跑通。
项目地址:https://github.com/anneheartrecord/charles-video-maker | 协议:MIT | 数据基准:2026-11-03
本文基于仓库源码、SKILL.md、14 份 references 与 README 实跑信息撰写;播放数据为作者自述(截至 2026-11-02),请结合自身判断,合规使用素材与平台功能。