不用视频模型做电影:我拆解了 2.1k Star 的 Lemo-Opuscar,43 种画风全靠 AI 写代码逐帧渲染
2026 年想做一支动画短片,默认路径已经变成了打开视频生成模型、抽卡、再抽卡。可真正做过内容的人都知道那种别扭:同样一句提示词,两次出片人物长得不一样;想要 30 秒就得分段生成再祈祷接缝别崩;画面里的文字基本靠运气;想复用同一个角色拍系列片,更是玄学。更不用说训练数据授权那笔一直没算清的账。
如果反过来呢——不用任何视频生成模型,让 AI 把每一帧都用代码画出来,画面 100% 可复现、文字精确可控、声音一次性配齐?lemomo-ai/lemo-opuscar 做的就是这件事。它是一个 Claude Code 插件/技能库:43 种影片风格,每种都配一支完全用代码做出来的样片;你带上自己的故事,编程 agent 当导演。建仓仅几周、只有 26 个 commit,已经涨到 2.1k Star、223 Fork(我写文时的数据),作者 Lemomo 还用同一套管线做了 6 分 31 秒、复刻 98 部奥斯卡最佳影片画风的《OPUSCAR 98》。
我把仓库完整克隆下来,通读了 DIRECTOR.md、TECHNIQUE.md、AGENTS.md 和 core/ 渲染工具链源码。这篇文章讲清楚三件事:它到底怎么把「写代码」变成「拍电影」、真实上手成本几何、以及谁该现在装、谁应该再等等。
核心心智模型:画面是时间的确定性函数
理解整个项目只需要一个约定。每部片子就是一个文件夹,里面一个 index.html 向渲染器暴露四个全局量(来自 TECHNIQUE.md §2 与 core/README.md 的页面契约):
window.DUR = 54.2;                 // 片长(秒)
window.render = (t) => { ... };    // 画出 t 秒那一帧,确定性
window.READY = true;               // 字体、图片加载完才置位
window.TEXTS = (t) => [{id, text, x0,y0,x1,y1}]; // 可选:画面文字与包围盒
render(t) 是纯函数:禁止 Date.now(),禁止不播种的 Math.random()(仓库 core/lib.js 提供 mulberry 和 hash 两个确定性随机源),不许把状态从上一帧带到下一帧。于是任何一帧都能单独渲染、任意顺序渲染、交给任意 worker 渲染,结果逐字节一致。
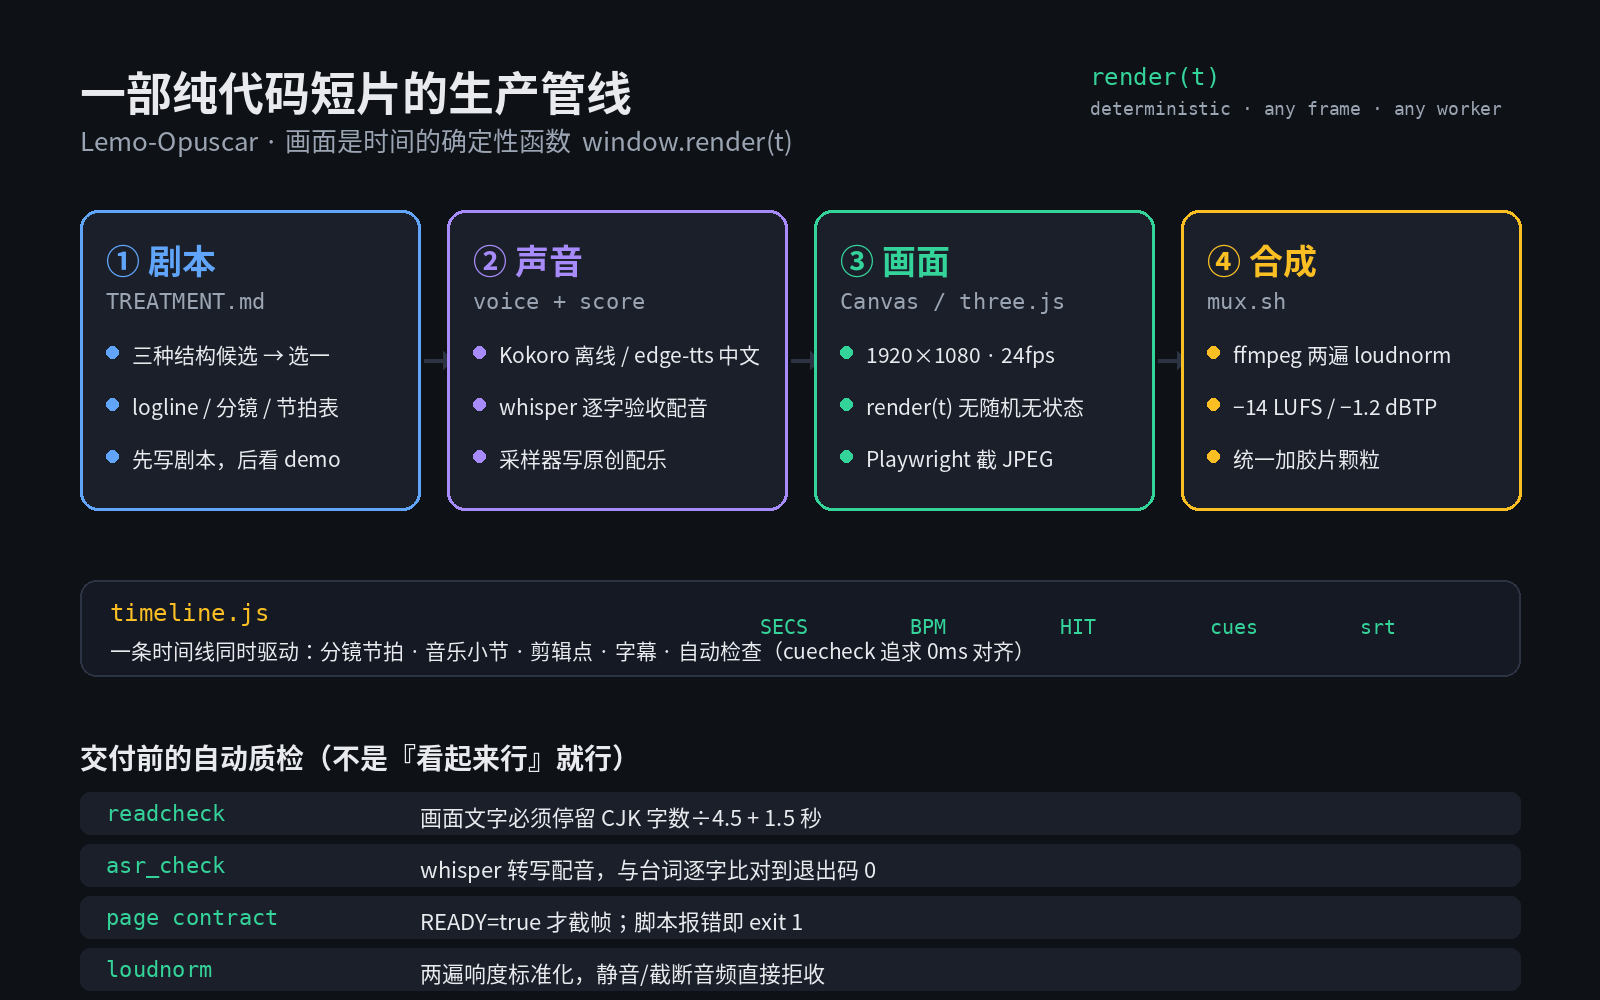
渲染器 core/render/video.mjs 用 playwright-core 拉起无头浏览器(依赖只有 playwright-core 和 three 两个 npm 包),最多 6 个 worker 并行,每帧截 JPEG(不是 PNG——作者注释里写明:胶片颗粒在页面里画会让每帧不可压缩、慢得要命,颗粒统一留给 ffmpeg 后期加),默认 1920×1080、24fps。一条片子从「源码」到「成片」的标准 build.sh 就五步:导出事件表 → 逐帧渲视频 → Python 混音 → ffmpeg 合成。
这里有个值得单独说的工程取舍:动画可以 on twos(每秒 12 张),但摄影机和光必须逐帧平滑——TECHNIQUE.md 明确写着步进的摄影机会被读成卡顿。这种细节不是教程抄来的,是真做过几十部片子才踩得出来的坑。
一条时间线统治声音、画面和字幕
普通做片是画面、配乐、字幕三套时间轴互相凑;Lemo-Opuscar 要求把全片的段落、速度、节拍、卡点写进同一个 timeline.js,再导出 JSON 给配乐、混音、字幕和检查脚本读同一套数字:
export const SECS = [{ id: 'chase', t: 12.0, bpm: 144, beats: 12 }, ...];
export const HIT  = { pratfall: ['chase', 6], ... };  // 段落 + 第几拍
多个样片自带 cuecheck.py,把每个视觉切点和它该落的音乐拍点逐一比对,目标写得很直白:0 ms。
声音部分比多数人预想的完整得多:
- 配音:英文默认 Kokoro(kokoro-onnx,完全离线,
af_/am_美音、bf_/bm_英音,按片子选角而不是沿用样片声线);中文走tts_zh.py调微软 edge-tts 神经音色(zh-CN-XiaoxiaoNeural等,需联网)。你也可以直接给真人录音。 - 逐字验收:
core/tts/asr_check.py用 faster-whisper 把生成的配音重新转写,和台词逐字比对(中文按字),不到退出码 0 就重生成。 - 配乐:
core/audio/sampler.py驱动免费采样库(freepats、karoryfer、salamander 三角钢琴、VCSL、VSCO2 CE,用tools/fetch.sh instruments拉取)写原创音乐,pluck.py用 numba 做拨弦合成。 - 母带:
mux.sh跑两遍 ffmpegloudnorm,压到流媒体标准 −14 LUFS、真峰值 −1.2 dB,配音先压缩再按 RMS 比音乐高约 10 dB;检测到静音、损坏、截断的音轨直接拒收,绝不留下半成品文件。
还有一个我特别喜欢的质检:readcheck.mjs 每 0.04 秒向页面询问一次 TEXTS(t),强制任何画面文字完整、不重样地停留「中文字数 ÷ 4.5 + 其他字符 ÷ 15 + 1.5 秒」以上。换句话说,「字幕闪太快没人看得清」这个全网短视频通病,在这套体系里是编译错误,不是审美问题。
43 种风格:不是提示词合集,是 43 份「美术宪法」
仓库的主体是 styles/ 下 43 个风格目录(外加 _template)。每个目录里:STYLE.md 是风格不变量——配色、字体、运镜语法、声音调色板、这一媒介的「原生动作」和易踩的坑;DEMO.md 加 demo/ 是作者用该风格拍的样片源码。风格分九大类:手绘绘画(水墨、厚涂、水彩、浮世绘……)、东方传统(皮影、剪纸、纸雕灯影)、印刷版画、图形排版(ASCII/CRT、瑞士动态排版、间谍片头)、信息发布(数据叙事、活体录屏、全息 HUD)、卡通动画、游戏(16-bit RPG、HD-2D、瓦里奥制造式微游戏)、电影时代(默片、后室伪纪录片)、材质 3D。
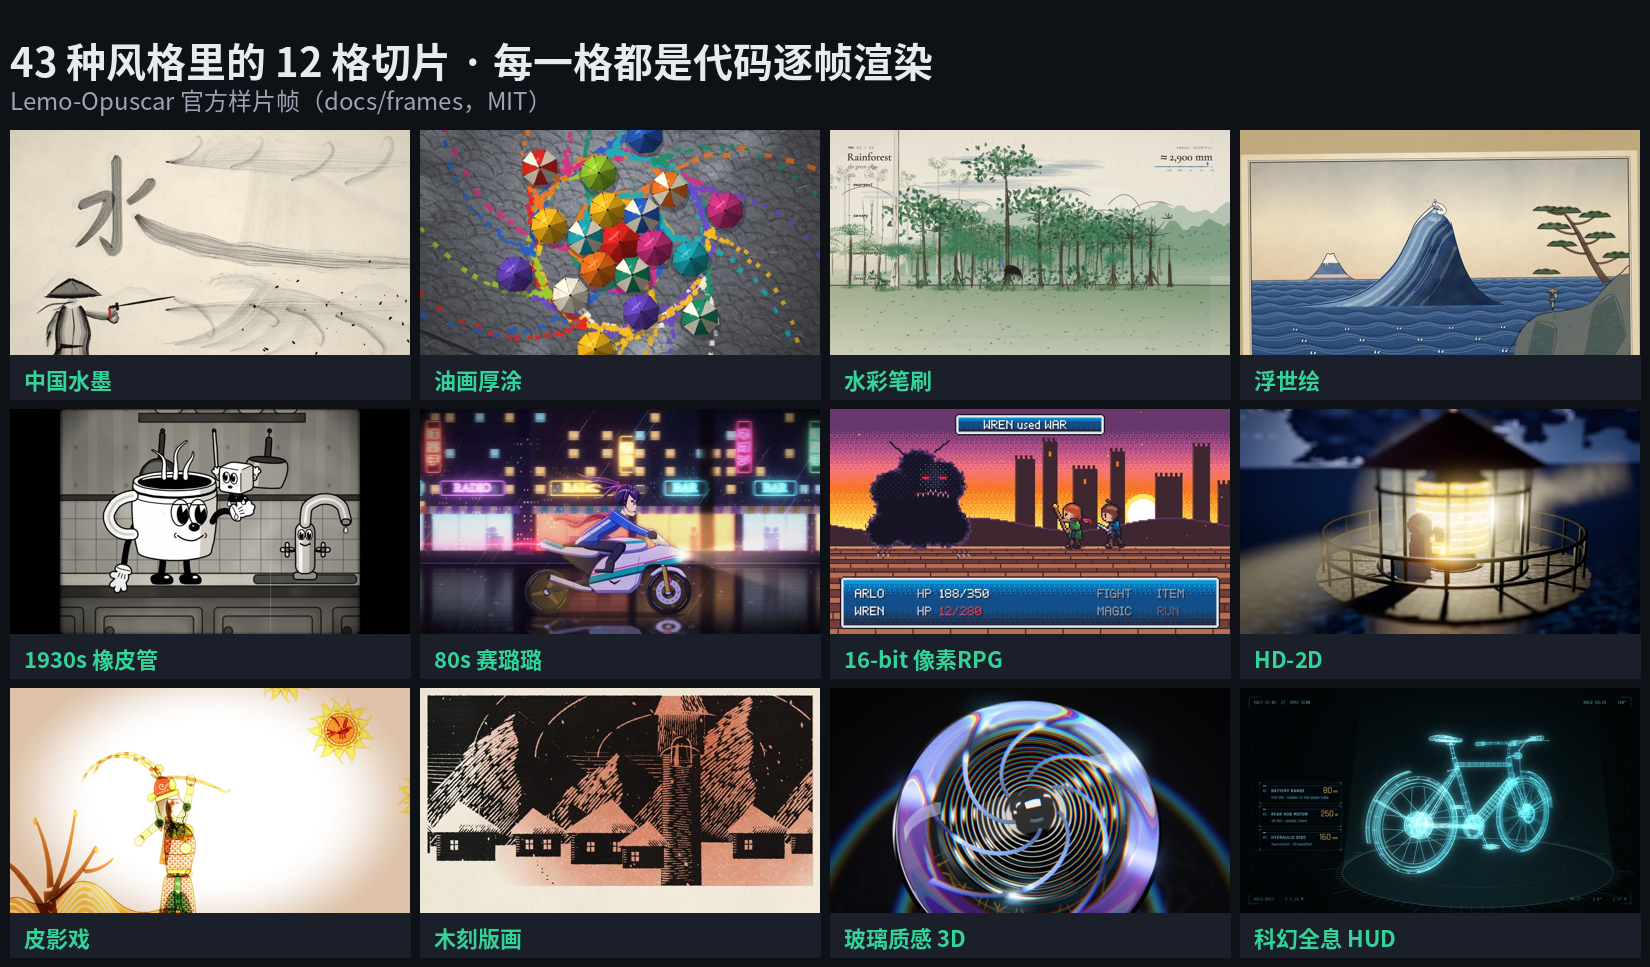
上面这张矩阵里的每一格,都是我从仓库 docs/frames/ 直接取的真实样片帧,没有一张是生成模型出图。800×450 的尺寸背后是 1920×1080 的逐帧渲染。
仓库的使用规则设计得相当有立场,写在 AGENTS.md 里:先写你自己的 TREATMENT.md(三种结构候选、选一并说明理由、benchmark 只学语法不抄内容),写完才允许打开风格的 DEMO.md;demo 只许学技法(笔刷引擎、骨骼绑定、shader),不许借故事、分镜、道具。用户的片子做在 styles/ 之外,不加 LemoLab 署名、不加水印。导演手册 DIRECTOR.md 甚至规定「前 3 秒必须有钩子,不许先放慢悠悠的 logo」「一个缩略图尺寸就能读懂的梗,胜过三个要解释的梗」——这是创作规范,不是代码文档。
三分钟上手,然后等它拍 30–60 分钟
官方推荐装成 Claude Code 插件:
claude plugin marketplace add lemomo-ai/lemo-opuscar
claude plugin install lemo-opuscar@lemolab
第一次使用时,插件的 setup.sh 会把指南、core/ 工具和全部 STYLE.md 以 sparse clone(稀疏检出,排除 demo 源码、大图、海报)拉到 ~/lemo-opuscar,所有片子共用这一份库;你的成片工程放在发起命令的文件夹里。依赖分三层、按需安装,设计很省:
sh plugin/skills/lemo-opuscar/scripts/setup.sh deps         # 核心:npm 包 + 无头浏览器 + Python 基础层
sh plugin/skills/lemo-opuscar/scripts/setup.sh deps voice   # Kokoro/edge-tts/whisper
sh plugin/skills/lemo-opuscar/scripts/setup.sh deps music   # numba 拨弦合成
系统要求:Node 20+、ffmpeg、Python 3.11–3.13(kokoro-onnx 不支持 3.14;没有 uv 时脚本会自己找 3.12/3.13 建 venv)。装包还做了校验和标记:package.json 或 requirements 内容变了才重装,避免每次做片都等依赖。
不想装插件也可以裸 clone 后 claude 进入,片子落在仓库的 films/<名字>/。然后就一句话:
用油画厚涂风格做一支 30 秒的片子,讲我家那只每天在窗台等我下班的橘猫。
它全程只打断你一次:确认它定不了的事实、你有没有自带配音/音乐/素材、要不要先看分镜故事板。要看,它会用真实风格代码渲出关键镜头停一次;不看就直接交成片。README 给的预期很诚实:一支片子 agent 大约跑 30–60 分钟,token 用量不小。
它和视频生成模型,到底怎么选
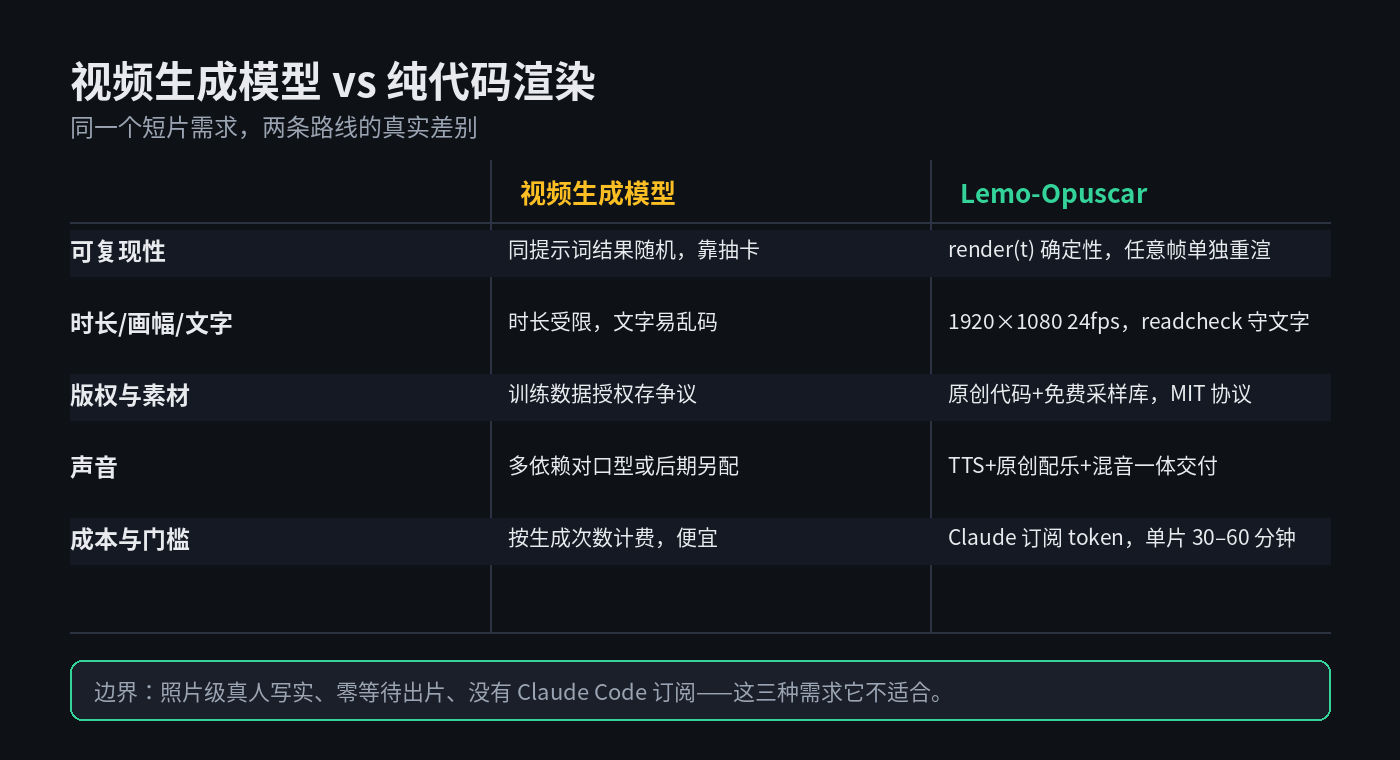
我的判断,分三类人:
现在就值得装的:要做系列化、品牌化短片的开发者和内容团队——风格资产沉淀成代码后,第二部片的边际成本和一致性是生成模型给不了的;做产品讲解、数据叙事、发布会片头这类「文字必须精确」的内容;以及想把「AI 编程 agent 的能力边界」看个明白的人——这个仓库本身就是 Agent Skill 设计的教科书:分发靠 plugin marketplace,能力靠 markdown 指南注入,共享工具稀疏检出,用户产物零署名。
应该再等等的:要照片级真人写实的,代码渲染的强项是风格化而非拟真;没有 Claude Code 订阅、对 token 成本敏感的(作者明确说风格是按 Claude Opus 5.5 调的,换其他模型不保证同样效果);期望十秒出片的,30–60 分钟的渲染和它那套质检门槛是一体两面。
一个需要自己验证的点:样片水平有目共睹(在线图鉴在 lemomo-ai.github.io/lemo-opuscar,含《OPUSCAR 98》98 种画风全公开:2D 77 部、2.5D 4 部、3D 17 部,每部都附可直接拿走的风格提示词和镜头编排),但样片是作者本人与 Opus 5.5 反复磨合的结果;普通用户用自己的题材第一次做片能达到几成,README 没有承诺,这也是我建议先用短题材试一支再决定投入的原因。
最后
Lemo-Opuscar 最有意思的地方,不是「又一个 AI 视频工具」,而是它重新划分了创作链路:人负责故事和审美决策,agent 负责把导演手册、摄影棚和 43 份美术宪法执行成像素、波形和时间码。 视频生成模型赌的是模型一次想对你要什么;这套体系赌的是——可复现的工程协议加上明确的创作规范,能把质量从玄学变成流程。在人人都在卷「一键生成」的 2026 年,反方向走一步,反而可能走得更远。
项目地址(MIT 协议):https://github.com/lemomo-ai/lemo-opuscar