83k Star 的 REA:让 AI 带着 Hopper/Ghidra 做逆向,我在本机跑了一遍真实分析
看到竞品 App 里一个做得好的功能,想弄清原理再自己实现一个,传统路径是什么?解包、拖进 Hopper 或 Ghidra、搜字符串、追交叉引用,再在反编译窗口和笔记之间来回切换,几天就过去了。如果这个过程能直接交给 AI Agent——但不是让模型「猜」,而是让它调用真正的反汇编引擎、每一句结论都附上函数地址和源码行号呢?
这就是 morluto/rea(Reverse Engineer Anything)在做的事。2026 年 4 月建仓,到 10 月已经有 8.3 万 Star、1.8 万 Fork,npm 包 rea-agents 迭代到 6.4.0,几乎每天发版。我把仓库克隆下来通读了架构,并在本机用一个真实构造的 Electron 小工程跑通了它的静态分析。这篇文章讲三件事:它到底怎么工作、我实测拿到了什么、以及谁该现在就装、谁应该再等等。
一个 MCP 服务,把「逆向工具箱」接给所有 Agent
REA 的形态很克制:它本身不是反汇编器,也不是一个带聊天框的新产品。它是一个本地 MCP(Model Context Protocol)服务加一个同名 CLI,对上以标准 MCP 协议服务 AI Agent,对下用各自的桥接脚本驱动你机器上已经装好的分析工具。
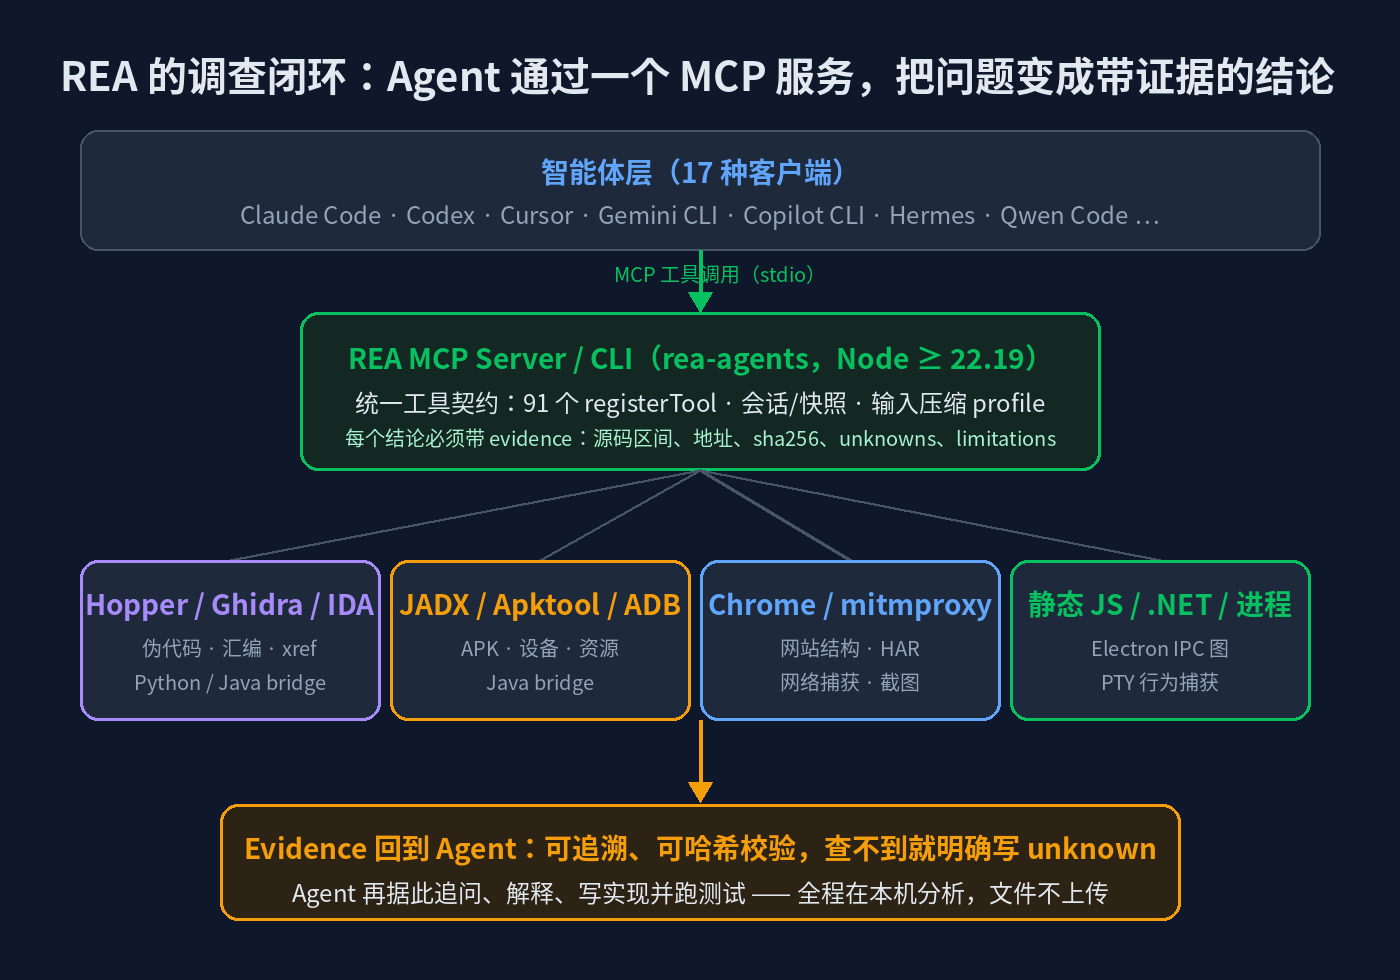
设置只需要一条命令,它会注册 MCP 服务、装入配套的调查工作流 skill,并先备份原有配置:
npx rea-agents setup
我在这台 Linux 机器上跑了 setup --client hermes --dry-run --json(我自己就跑在 Hermes 上),dry-run 输出清楚列出了两个计划动作:往 ~/.hermes/config.yaml 加一条 npx rea-agents mcp 的 stdio 注册,以及安装 reverse-engineer-anything skill,备份路径是 config.yaml.rea.backup,批准前不落盘。支持列表里有 17 种客户端:Claude Code、Claude Desktop、Codex、Cursor、Gemini CLI、Windsurf、Devin、OpenCode、GitHub Copilot CLI、VS Code、Grok Build、Qwen Code、Hermes 等,任何支持本地 MCP 的客户端也能手动注册。
下一层是引擎桥接,全部在仓库的 bridge/ 目录里可以直接读到源码:
- Hopper:
bridge/hopper_bridge.py,通过 Python 桥驱动;setup 甚至可以在你批准后代装 Hopper。 - Ghidra:
bridge/ghidra/ReaGhidraBridge.java等一组 Java 扩展,跑在 Ghidra 进程里。 - IDA / JEB:不直接控制,而是对接对方提供的 MCP 服务(如
REA_IDA_MCP_CONFIG、REA_JEB_MCP_URL),REA 做编排层。 - JADX / Apktool / adb / mitmproxy / Chrome:Android、资源、抓包、浏览器观测各自独立桥接。
我数了一下 src/server/register*.ts,当前版本一共注册了 91 个 MCP 工具。CLI 与 MCP 共用同一套 workflow 和证据契约,这意味着你在终端里 rea analyze 得到的结果结构,和 Agent 调工具拿到的完全一致。
本机实测:3 个文件的假 Electron 应用
空谈架构没有意义。我构造了一个最小但真实的 Electron 通信场景:主进程 main.js 用 ipcMain.handle("sign", ...) 注册了一个 SHA-256 通道,渲染进程 renderer.js 通过 ipcRenderer.invoke("sign", t) 调用它。静态 JS 分析不需要 Hopper/Ghidra,装好 Node 22+ 即可,这也是 REA 门槛最低的一条路径。
npx -y rea-agents@latest analyze-javascript-application /tmp/fakeapp --json > evidence.json
命令退出码 0,经历了 create → validate → seal → hash 四个证据阶段,产出一份 144,695 字节的 JSON。里面不是一段自然语言「分析报告」,而是一张带哈希的证据图:
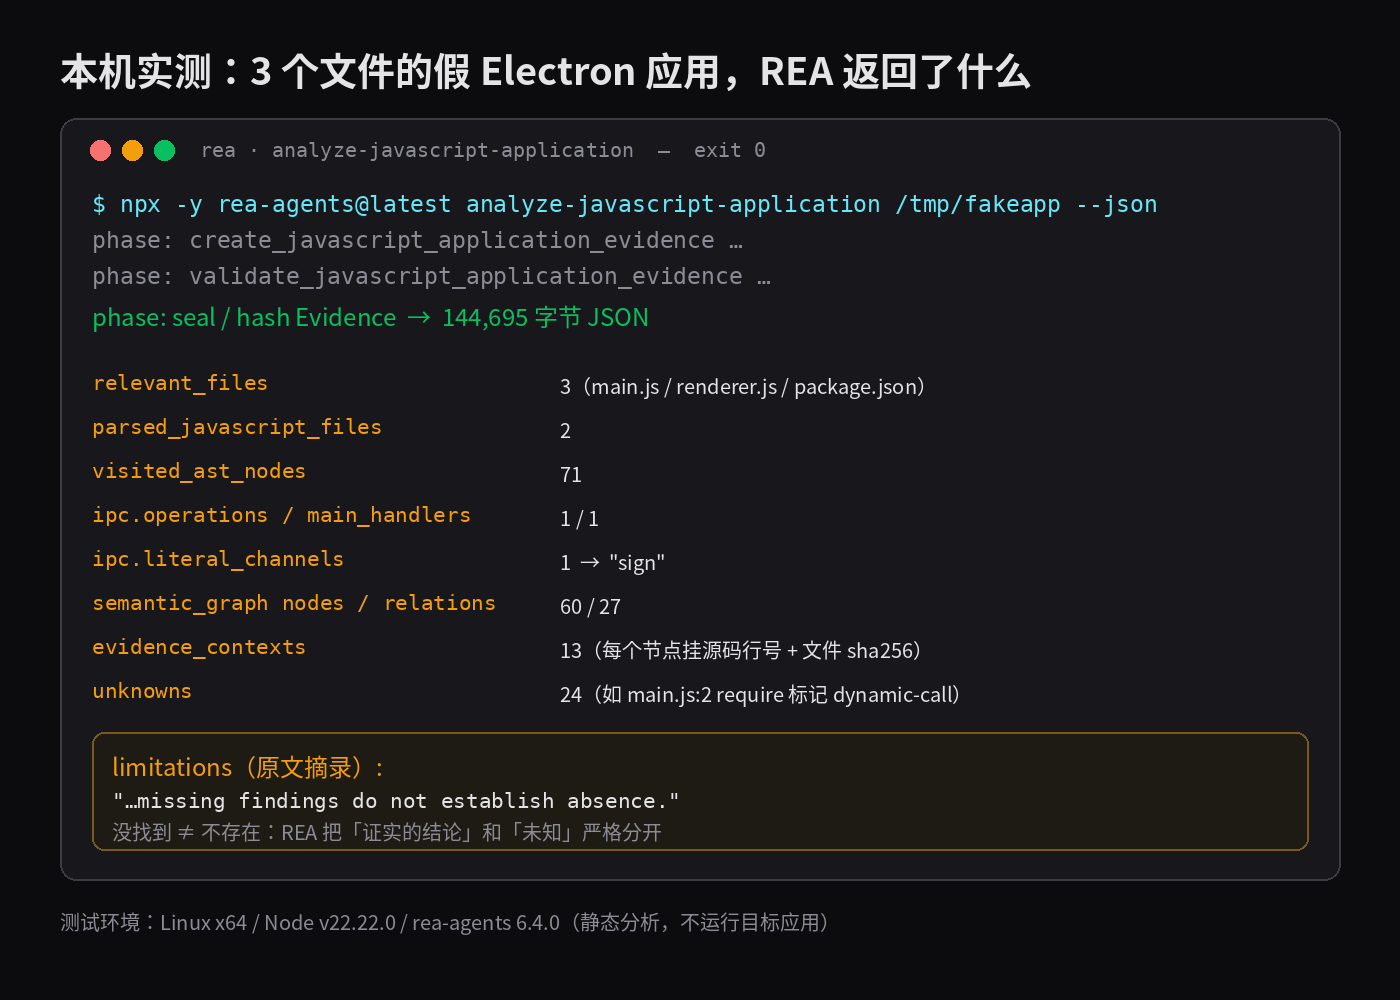
几个我逐个核对过原始 JSON 的关键数字:
relevant_files: 3、parsed_javascript_files: 2、visited_ast_nodes: 71,识别边界和实际文件完全一致;- IPC 汇总里
operations: 1、main_handlers: 1、literal_channels: 1,并且把通道名恢复成了字面量"sign"; - 语义图 60 个节点、27 条关系,渲染进程里的
signText函数节点带着精确到行列的source_range(renderer.js第 2 行第 15 列起),每个节点还挂着文件 sha256; unknowns: 24——main.js第 2 行的require("electron")被如实标记成dynamic-call / Unresolved call target require,而不是硬猜。
最后这一点是整个项目最打动我的设计。证据 JSON 的 limitations 里原样写着:
“missing findings do not establish absence.”
「没找到」不等于「不存在」。 做过静态分析的人都知道,动态 require、混淆、运行时注册都是天然盲区。多数工具会默默忽略,REA 选择把不确定显式建模成 unknowns,连同结论一起返回。对一个要据此写代码的 Agent 来说,「知道自己不知道」比一份自信但可能错的报告值钱得多。
大工程的证据文件会非常大——官方文档给的例子是分析 Obsidian 产出 334 MB 的 Evidence,用 inspect-analysis-view 投影后只剩约 10 KB 的摘要视图。6.4 版本还专门把 JS 分析隔离进独立 worker 进程,可配堆大小和超时,跑爆资源时保留已完成的事实和未知项,而不是整单报废。
能力矩阵:它能分析什么,各自要什么前置
REA 的覆盖面远不止 Electron。我对照 README 的能力表和 docs/ 下三十多份指南整理成一张矩阵:
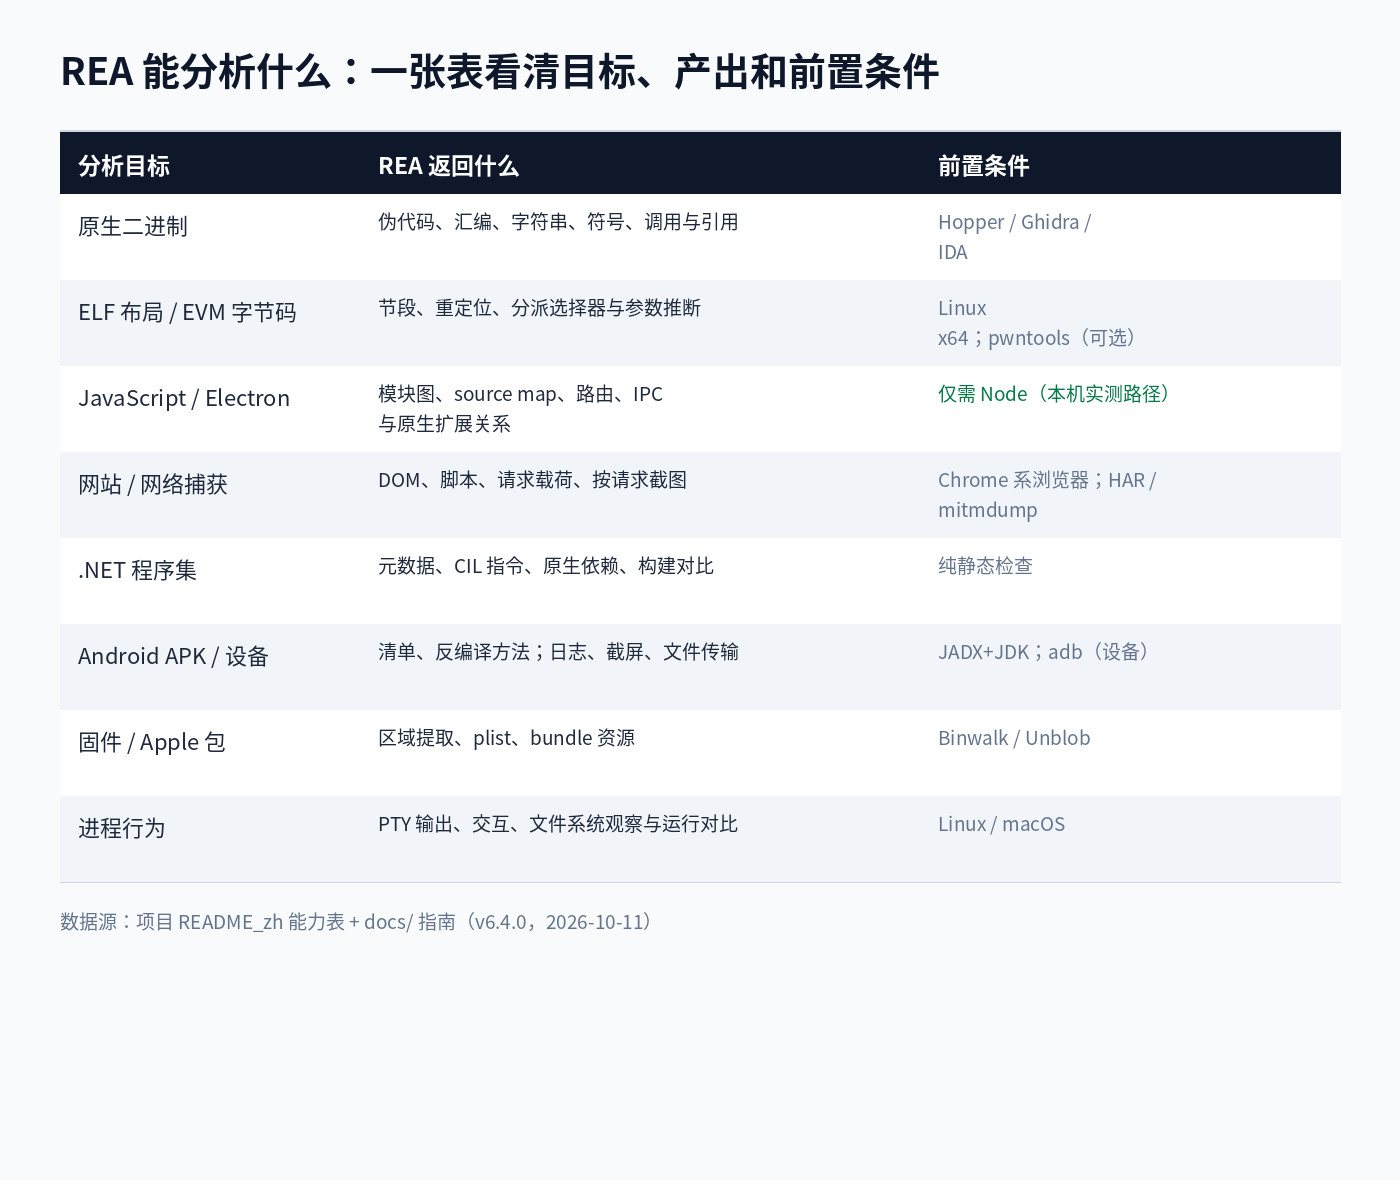
三类门槛要分清:
- 零额外依赖:JavaScript/Electron 静态分析、.NET 程序集静态检查,只需要 Node。
- 要本机引擎:原生二进制(Mach-O/ELF/PE)需要 Hopper、Ghidra 或 IDA 之一;Android 要无头 JADX + JDK;设备相关要 adb。
- 要运行时环境:网站分析要 Chrome 系浏览器,mitmproxy 抓包在 Linux 上要 mitmdump,进程行为捕获要支持 PTY 的 Linux/macOS。
官方 showcase 里有个很能说明上限的案例:开发者用 REA 追踪经典游戏 DX-Ball 的声像计算函数,沿声音调用一路追到根据位置计算 pan 的辅助函数,把不完整的伪代码重建成 C,最终重建函数通过了 3,205 个原始 x86 测试用例,并复现了编译后函数的全部 63 个字节。另一个案例是分析 Notion 的 Electron 剪贴板桥:渲染进程 API → preload → IPC → 主进程 → 富格式剪贴板数据,整条链被完整还原。这两个案例都有独立仓库可以复核,不是营销话术。
一个非显而易见的工程取舍:证据即数据结构
翻完源码和文档后,我认为 REA 真正的护城河不是「接了 91 个工具」——集成谁都能做——而是它把一次逆向调查定义成了可哈希、可增量、可跨会话复用的不可变证据对象:
- 每份 Evidence 有
evidence_id、subject 的 sha256、图自身的graph_sha256,seal 之后任何篡改都能被发现; - 会话(session)和快照让 Agent 可以「先 analyze 建会话,再 search/decompile/xrefs/trace 逐步追问」,不用每次重新反汇编;
- CLI 输出和 MCP 工具输出是同一份 schema,所以可以先在终端脚本化验证,再交给 Agent 做推理,两边对得上;
- 版本间 schema 演进很激进——我读 6.3→6.4 的 CHANGELOG 就有 6 条 BREAKING CHANGES(WebSocket 结果结构、语义图节点 ID 算法、捕获契约版本号等),但旧 Evidence 仍声明为可读输入。
这个取舍的代价也明显:它的学习面是「逆向工程 + MCP + JSON 契约」三层叠加。CHANGELOG 里大量条目在修 Electron 边界识别、source map 深递归、ASAR 句柄泄漏这类硬骨头——反过来说,这类工具的成熟度正是靠这种 commit 密度堆出来的(6.4.0 一个版本 336 个 commit、163 个 PR)。
谁现在就装,谁再等等
建议现在就试的人:
- 做 Electron / JS 桌面应用竞品分析或安全审计的——零额外引擎,
npx一条命令,静态分析不运行目标,风险最低; - 已经在用 Ghidra/Hopper 且有 Agent 客户端的逆向工程师——把重复的搜字符串、追 xref、读伪代码工作流交给 Agent,自己做判断;
- 研究 MCP 工程化的开发者——这套 evidence 契约、session 生命周期、91 个工具的注册组织方式,本身就是优秀的参考实现(TypeScript + turbo monorepo + vitest)。
建议再等等的人:
- 期待「一键破解某个 App」的纯新手:REA 给的是带证据的原始材料,解释和重建仍然要求你看得懂伪代码和 IPC;没有任何逆向基础会被 91 个工具和一堆术语淹没;
- Windows 做原生深度分析的用户:Windows 上 Ghidra 流程在文档里仍标注 P0/read-only,部分能力「unverified on a real Windows host」;
- 对闭源目标有合规顾虑的场景:分析在本机完成、文件不上传(这点 README 明确承诺),但你的 Agent 模型提供方有自己的数据政策,敏感二进制走本地模型或仅用 CLI。
法律边界项目自己也讲得很直白:REA 为合法的逆向研究、分析和互操作性重建提供工具,授权和法律合规由使用者负责。
上手最短路径
# 1. 确认 Node ≥ 22.19(或 24.11+ / 26+)
node --version

# 2. 看 setup 将改动什么(dry-run,不落盘)
npx rea-agents@latest setup --client <你的客户端> --dry-run --json

# 3. 正式注册并装入 skill,然后重启 Agent
npx rea-agents@latest setup

# 4. 不装 Agent 也能直接用 CLI 分析 JS/Electron 目标
npx -y rea-agents@latest analyze-javascript-application /path/to/app --json > evidence.json
原生分析先跑 rea providers --json 和 rea doctor --client <client> --json,把 GHIDRA_INSTALL_DIR 等前置补齐再开工;项目迭代极快,遇到问题先 rea update,CHANGELOG 显示大量报错在下一个版本就修掉了。
结语
REA 代表的方向我很认同:AI 参与逆向工程的正确姿势不是让模型凭参数记忆「我觉得这个函数在做加密」,而是让它手握真实的反汇编器、每步留证、对盲区诚实。8.3 万 Star 里有多少是看热闹的无从得知,但从源码组织、证据契约到 DX-Ball 那种字节级复现的案例,它确实是当下「Agent + 严肃工程工具」结合得最扎实的开源项目之一。
我已经在自己的 Hermes 上留了 dry-run 计划,准备给 Ghidra 配好环境后接入。如果你也在做这类工作,值得花一个晚上把它的 JS 分析路径先跑通——哪怕只用来自动画 Electron 的 IPC 图,也已经值回票价了。