别再复制粘贴了:开源社媒运营 Agent Easel,从追热点到发布全包
一个人做社媒,最耗人的从来不是"写一条文案"。
打开热搜找选题、评估哪个话题和自己账号匹配、想标题、写正文、做图、剪视频、按每个平台的规则改格式、登录一个个账号发布、第二天再回去看数据……这条链路里,真正的创作只占一小部分,剩下的全是切换、复制粘贴和重复交代背景。
通用 AI 助手帮不上太多:你问它"这条文案怎么改",它能给出一段文字,但它不认识你的账号、不记得你的风格,更不可能登录平台帮你把内容发出去。最近浙江大学 ZJU-REAL 实验室(联合北京大学 OpenDCAI 实验室)开源的 Easel,想解决的就是这个问题——项目 8 月底上线,一个月左右在 GitHub 收获近 2000 Star。
Easel 是什么
Easel 自我定位是"你的私人、持续进化的社媒运营助手"。从工程上看,它是一个把四个东西接在一起的内容工作台:
- OpenClaw Agent——负责理解任务、调度技能、执行多步工作流的 Agent 运行时;
- 账号画像(profiles/)——每个账号一份独立档案,包含定位、风格、受众、平台、偏好红线、长期记忆六个维度;
- 114 个内容技能——发现、策划、图文、音视频、发布、归因,每个技能都是一份
SKILL.md加可运行脚本,而不是功能清单上的摆设; - React Web 工作台——会话、素材、账号、画像、内容库、发布中心统一管理,默认跑在
localhost:7860。
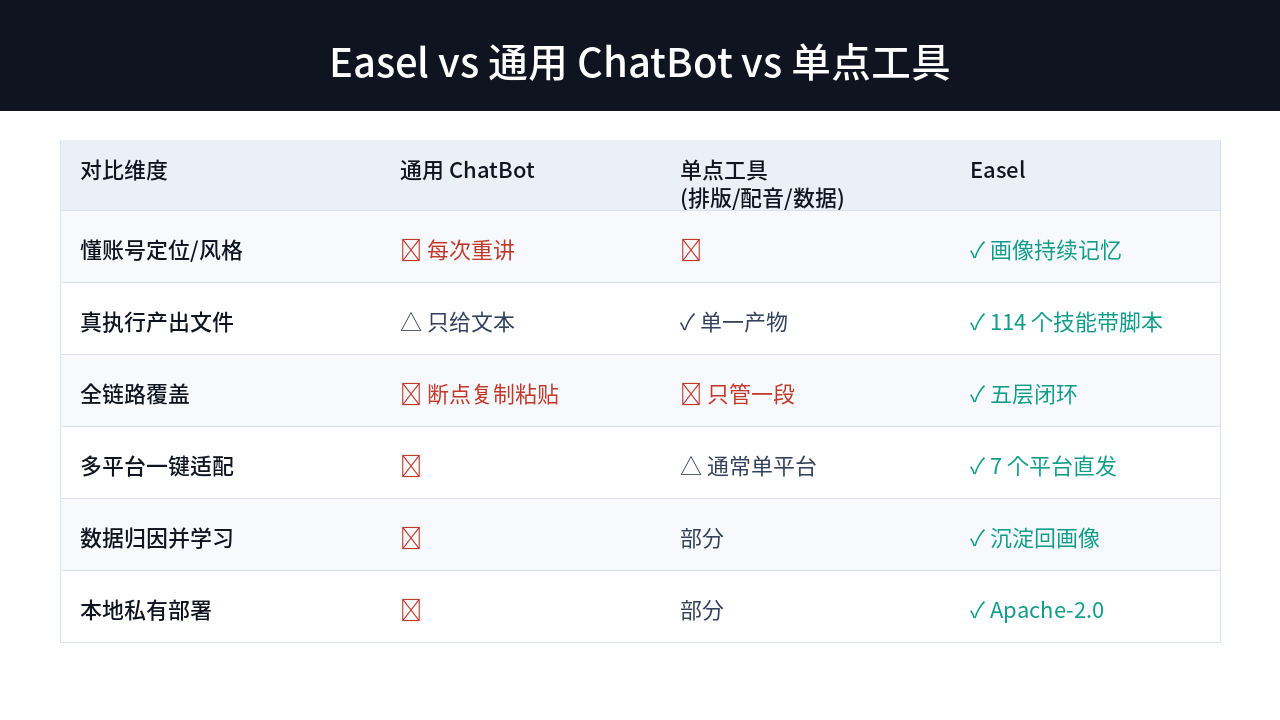
关键区别在于:通用 ChatBot 是"顾问",只告诉你应该怎么做;Easel 是"搭档",直接把内容做出来、写入 outputs/ 目录、登录平台发出去,再把发布后的数据带回来。
五层工作流:一个 Agent 贯穿全链路
Easel 把社媒运营拆成五个连续阶段,由同一个 Agent 带着同一份画像从头走到尾。
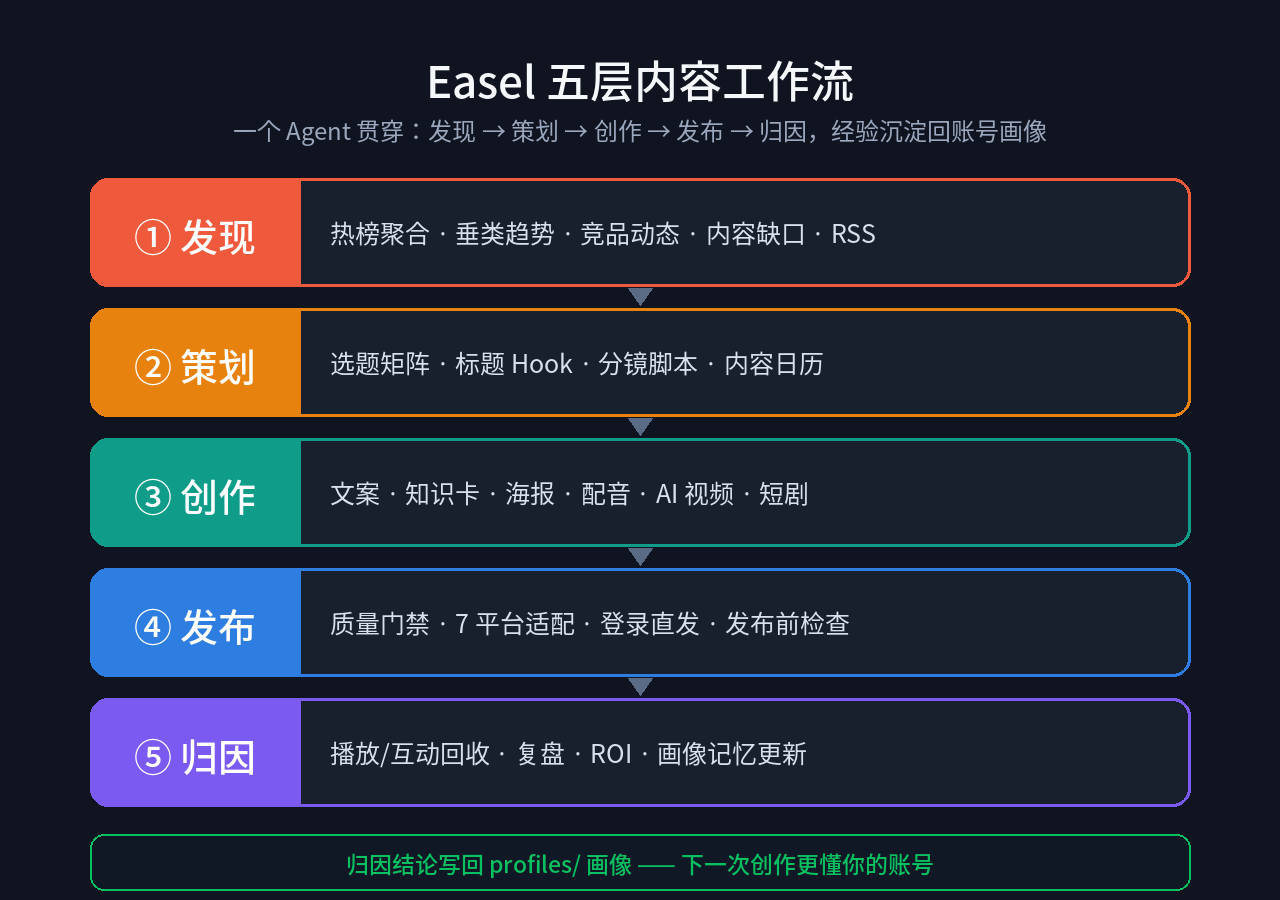
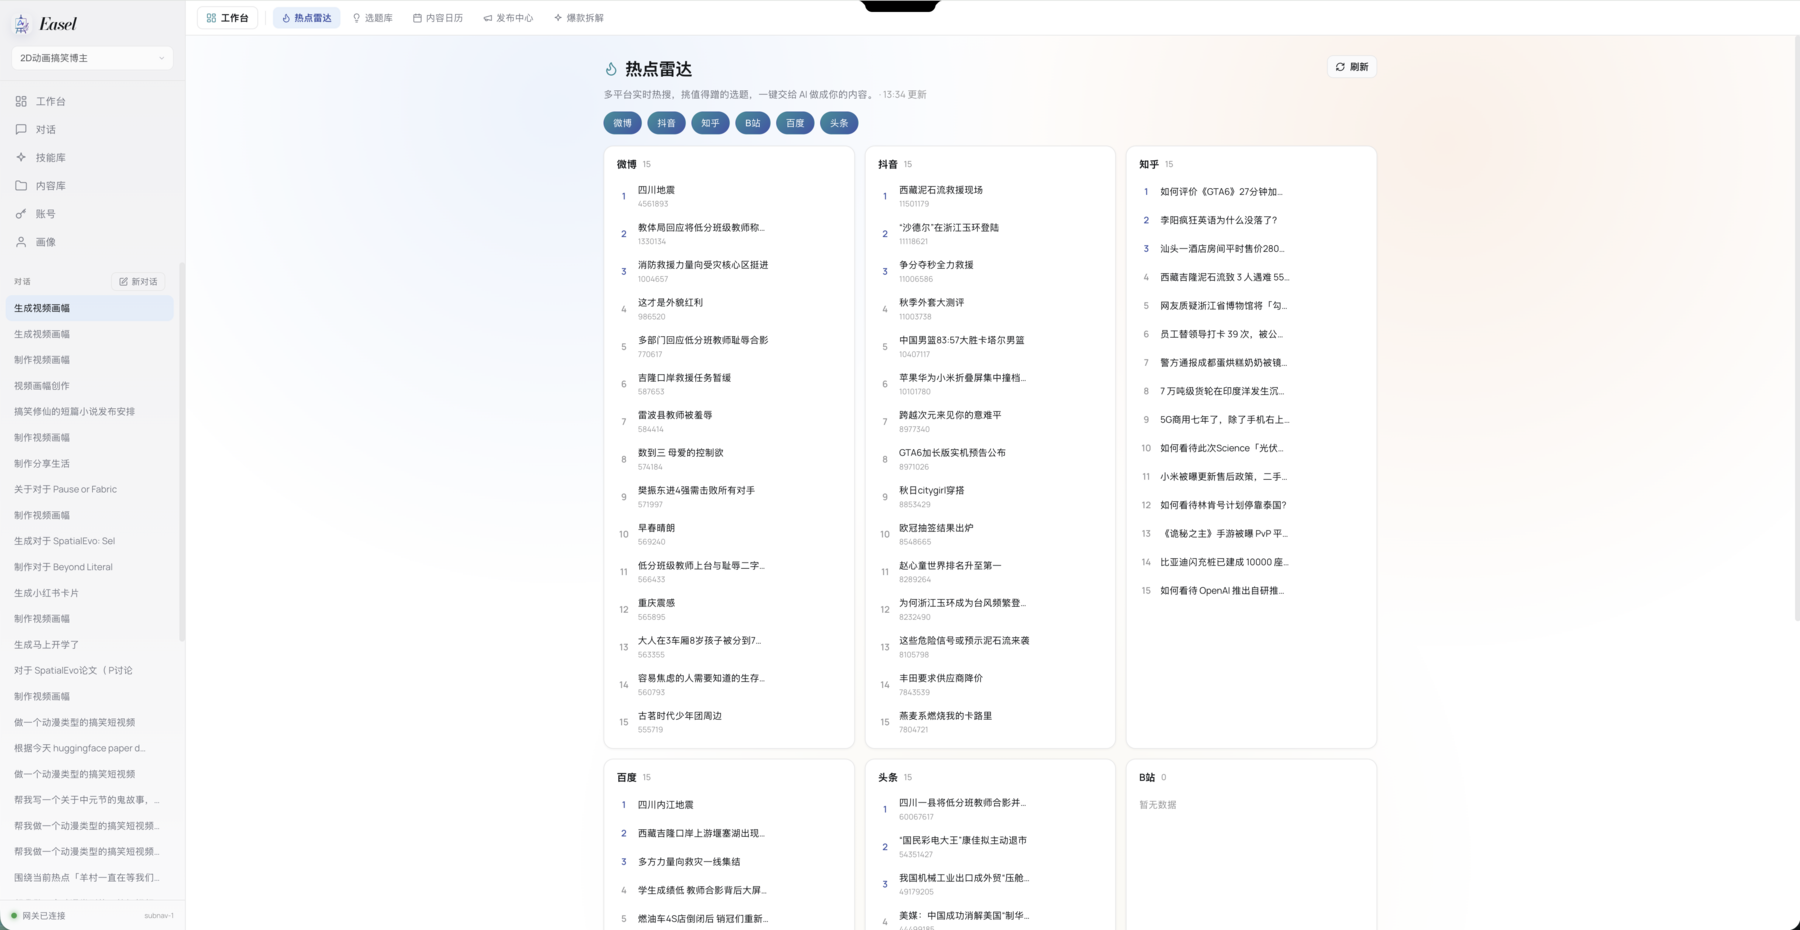
- 发现:聚合微博、抖音、知乎、B 站、百度、头条等平台热榜,叠加垂类趋势研究、竞品分析、内容缺口分析和 RSS,筛选真正适合当前账号的机会,而不是把热搜原样塞给你。
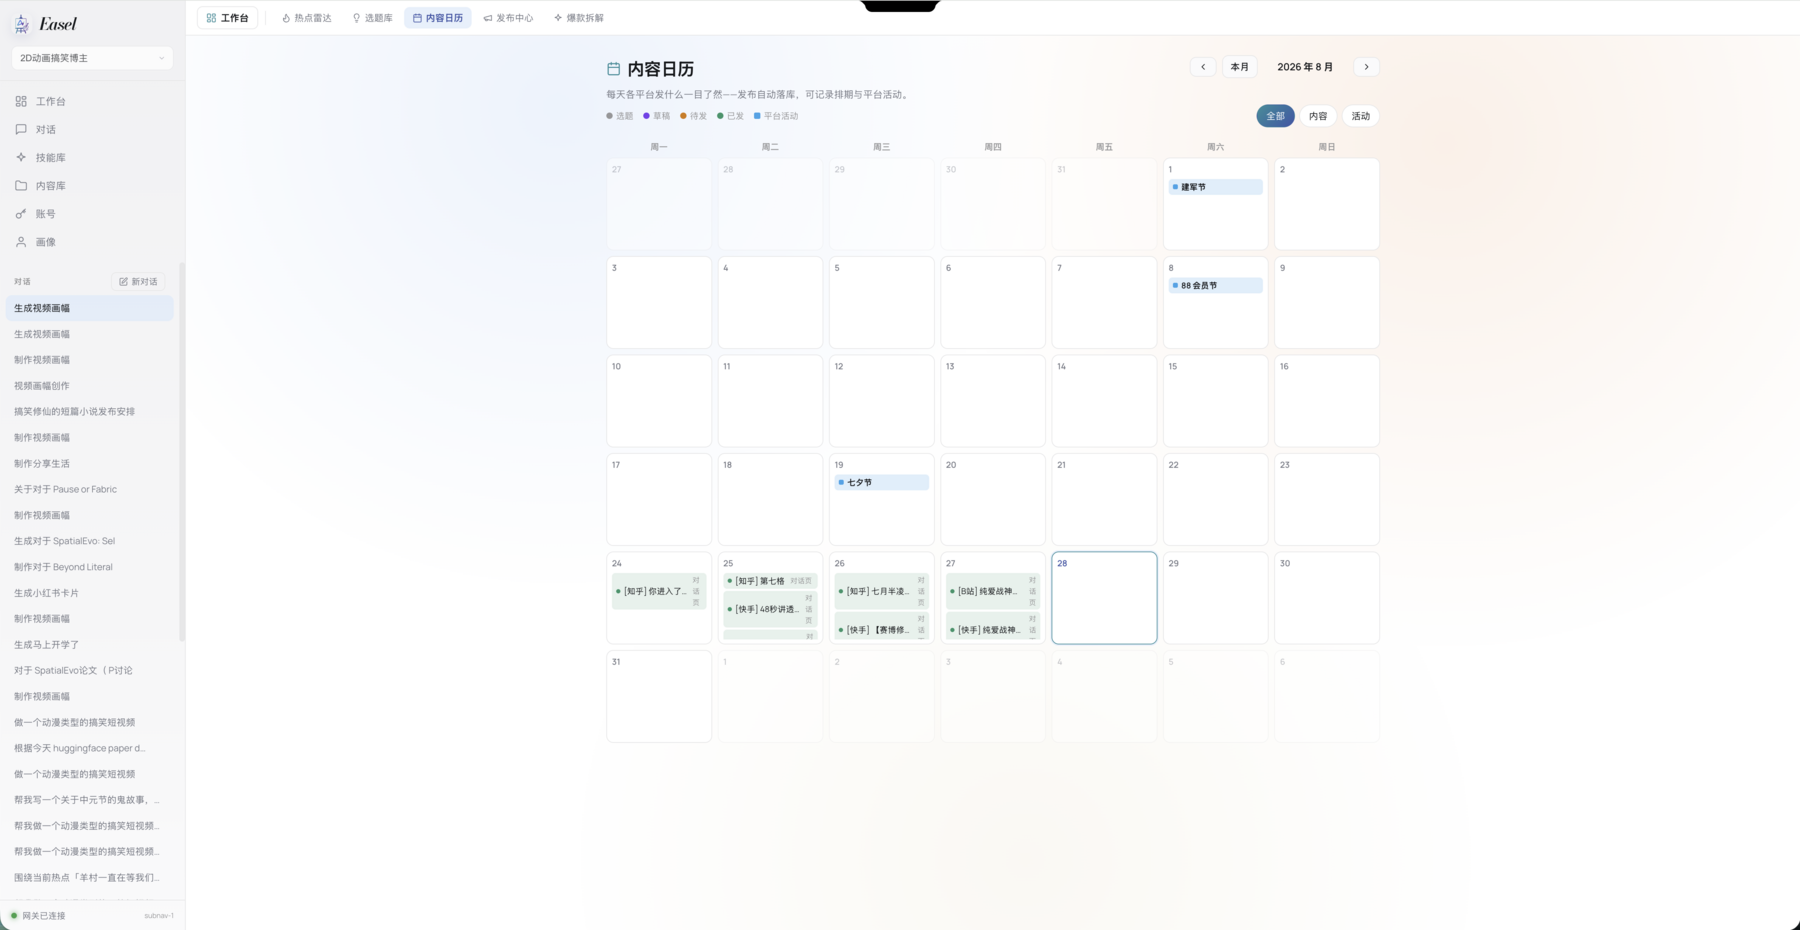
- 策划:把机会变成选题矩阵、标题 Hook、分镜脚本和内容日历,支持系列规划、直播策划和商单方案。
- 创作:社媒文案、小红书笔记、长文、小说、知识卡、海报、信息图、数据图表,以及配音、AI 音乐、AI 视频、AI 短剧、字幕剪辑等音视频内容。
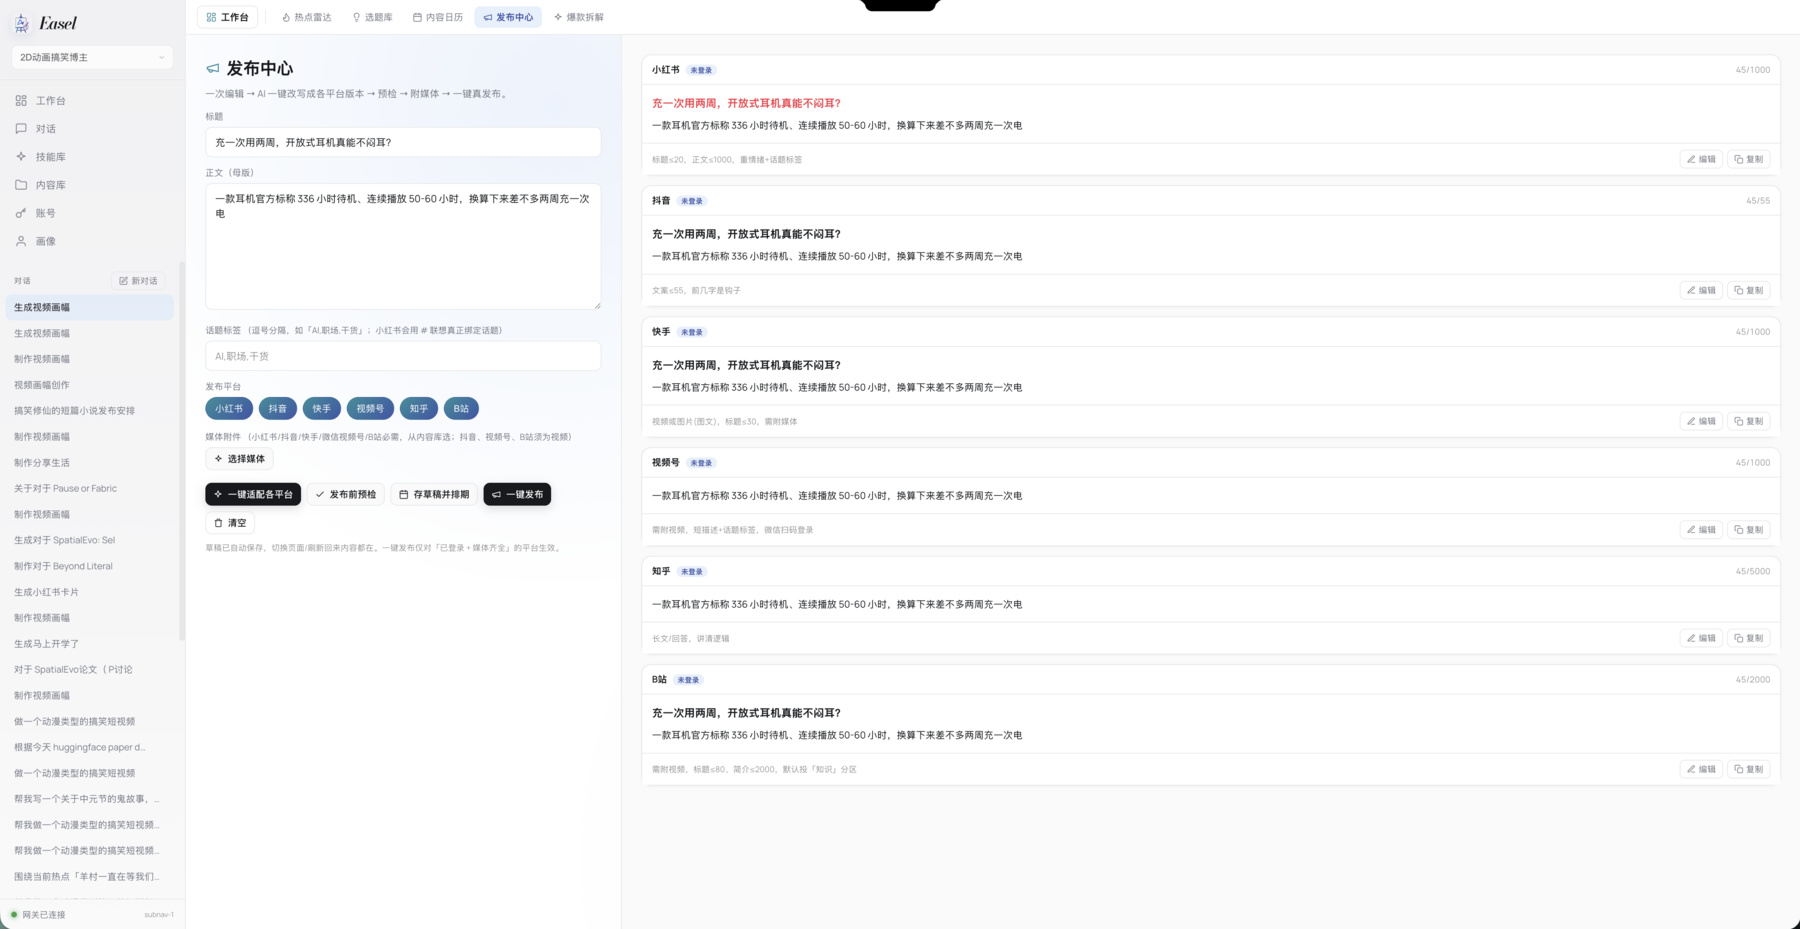
- 发布:先过质量门禁(敏感与版权风险检查、平台 SEO、发布 Checklist),再按平台适配标题、画幅和媒体要求,分发到已登录账号。
- 归因:回收播放、互动、评论数据,做复盘和 ROI 分析,把"什么结构有效"沉淀回账号画像,供下一次创作使用。
闭环里最值得注意的是最后一步——归因结论会写回 profiles/<账号名>/memory.md。这意味着 Agent 的输出会随账号运营时间变得越来越贴合,而不是每次从零开始。
真实界面长什么样
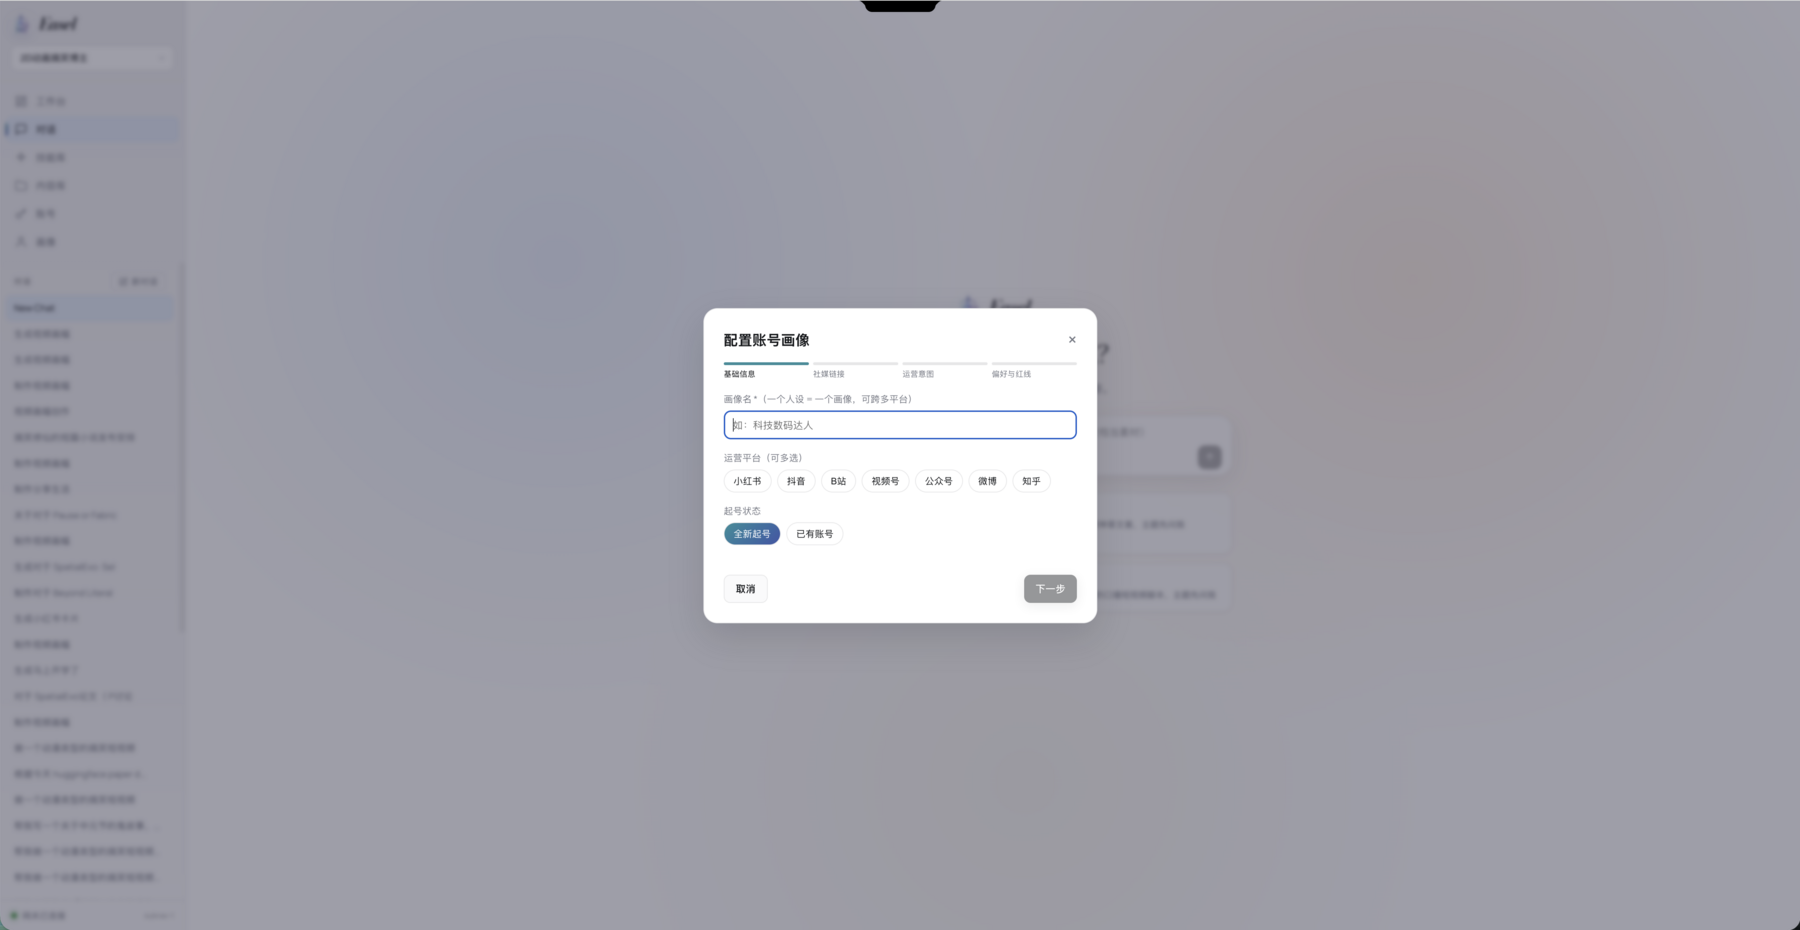
账号画像:一个画像对应 profiles/ 下的一个目录,六个维度都可以在 Web 页面直接编辑,同一画像能跨多个平台和会话使用。
热点雷达:多平台热榜聚合,Agent 基于当前画像筛选选题,而不是无差别投喂。
内容日历:统一管理选题、草稿、待发、已发状态,结合节日节点排期。
发布中心:一份母版内容生成多平台版本,集中完成格式适配、附件管理、发布前检查和真实发布。
十分钟跑起来
环境要求:Linux、macOS 或 Windows 10/11,Python 3.10+、git;安装向导会检查 Node.js 22.19+、FFmpeg、Playwright/Chromium,缺什么给出引导。
git clone https://github.com/ZJU-REAL/Easel.git
cd Easel
bash setup.sh
Windows 原生环境(不需要 WSL)在 PowerShell 里执行:
git clone https://github.com/ZJU-REAL/Easel.git
cd Easel
Set-ExecutionPolicy -Scope Process Bypass
.\setup.ps1
setup.sh 是引导式、可重复运行的:创建项目内 .venv、安装或复用 OpenClaw 并使用独立的 easel profile(不会动你已有的 ~/.openclaw/)、装齐 Python/Node 依赖、构建 React 前端、安装 Chromium,最后引导配置 LLM。完成后:
source .venv/bin/activate
easel doctor          # 检查环境
easel ping            # 实测 gateway 与 Agent 连通
easel web             # 启动工作台,访问 http://localhost:7860
最小配置只需要一个可用的 LLM,在根目录 .env 里提供即可,Anthropic、OpenAI 或任意 OpenAI-compatible / Anthropic-compatible 服务都支持:
ANTHROPIC_API_KEY=你的_API_Key
CLAUDE_MODEL=anthropic/claude-sonnet-4-6
如果只配置聊天模型、没有独立 Embedding 服务,Easel 会显式退化为关键词记忆检索,不会反复请求不可用的 embedding 端点——这个细节在同类项目里经常踩坑。
一个工程层面的观察
翻完源码和 CHANGELOG,Easel 真正有意思的设计不是"114 个技能"这个数字,而是两点:
第一,账号画像是一等公民。 大部分 AI 内容工具把"人设"塞进一句系统提示词,用完即弃;Easel 把画像做成磁盘上的结构化目录,且归因系统有权限回写它。这才让"持续进化"从口号变成数据结构。
第二,技能是真执行,不是 MOCK。 从 pyproject.toml 的依赖可以直接看到执行栈:Playwright(浏览器自动化登录发布)、biliup(B 站投稿)、faster-whisper(本地语音转写)、edge-tts(配音)、librosa/OpenCV(音视频处理)、rembg(去背)。CHANGELOG 里也都是带数字的实测记录,比如 Web 对话从常驻网关直连后端到端延迟从 7.6s 降到 4.5s、B 站发布后要回读 API 对账才算成功。对想学习"Agent 技能工程化"的开发者来说,这个仓库本身就是一份参考实现。
谁该用,谁先等等
适合上手:
- 同时运营多个平台、被重复适配和搬运消耗大量时间的创作者或小团队;
- 想用本地私有部署、不愿把账号数据交给 SaaS 的人(Apache-2.0 协议);
- 研究 Agent / Skill 工程的开发者,114 个带脚本的技能是很实在的学习样本。
建议先观望或注意:
- 只在手机上随手发内容的用户——Easel 是一套本地工作台,有部署和配模型的成本;
- 小红书自动发布要谨慎,官方明确提示平台可能检测自动化操作,存在验证、限流甚至风控风险,建议用预览+检查后手动确认发布;
- AI 视频、音乐、云端配音等能力依赖第三方模型,重度使用会产生 API 费用,不过只配文本模型也不影响策划和图文创作;
- 项目还很年轻(v0.2.1),Windows 全链路兼容和安装简易化仍在 Roadmap 前两位。
项目地址:https://github.com/ZJU-REAL/Easel,产品主页:https://zju-real.github.io/Easel/。