别用 Sora 硬刚科普了:给个主题,这个开源 skill 用代码"画"出整条讲解视频
想做一条技术讲解视频,你大概会在三条路上反复纠结。
找 Sora、Veo、可灵这类视频生成模型:给一段提示词确实能出画面,但画面里出现的数字、机构、年份它可能随手就编,你也没法精确指定第三秒该显示什么;想改一帧?基本只能重抽。找数字人工具:一个虚拟主播站在那里念稿,机制讲不清楚,看两分钟就犯困。或者自己用 Manim、Remotion 一行行写——效果好,但一条五分钟的片子可能要磨上一两个礼拜。
最近在 GitHub 上看到一个思路很不一样的开源项目 anything2explainer。它是一个 Claude Code / Codex 的 skill:你给一个主题,它直接产出一条黑底 MG 风格的科普讲解视频,带配音、字幕和章节进度条,中文英文都行。最关键的是,画面全部由代码绘制,不用素材库、不用视频生成模型,也不使用任何现有视频的帧。项目 9 月 8 日上线,二十天左右拿到 2000 多 Star。
它到底是什么
先纠正一个预期:anything2explainer 不是一个你装好就能双击运行的 CLI。仓库里装的是一整套让 AI 编程 Agent 把片子做出来的方法:
- 一个可编译的 Remotion 模板工程(React + TypeScript);
- 一套图元与光效库(白线条图形、紫色重点、点阵波/星点幕底);
- 配音、分镜、渲染、量化质检的脚本工具;
- 风格规范、动效词表和多 Agent 分工协议;
- 一条完整样片作为质量标尺。
换句话说,它把"一个会做 MG 视频的资深团队"的工作流,编码成了 Agent 可以照着执行的文档和模板。你要做的只是在 Claude Code 或 Codex 里说一句:“讲一下向量数据库,做成一条讲解视频。”
九阶段流水线:多 Agent 并行,四个点等你确认
整个流程分九个阶段,最耗时的"写镜头"环节由多个构建 Agent 并行完成——一个镜头对应一个文件。
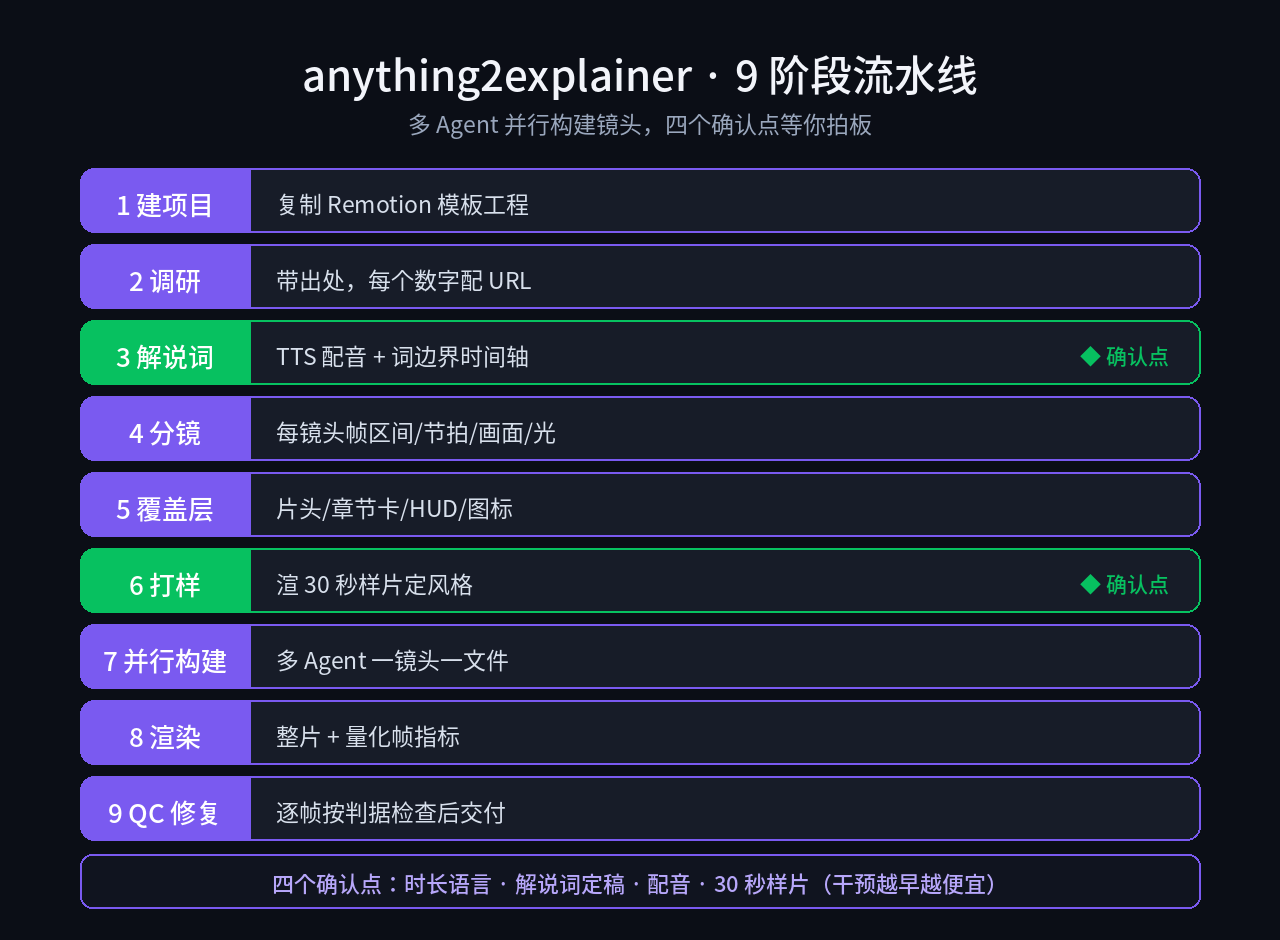
- 建项目:从模板复制出 Remotion 工程;
- 调研:一个 Agent 做带出处的调研,每个数字、年份、术语都配 URL;
- 解说词与时间轴:写文案、生成 TTS 配音,按词边界生成帧级时间轴;
- 分镜:每镜头一行,写清帧区间、节拍、画面、动效、主角和光;
- 覆盖层与图元:片头、章节卡、HUD、流程轨加主题图标;
- 打样:先渲 30 秒样片给你看风格;
- 并行构建:多个 Agent 各写 5–7 个镜头的纯函数组件;
- 渲染:整片渲染并跑量化帧指标;
- QC 与修复:每章一个 QC Agent 逐帧检查,修完复验再交付。
它不会闷头从头做到尾,而是在四处停下来等你拍板:时长与语言、解说词定稿、配音、前 30 秒样片。这个设计背后是一条很朴素的成本规律——解说词定稿是最便宜的干预点,因为定稿之后帧号会被每个镜头硬编码,改一个字就得全片重新对位;而 30 秒样片阶段改风格,代价只是一个构建组,整片渲完再改就是全部组。
真实成片长什么样
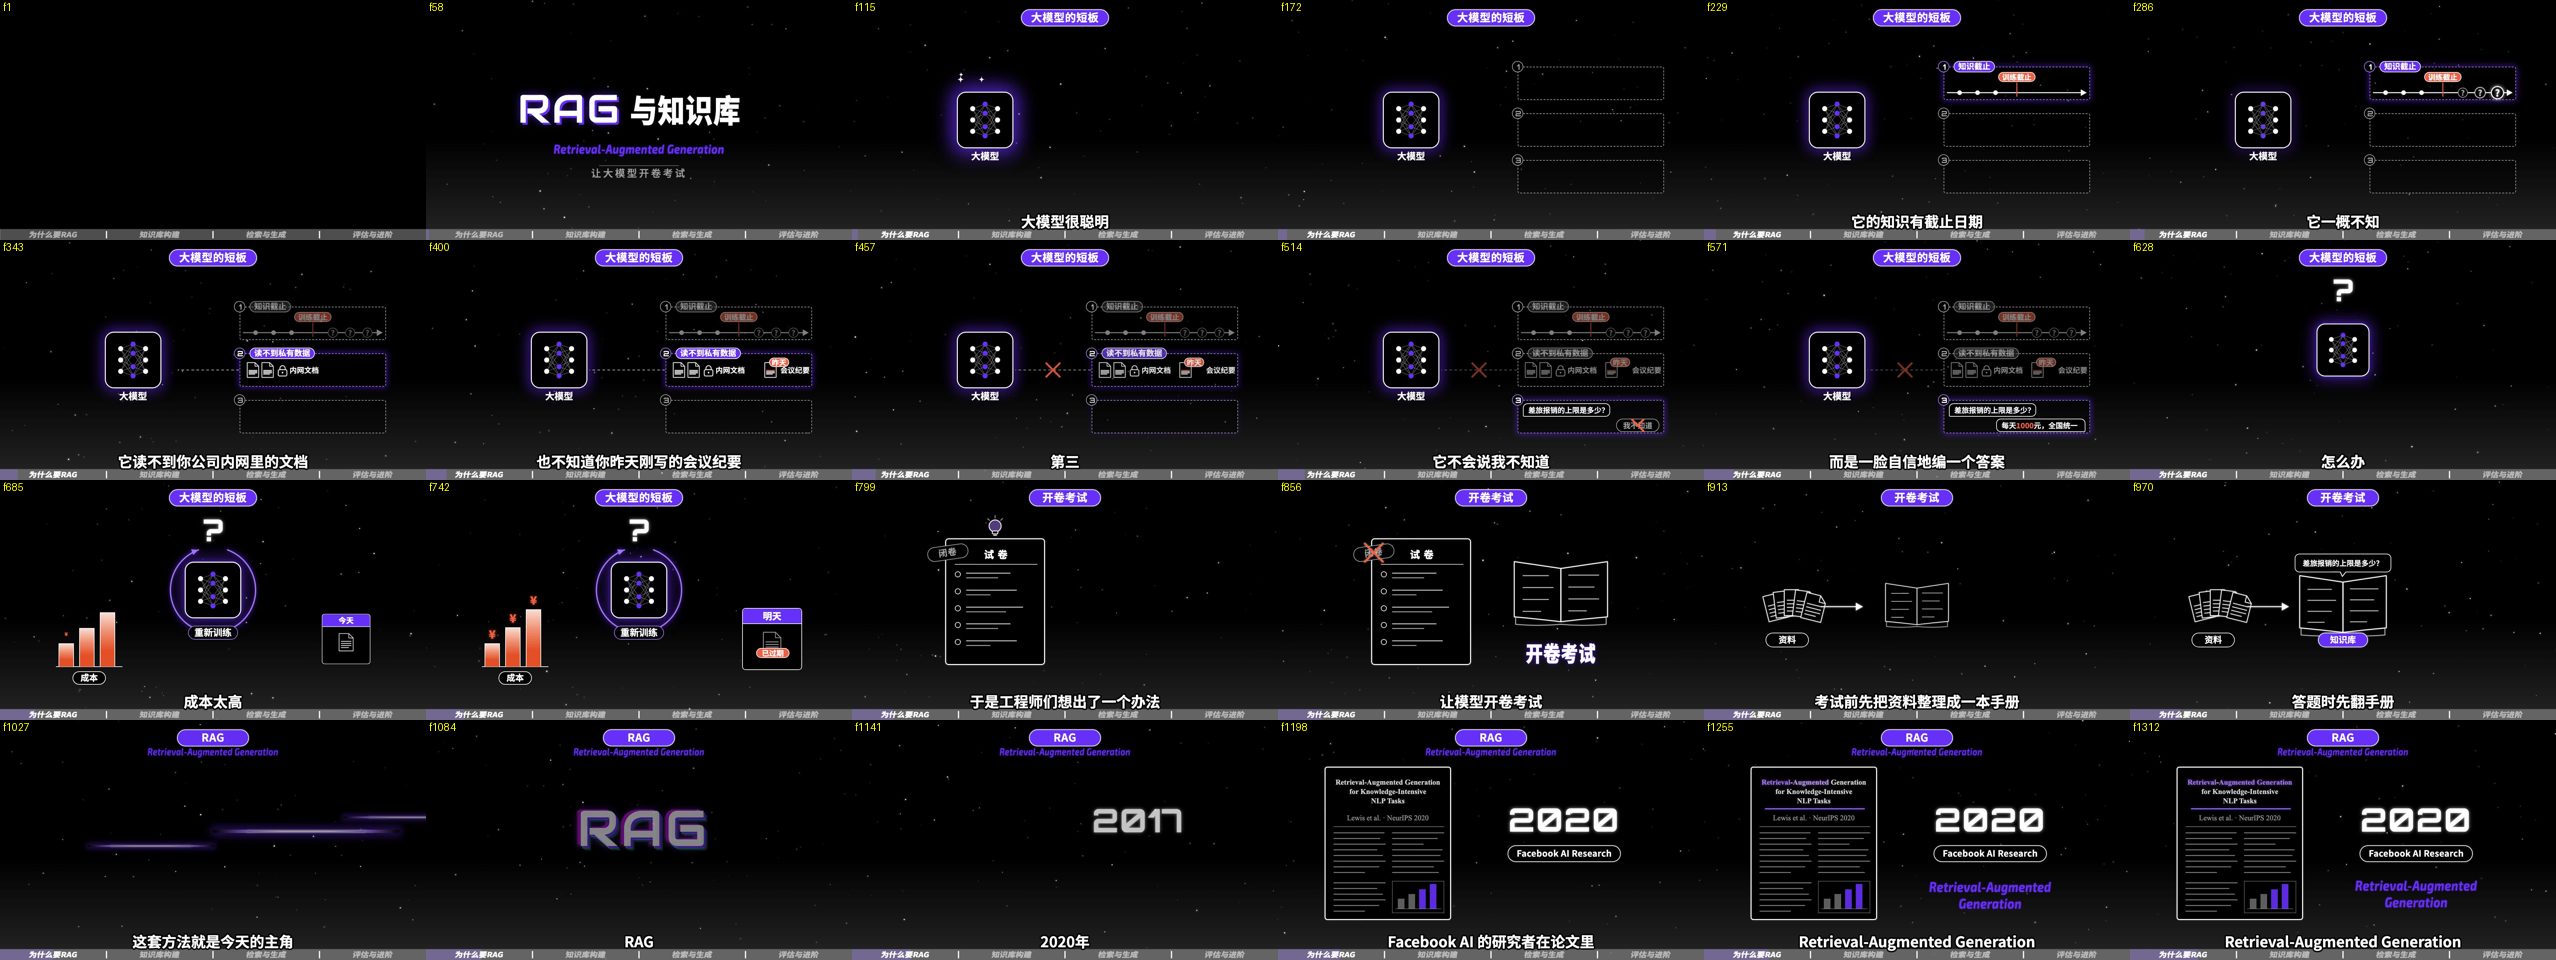
项目的质量标尺是一条《RAG 与知识库》样片:中文版 4 分 54 秒、44 个镜头、1490 字。下面这张帧拼图能直观看到它的画面语言——黑底、白线条、紫色重点、超粗黑体大字,动画随解说逐步添加元素,用"大模型开卷考试"这类比喻把检索增强生成讲清楚。
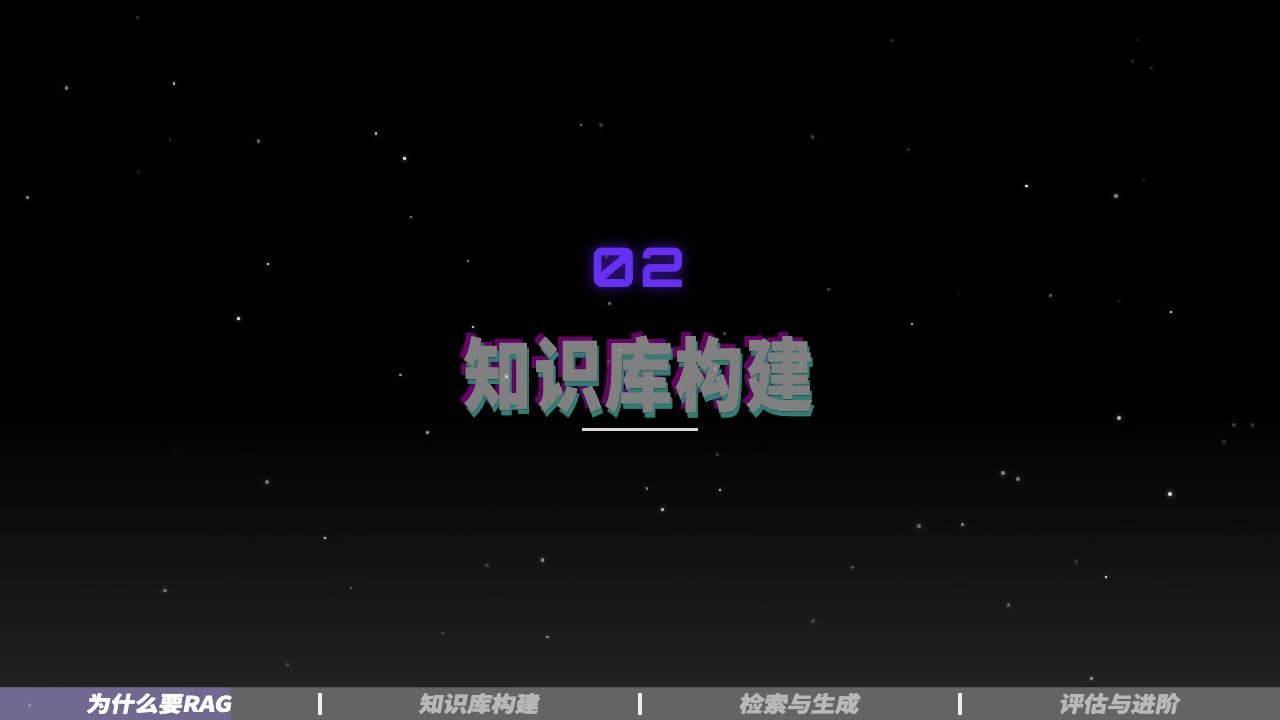
章节切换时会有专门的章节卡,底部常驻一条全片章节进度条,观众随时知道自己看到哪儿了。
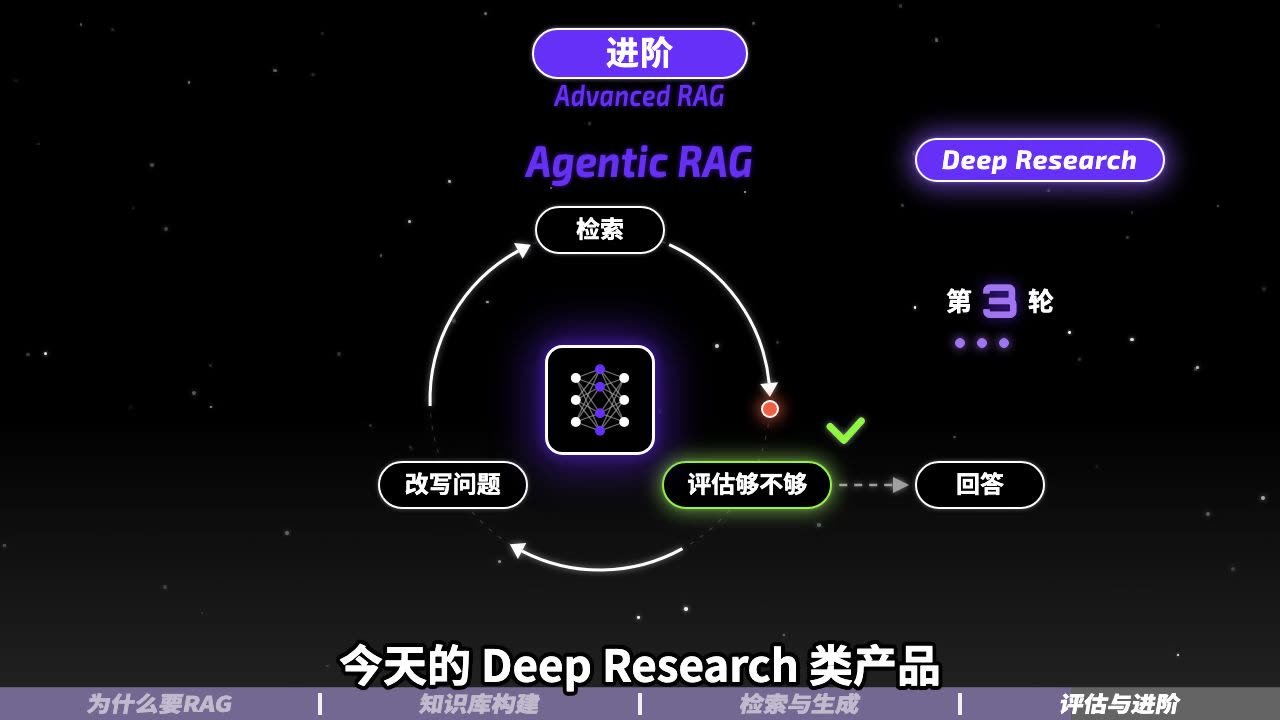
讲到具体机制时(比如 Agent 循环、GraphRAG),画面会用图形把流程画出来,而不是干念定义。
全套过程文件——从调研、解说词、分镜表、逐镜头源码到 QC 报告——都在仓库的 examples/rag/ 里,可以直接对照着学。
一个有意思的设计:用"正反例"约束审美
Agent 自动生成画面,最大的风险是"每个元素单看都对,凑在一起又乱又丑"。anything2explainer 的应对方式很工程化:在 examples/contrast/ 里放了 6 组正反例帧对照——主体该多大、大字该怎么出现、数字该放哪、背景该不该留空、结尾该怎么收,每组都给一个 good 和一个 bad。
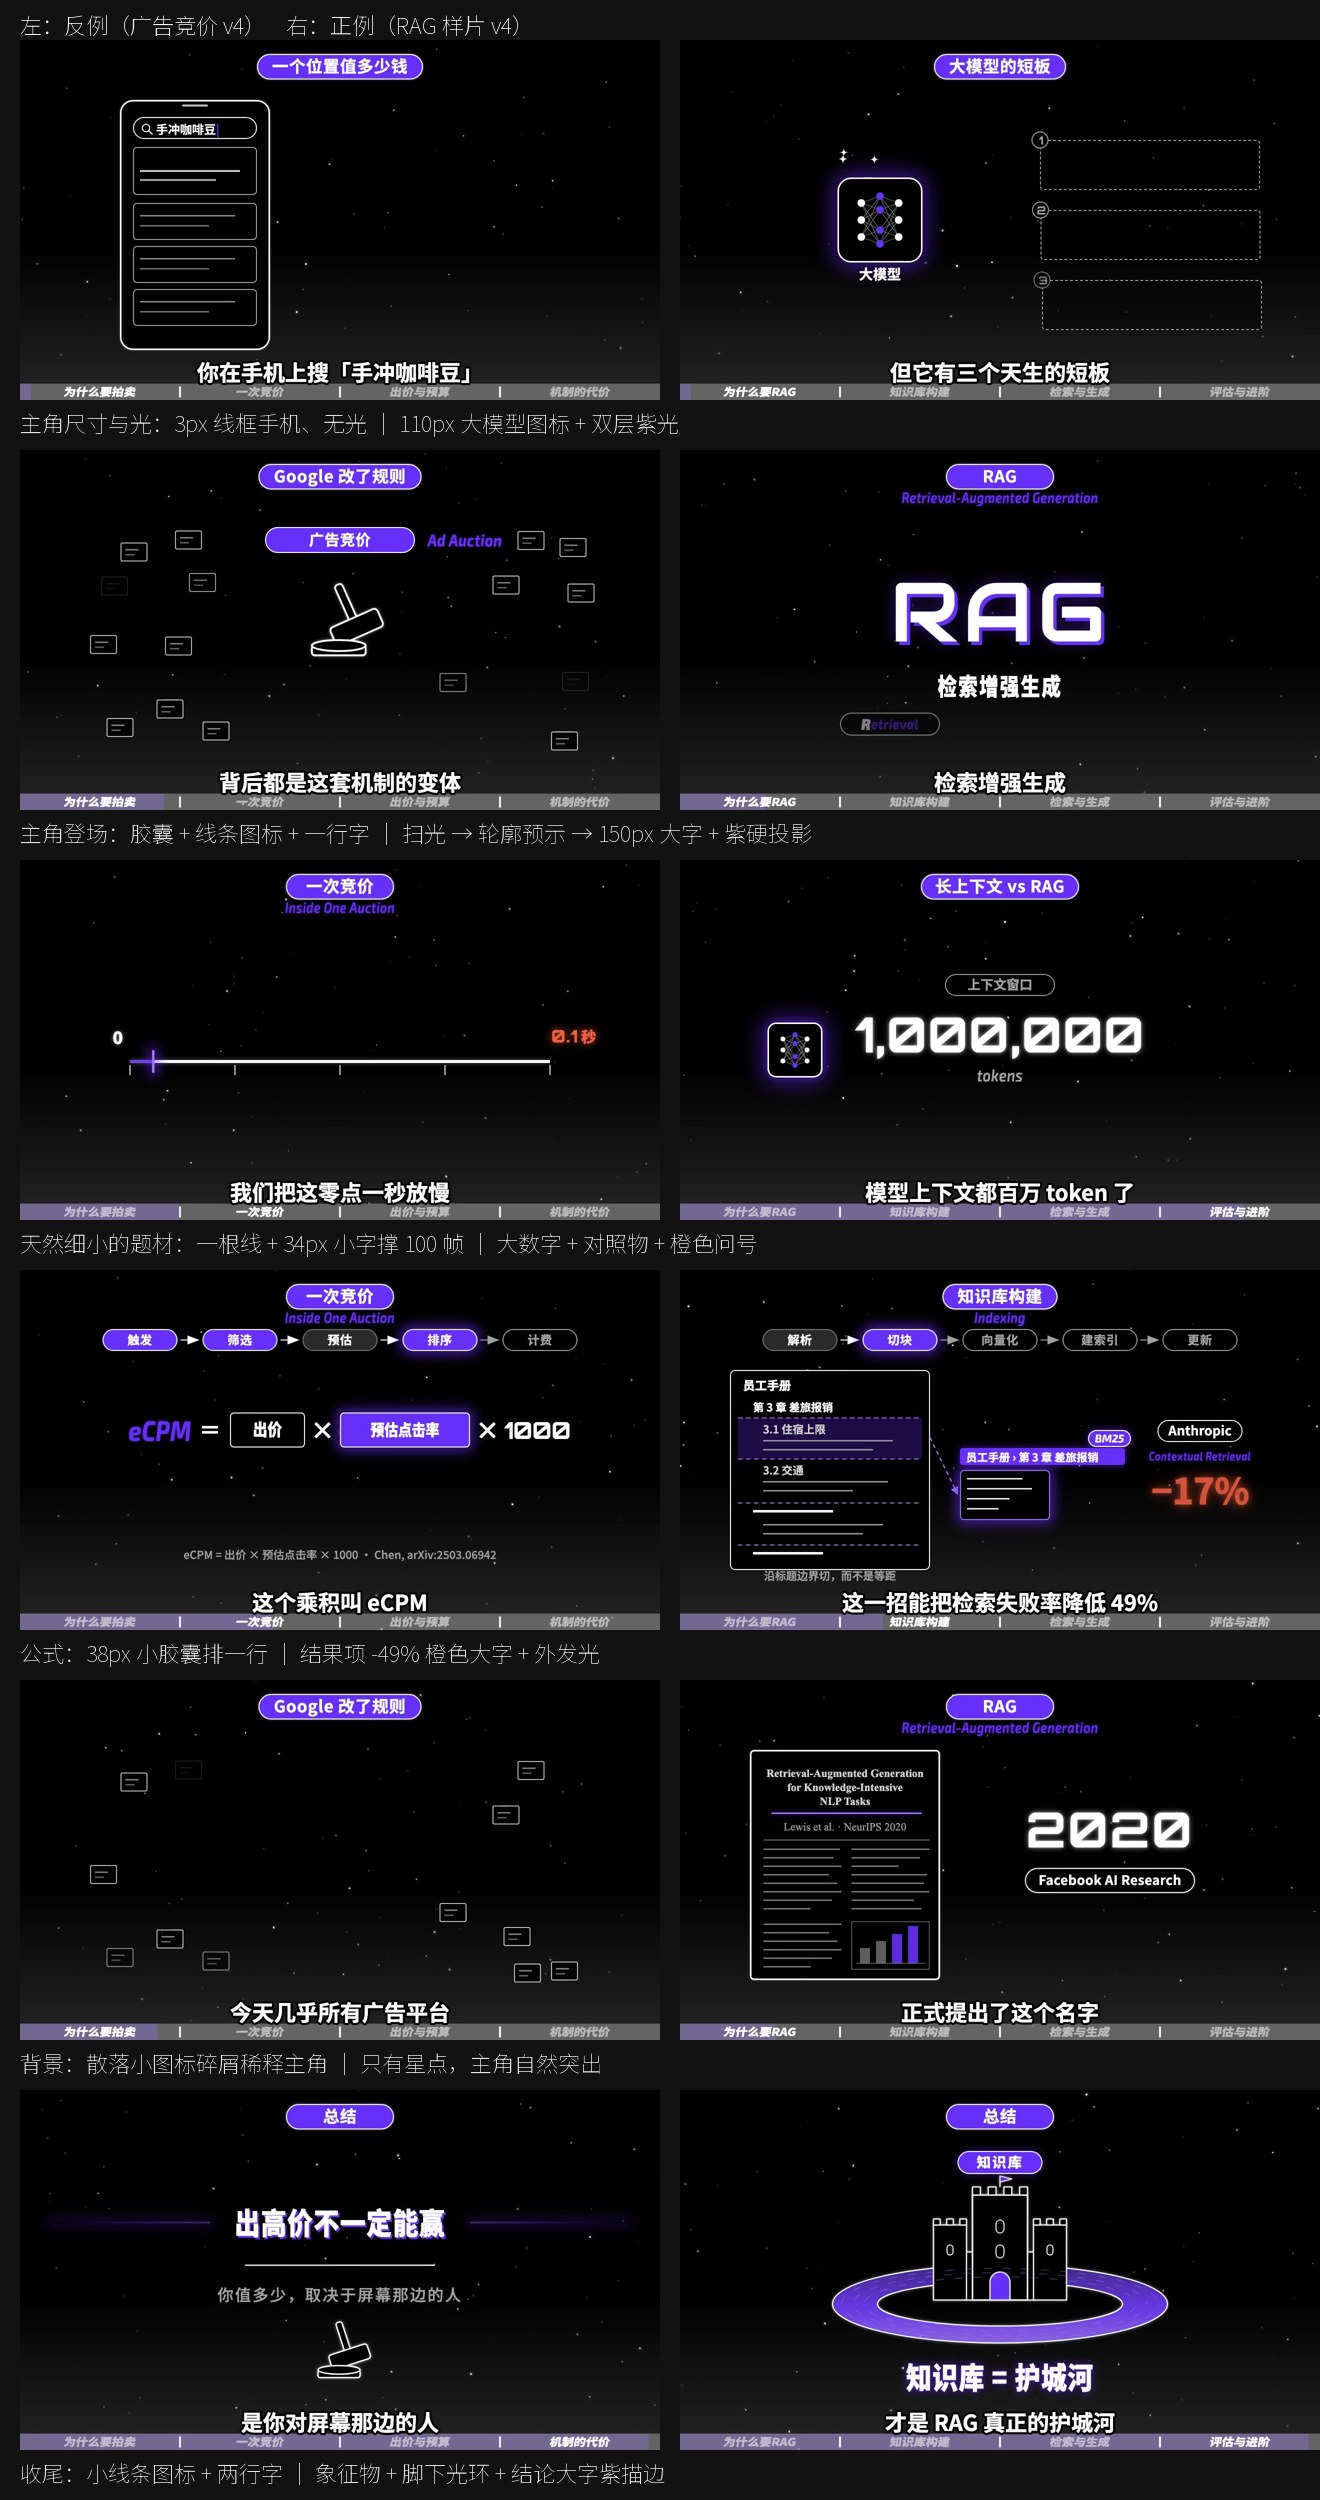
这等于把"什么叫好看"从一句模糊的"高级感",变成了 Agent 可以比对的具体判据。QC 阶段也是按书面标准逐帧打分,而不是凭感觉说"我觉得还行"。
十分钟装起来
git clone https://github.com/Vincentwei1021/anything2explainer.git
ln -s "$PWD/anything2explainer" ~/.claude/skills/anything2explainer   # Claude Code
ln -s "$PWD/anything2explainer" ~/.codex/skills/anything2explainer    # Codex
依赖方面:Node 18 以上(模板 npm install 会装 Remotion 4.0.507 / React 19),ffmpeg 必需;Python 侧装 edge-tts、numpy、pillow、scipy。中文默认配音走 edge-tts 的云希男声,免费且带词级边界;英文默认用 8200 万参数的 kokoro 本地模型,CPU 就能跑。
几个值得说的工程细节:不需要 GPU,Remotion 用无头 Chromium 在 CPU 上渲染;渲染完全可复现,所有动画都是帧号的纯函数、随机数带种子、排版靠计算而不测 DOM,重渲一遍帧完全一致。项目甚至在树莓派 5 上跑通了,针对 ARM 上 kokoro 难装的问题补了 kokoro_onnx 和 piper 两个兜底引擎。
工程层面的一个判断
这个项目最值得琢磨的,是它主动放弃了像素级的自由,去换确定性。
视频生成模型最大的卖点是"什么都能生成",但对知识类内容,这恰恰是风险来源——你无法保证画面上的每个事实都是对的。anything2explainer 反其道而行:画面是代码,所以每个数字都能追溯到调研文档里的 URL,任何一帧出问题都能通过改一个镜头文件修好,重渲还能精确复现。再加上把干预点尽量前置(30 秒样片、解说词定稿)和用正反例固化审美,整套方法其实回答了一个更普适的问题:当你让 Agent 做一件复杂的、有明确质量标准的事时,应该怎么组织流程。
谁该用,谁先等等
适合:需要持续产出技术科普/知识类视频的开发者、团队或教育博主;想研究多 Agent 协作、Agent Skill 工程化的人,这套仓库是非常完整的参考实现;不想为视频生成模型付费、又要画面可控可改的用户。
需要注意:
- 工具包本身是 PolyForm Noncommercial 许可,非商业使用免费,商用需事先获得作者授权(不过用它做出来的视频归你自己);
- 目前只做 1280×720 横屏,不支持竖屏 9:16,也不适合复刻现有视频、真人口播或以实拍为主的片子;
- 视觉风格有意只做黑底 MG 一种,想要别的风格得自己改 style guide;
- 解说词一旦配音定稿就不能改词,多 Agent 并行构建对机器有要求(建议预留 5GB 以上磁盘);
- 脚本主要在 macOS 上验证,Linux 可用(含树莓派),Windows 未测试。