7 秒跑完真实网页任务:我通读了 Browser Use 新开源的 Jev Ultrafast 源码,看清浏览器 Agent 的「做选择题」路线
7 秒跑完真实网页任务:我通读了 Browser Use 新开源的 Jev Ultrafast 源码,看清浏览器 Agent 的「做选择题」路线
项目地址: https://github.com/browser-use/jev-ultrafast 仓库:
browser-use/jev-ultrafast| 协议: MIT | 语言: Python 3.12+(约 6 个核心文件) 关键依赖: TypeSafe Jev(决策模型)、browser-harness(Chrome 连接)、OpenAI 兼容小模型(写字,默认示例用 Mercury 2.5) 取证依据: 仓库源码、docs/design.md、docs/performance.md及其测量 JSON(写作时为当前 main 分支版本)
过去两年,浏览器 Agent 的主流叙事一直是「给大模型一张截图,让它生成坐标 / 选择器 / 代码,点错了再来一轮」。这条路线的代价每个人都体会过:一张截图上千 token,一个表单十几次串行决策,网络抖动和页面动画还会让模型刚刚想好的动作立刻失效——跑一个订票 Demo,几十秒和上美元就没了。
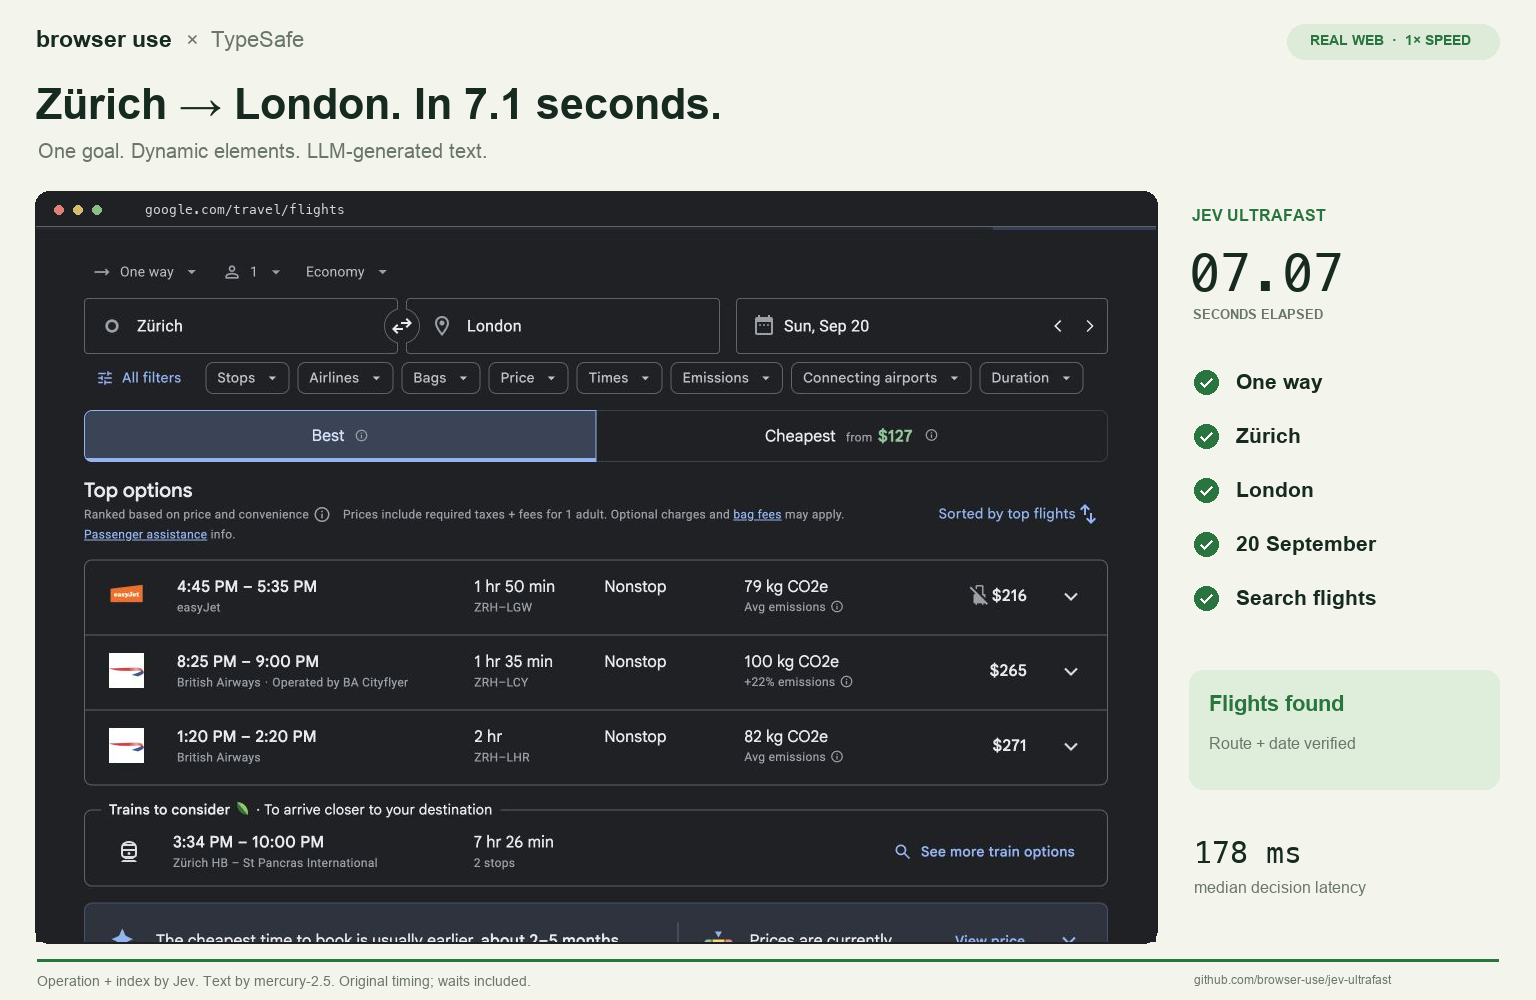
这星期 browser-use(就是那个 6 万 Star 的 browser-use/browser-use 背后的团队)开源了一个思路完全不同的项目:Jev Ultrafast。它的招牌成绩是:在真实的 Google Flights 上,从一句自然语言目标开始,完成「苏黎世→伦敦、2026 年 9 月 20 日、单程、经济舱」的搜索并独立验证结果,全程 7.073 秒,1 倍速无剪辑。我把仓库里六个核心文件和两份设计/性能文档通读了一遍。下面讲三件事:它的机制为什么快、快在哪里有真实数据支撑、以及它的边界在哪。
一、核心机制:每个网页都是一张带编号的选择题
Jev 不看截图。默认循环里,它通过注入页面的 snapshot.js 对 DOM 做一次原子快照,读出可见的 HTML/ARIA 控件及其名称、当前值、状态,然后编号成一张元素表:
[1] button    Change ticket type · Round trip
[2] combobox  Where from?        · San Francisco
[3] combobox  Where to?          · empty
[4] textbox   Departure          · empty
动作空间只有八个操作:CLICK、TYPE_TEXT、SELECT、SCROLL_UP、SCROLL_DOWN、WAIT、DONE、BLOCKED。关键设计在 model.py 的 choose() 里:一次 TypeSafe 请求同时发出多个选择题——一个 operation 问题(做什么操作),外加每种操作一个 target 头(click_target、type_text_target、select_target,每个头里只放与该操作兼容的元素)。
这些 target 问题是**推测式(speculative)**的:回答 target 时模型还不知道 operation 会选什么,所以题面直接写明「假设操作是 CLICK」。最终只有被选中操作对应的那个 target 头会被执行。两个决策,一次网络往返。这就是 README 里那张架构图的全部含义,也是它与「先问模型点哪里、再问模型点哪个」的串行框架最本质的区别。
还有一条容易被忽略的约束:模型输出永远不会变成选择器、坐标、shell 命令或可执行 JavaScript。执行器拿到的是快照阶段用 WeakMap/Map 持有的真实 DOM 节点引用;模型只是在编号里做选择。节点被替换会得到新身份,导航后缓存全部作废。这从结构上封死了「模型吐出一段恶意 JS 被直接 eval」这类注入面。
二、文字怎么办:只有 TYPE_TEXT 才唤醒小模型
「做选择题」解决了点击和选择,但城市名这种自由文本总不能靠枚举。Jev 的分工是:仅当操作选中 TYPE_TEXT 时,才把目标、页面可见文本(截断到 6000 字)、最近几步历史发给一个 OpenAI 兼容的小模型,且返回必须是恰好包含一个 text 字段的小 JSON 对象——代码不做引号提取,不接受任何额外字段,解析失败就一个字都不输入。
实测数据很具体:Flights 那 7 秒录制里,生成 “Zurich” 用了 581 ms,生成 “London” 用了 346 ms,两次 helper 调用 OpenRouter 计费合计 $0.00006272。也就是说,贵的大模型只负责毫秒级的「判断」,便宜模型只在需要写字时出场两次。示例配置走 OpenRouter 的 inception/mercury-2.5(关闭推理),model.py 里的 helper 同时兼容 DeepSeek / Gemini / GLM 等 OpenAI 兼容端点。
一个值得注意的工程细节:生成的文本在「过期重试」时可以复用,但前提是 helper 的整个输入一字不差;一旦成功写入,立即丢弃。这避免了页面变化后把旧字段的文本错填进新字段。
三、快 25% 的证据:一份克制的实测报告
开源 Demo 项目最常见的毛病是只放一个最快成绩。docs/performance.md 难得地给出了配对实验:同一任务、同一 Chrome 配置、同一模型版本(Jev 1.13.0 + Mercury 2.5),新旧代码交替跑 3 对共 6 次,全部纳入、全部通过独立校验。
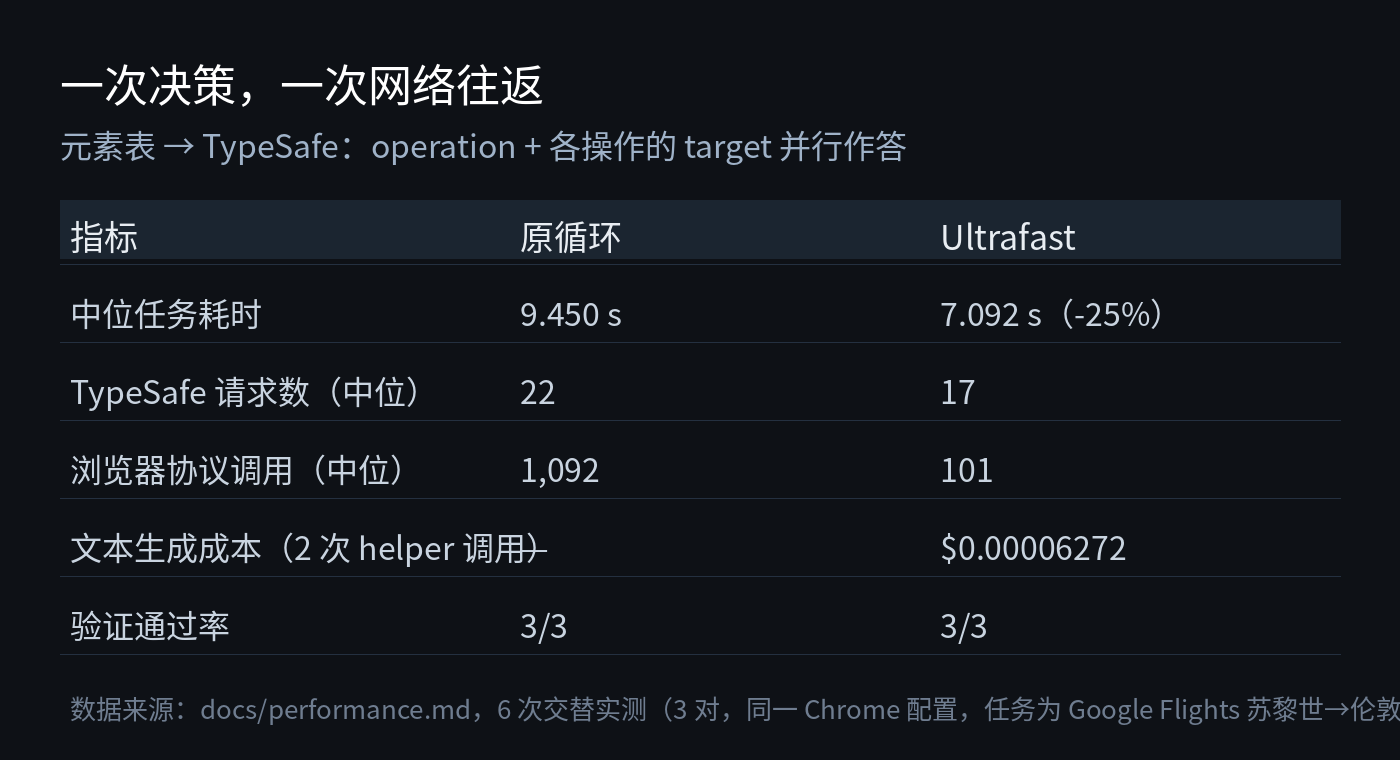
三个数字最能说明时间花在哪:
- 中位任务耗时 9.450 s → 7.092 s,降 25%;
- 中位 TypeSafe 请求 22 → 17;
- 中位浏览器协议调用 1,092 → 101——这是数量级的变化。
协议调用为什么能砍掉 90%?旧循环反复读取可访问性树、解析几百个 DOM 节点,并且任何 DOM 变动(包括动画)都会让决策失效重算;新方案一次浏览器调用拿齐控件状态,新鲜度守卫改为比较「语义状态」——点击前核对文档、URL、视口、表单值、目标及其附近上下文,动画单独不再触发重算。输入前仍会重新读取几何并做命中测试(occlusion check),覆盖遮挡的控件会被拒绝。
等待策略也被精打细算:普通交互后最多等两帧或 50 ms;但在组合框输入后,改为等待可见的自动补全建议、上限 200 ms——避免建议还没出来就让模型对着不完整弹窗做选择。录制全程 17 次 Jev 请求,中位决策延迟 178 ms,10 次交互加 1 次显式 WAIT。
报告同时老老实实写了局限:只有 3 对样本,双侧符号检验 p=0.25,不构成强统计结论;这是单任务、单浏览器配置的受控对比,不是通用 Agent 跑分。另外两个冒烟测试——维基百科打开哥德尔不完备定理文章 2.798 s、本地酒店页面完成搜索加三个筛选 1.896 s——也注明了不是配对速度对比。
四、最小上手路径
git clone https://github.com/browser-use/jev-ultrafast.git
cd jev-ultrafast
uv sync
cp .env.example .env
# 填入 TYPESAFE_API_KEY 和 TEXT_MODEL_API_KEY
uv run jev
打开 http://127.0.0.1:8766,点 Start demo → Run automatically。Chrome 通过 browser-harness 连接(复用你本机已登录的 Chrome profile),连接异常时跑 uv run browser-harness --doctor。
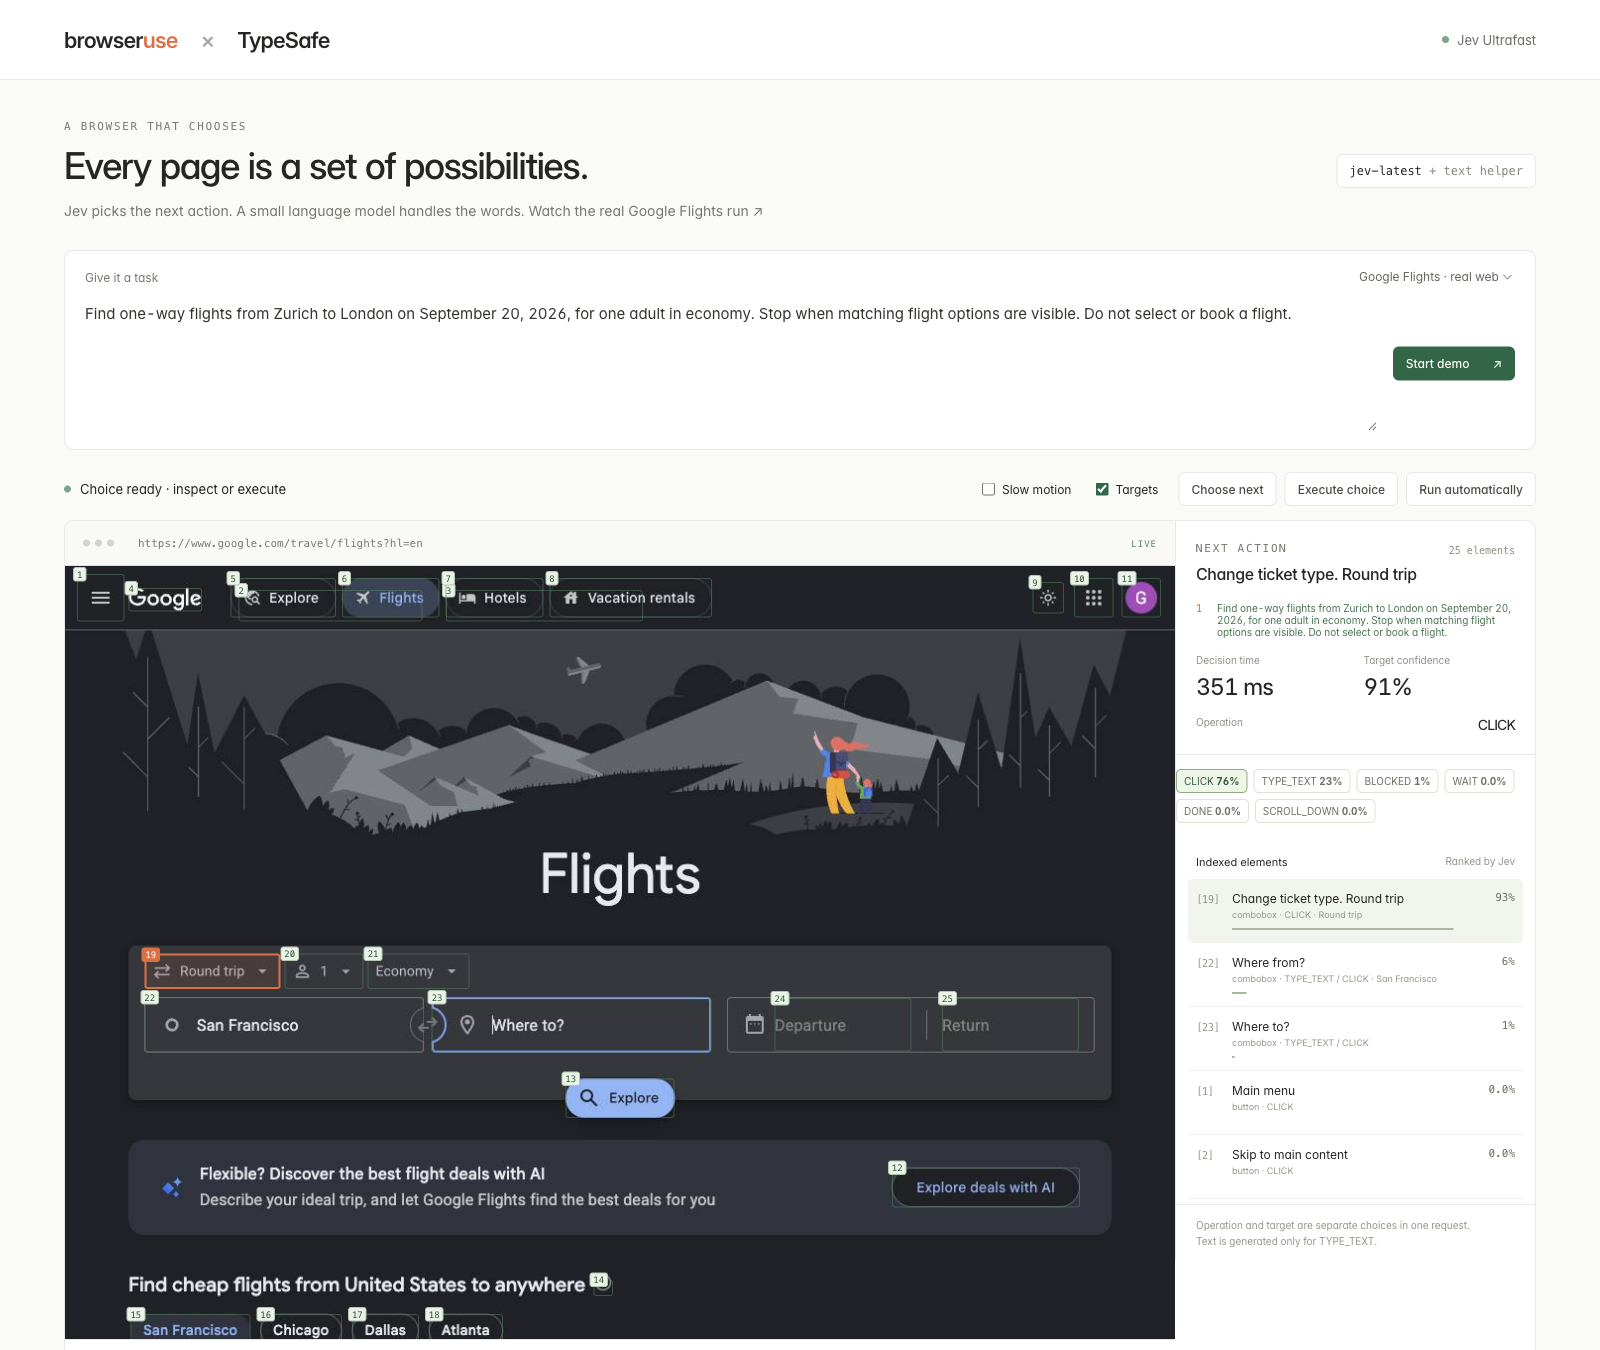
这个本地检查器本身也是理解系统的最好入口:页面上的编号框就是快照产物,右侧面板实时显示操作概率分布、各目标概率、置信度和延迟;Choose next 会在执行前暂停,让你逐步检查它的每一个决策。作为库调用也只有几行:
from jev_ultrafast import Agent

with Agent(
    "https://www.google.com/travel/flights?hl=en",
    "Find one-way flights from Zurich to London on September 20, 2026, "
    "for one adult in economy. Stop when matching flight options are visible.",
) as agent:
    for state in agent.run():
        print(state["elapsed_ms"], state["status"])
examples/flights.py --keep-open 会执行搜索并独立核对航线、日期和结果可见性,保存轨迹,但不会选航班或下单。离线测试(pytest + ruff)不花一分钱 API 额度;只有 live 示例和录制脚本会产生付费调用。
五、边界与判断:谁现在该用,谁该等
源码和文档把能力边界写得很清楚,下单之前请逐条对照:
- DOM 读取器只覆盖常见 HTML/ARIA 控件,不实现完整的 accessible-name 算法;Shadow root、iframe/frames、canvas、文件上传、弹出新标签页、嵌套滚动、任意键盘组件都在 MVP 之外,遇到就会 BLOCKED;
- 运行有硬上限:单次任务 60 个浏览器动作、120 次决策请求,最多保留 250 个候选元素;
- 所有标签页共享你现有的 Chrome profile——意味着它能用你已登录的会话,这既是便利也是风险面,别在不信任的任务上放开跑;
DONE从不被当作成功证据,必须由独立校验确认;一个合法操作仍然可能是错的。
我的判断:
- 现在就该试:在主流标准表单网站(机票、酒店、后台管理系统、政府表格)上做流程自动化的人;想研究「结构化状态 + 推测式多头决策」这一架构的工程师;以及对 token 成本敏感、希望把每次任务压到厘级的团队。六个文件能读完本身就是价值。
- 应该再等:目标网站重度使用 shadow DOM、iframe 或 canvas(很多企业级老系统和设计器类应用正是如此);需要多标签协作或文件上传的流程;以及对「共享浏览器 profile」有合规顾虑的生产场景。此外项目还很年轻(0.1.0,实测样本只有个位数),重要流程请像官方那样自己写独立结果校验,不要相信它说 DONE。
浏览器 Agent 的竞争正在从「谁的模型更聪明」转向「谁让模型做的事更少、更确定」。Jev Ultrafast 给出的答案——一次快照、一次往返、只做选择、写字外包——至少在那张 7 秒的真实机票页上,被数据证明是成立的。
项目 GitHub: https://github.com/browser-use/jev-ultrafast