选题、写作、去AI味、排版、传草稿全在一个桌面软件里:我通读了 HelpWriting 源码,还发现它的「开源协议」藏着陷阱
选题、写作、去AI味、排版、传草稿全在一个桌面软件里:我通读了 HelpWriting 源码,还发现它的「开源协议」藏着陷阱
项目地址: https://github.com/lfdc-code/helpWriteing 注意分支: 默认分支
develop只有 LICENSE,真正的代码在master-pro分支 协议: LICENSE 标称 Apache 2.0,但NOTICE附加了非商业与分发限制(详见第五节) 取证依据:master-pro分支源码、NOTICE、仓库自带的朱雀检测截图与knowledge/templates模板库
做公众号的人都熟悉这套割裂:选题刷微博热榜和新榜,写作在 ChatGPT 或 DeepSeek 的网页里,去「AI 味」靠到处抄提示词,排版在壹伴或 96 编辑器里手动套样式,最后再登录公众平台后台复制粘贴传草稿。一条内容,五六个工具来回搬,任何一环都有订阅费。
最近看到 HelpWriting,想解决的正是这条碎链路:一个本地桌面软件,把「选题 → 搜索 → 写作 → 变换 → 去味 → 排版 → 传草稿」焊死成一条流水线。我把 master-pro 分支(默认分支是空的,这是第一个坑)的源码通读了一遍。结论先行:功能完成度比多数同类玩具项目高,架构里有几个真懂内容痛点的设计;但它的「开源协议」有实质性限制,商用或二次分发之前必须看清 NOTICE。
一、八段管线:一句话进,一篇排好版的图文出
项目后端是 Python,核心编排器 src/helpwriting/core/unified_workflow.py 有 1026 行,桌面端用 PyWebView 把本地 FastAPI 服务包成窗口。一次完整任务流经八个阶段:
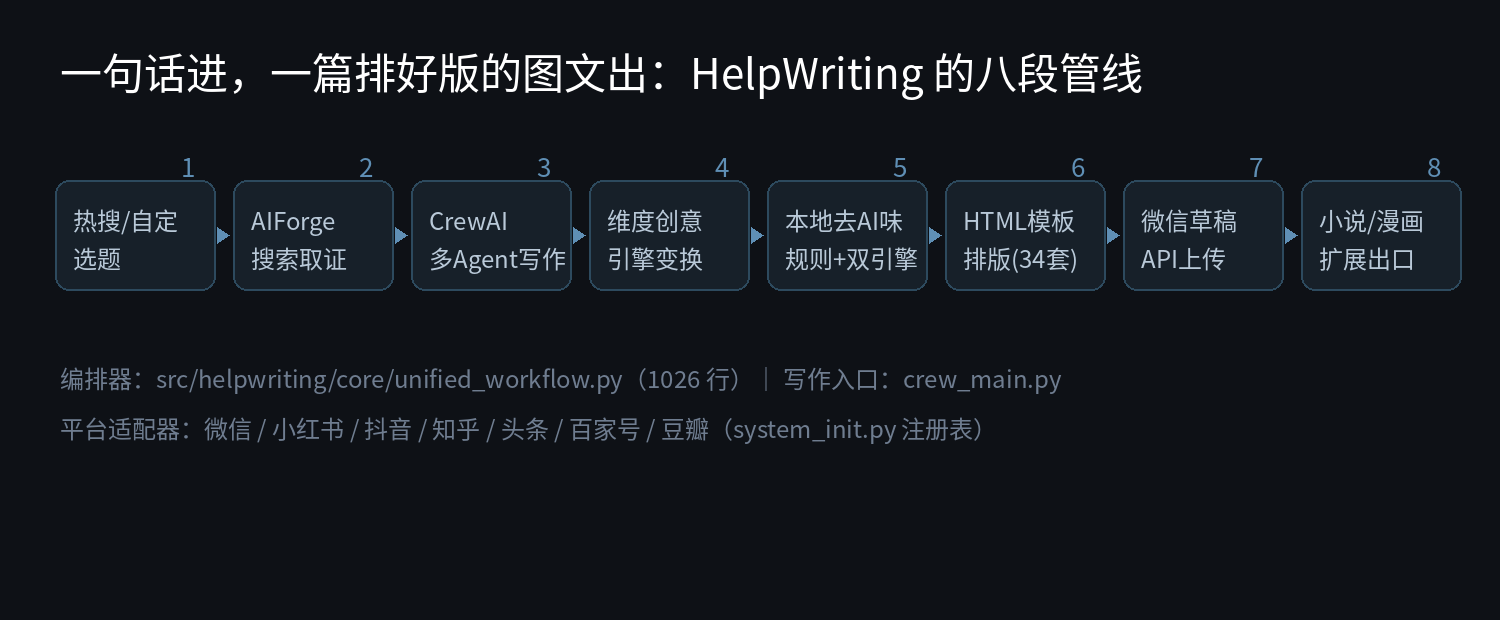
几个关键分工:
- 选题:
tools/hotnews.py接了知微数据和 tophub 两个源,覆盖微博、抖音、B站、头条、百度、小红书、快手、知乎等 11 个平台,可按权重随机抽题,也可以完全自定主题; - 取证:AIForge 引擎联网搜索,给写作 Agent 补充实时资料——这一步是为了治「模型闭着眼编」的通病;
- 写作:CrewAI 多智能体框架,Agent/Task/Crew 在
core/content_generation.py和agent_factory.py里按配置动态生成,不是写死的单轮提示词; - 出口:默认进微信公众号,
system_init.py里还注册了小红书、抖音、知乎、头条、百家号、豆瓣六个适配器(除微信外多为格式化接口,能力深浅不一)。
crew_main.py 支持两种跑法:GUI 里以子进程执行(避免长任务卡死界面),也可以命令行直接跑工作流。
二、维度化创意引擎:把「再创作」做成排列组合
公众号洗稿/再创作的核心诉求是差异化:同一素材换角度、换结构、换语气,避开查重和同质化。多数 AI 工具的做法是把原文丢给模型加一句「请改写得不一样」,效果听天由命。
HelpWriting 的 creative/dimensional_engine.py(441 行)做得更机械也更可控:它把「创意」拆成多个维度——叙事视角、文章结构、语气风格等,每个维度在 dimensional_creative_config.yaml 里有一组 preset_options(预设选项)。生成时按维度组合抽取选项,拼成具体的改写指令。界面里可以勾选启用哪些维度(手动模式),也可以让引擎自动组合。
这个设计的好处和缺点都很明显。好处是产出的差异是结构性的(视角和结构真的变了),而不是同义词替换级别的伪原创;过程可解释、可复现。缺点是它本质是一个带随机性的模板系统——维度选项库的丰富度决定上限,而配置文件里的预设选项是有限的,跑多了会出现组合重复。它把「创意」工程化了,但没有创造创意。
三、本地去 AI 味:规则、数据、方法论的三层设计
全项目我最感兴趣的是 tools/local_humanizer.py。「去 AI 味」是这两年中文内容圈的刚需,这个文件把三套机制叠在了一条本地管线里:
- 硬编码规则层:两张替换字典,一张治黑话(「赋能→帮到」「抓手→办法」「闭环→把事情做完」「底层逻辑→根本原因」),一张治翻译腔(「进行→做」「通过→靠」「然而→但」)。简单粗暴,但命中率高且零成本;
- 数据层:
vendor/shuorenhua-main(「说人话」项目)的phrases-zh.md短语库作为补充词典; - 方法论层:
vendor/humanizer-zh-1.0.0/SKILL.md,把一份完整的去味技能文档喂给模型做最后一遍重写。
规则处理确定性替换,模型处理规则覆盖不到的句式——这个「能不用模型就不用,用只在最后用」的分层,和项目整体的省钱思路是一致的,而且全部在本地完成,稿子不用发给第三方改写服务。
但紧接着就是一个更根本的问题:「去 AI 味」到底是为了骗过谁? 仓库自带的一张截图很值得玩味:
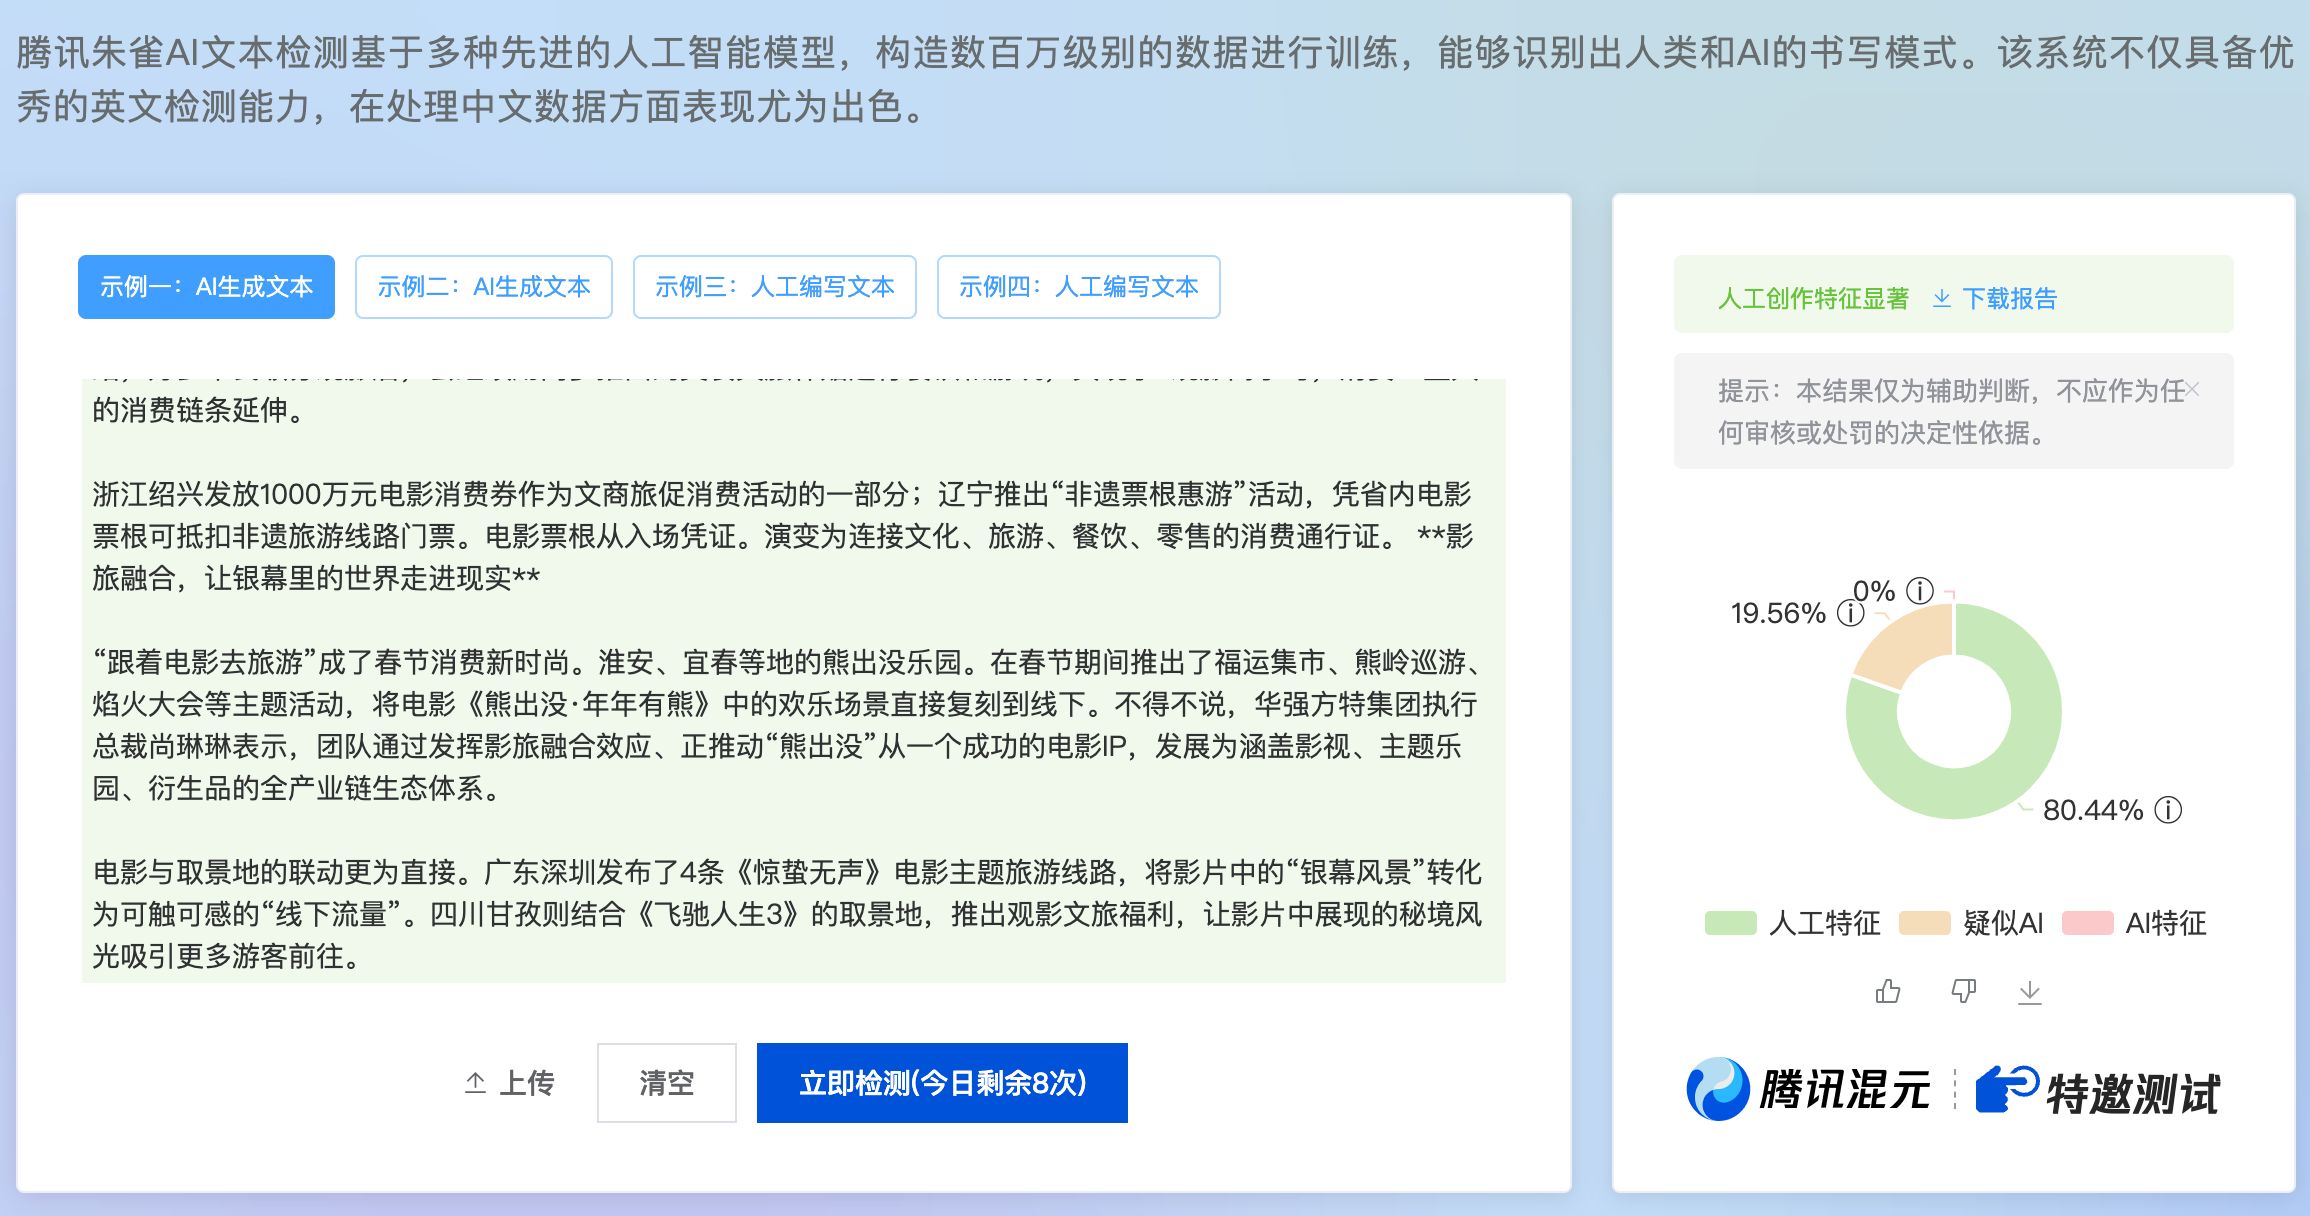
这是腾讯朱雀检测器的页面:内置的「AI 生成文本」示例,被判成 80.44% 人工特征、AI 特征 0%。页面自己也印着免责声明:结果仅为辅助判断,不应作为决定性依据。换句话说,连官方检测器对自己内置的 AI 样本都判不对。这意味着「去 AI 味」工程的真实目标其实不是骗过检测器(检测器本就不可靠),而是让真人读者读着不别扭——从这个角度说,第一层那张朴素的黑话替换表,可能比第三层的模型重写更解决问题。
四、模板库与最小上手路径
knowledge/templates 下实测有 34 套 HTML 模板、12 个话题分类:职场发展、情感心理、财经投资、科技数码、健康养生、美食旅行等。生成时可指定模板、随机抽取或按话题匹配,还支持模板压缩以减少模型上下文消耗。模板本质是带占位结构的公众号图文 HTML,直接解决「微信会清洗 CSS、排版要反复试」的麻烦。
最小上手路径(Windows 体验最顺,macOS/Linux 亦可跑):
git clone https://github.com/lfdc-code/helpWriteing.git
cd helpWriteing
git checkout master-pro        # 关键:代码不在默认分支
pip install uv
uv venv
uv pip install -r requirements.txt
# 然后在界面里配置大模型 API Key;需要自动传微信草稿则填 appid/appsecret
python main.py
不想用 GUI 的话,python -m src.helpwriting.crew_main 可以直接跑命令行写作。仓库里还放了 PyInstaller 的 HelpWriting.spec、Inno Setup 安装脚本和完整的 build/ 产物,作者明显在按「分发给非技术用户」的形态维护。
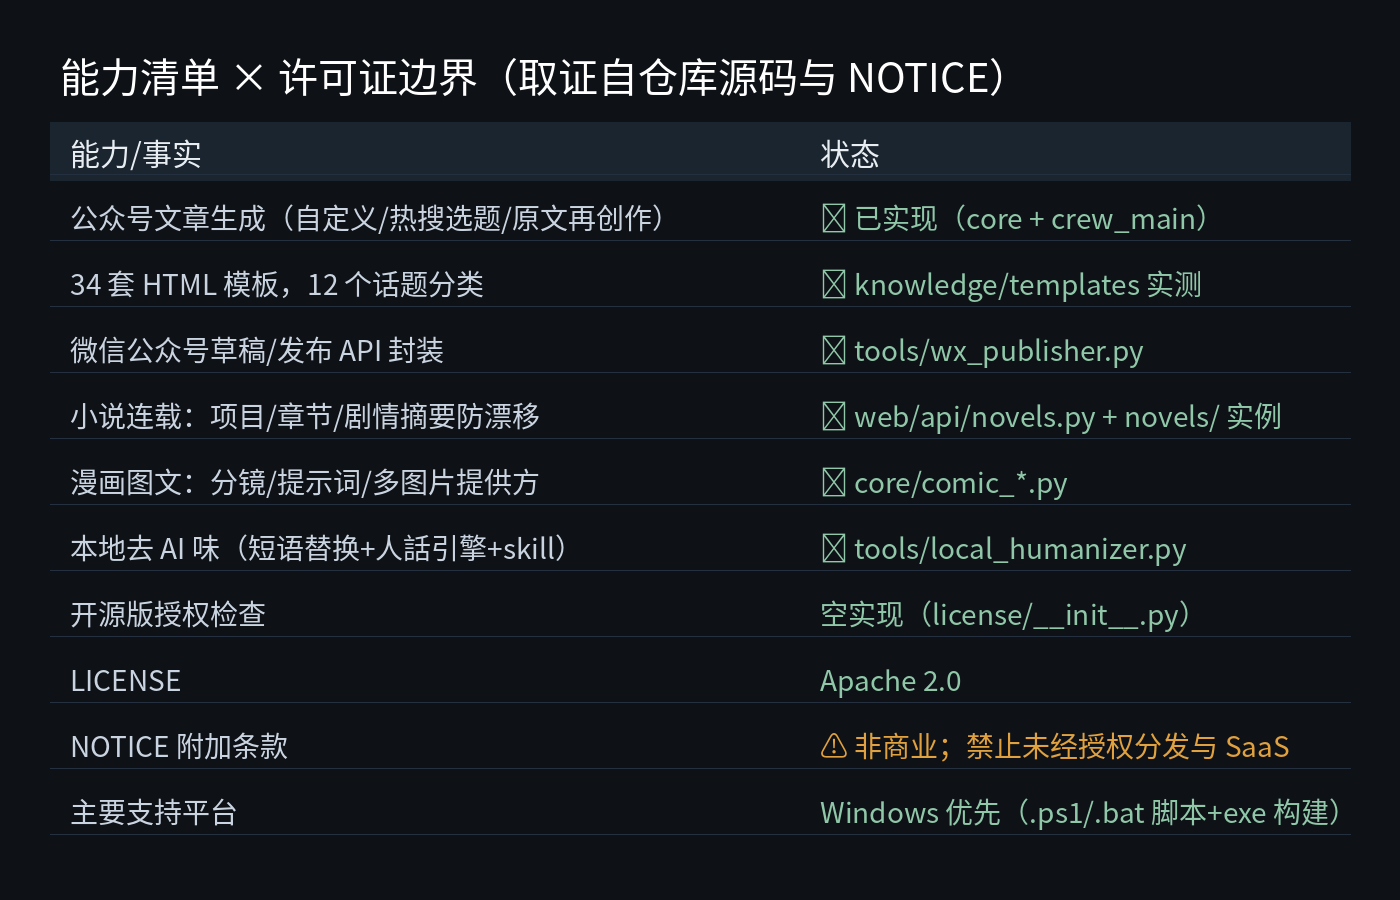
五、必须点破的协议问题:Apache 2.0 的壳,source-available 的实
这是本文最重要的非显而易见信息。仓库根目录 LICENSE 是 Apache License 2.0,GitHub 因此自动给它打上宽松开源的标签。但同目录的 NOTICE 在 Apache 2.0 之上追加了条款,原文要点:
- 非商业使用:仅允许出于非商业目的使用、修改;
- 分发限制:未经版权所有人书面授权,禁止分发本项目或衍生作品(包括复制、共享、传播);
- 服务限制:未经授权,禁止用它提供面向第三方的服务,点名 SaaS 和 API 托管。
这三条与 Apache 2.0 的核心权利直接冲突(Apache 2.0 明确授予商业使用、修改和再分发的权利)。附加条款在法律上是更严格的限制,因此这个项目严格来说不是 OSI 意义上的开源软件,而是「源码可见」(source-available):个人学习、自己本地用没问题;但你想把它接进公司工作流商用、改完分享给别人、或者部署成服务,按 NOTICE 都需要作者书面授权。
另外两个相关细节:src/helpwriting/license/__init__.py 在开源版里是空实现(直接放行),注释写明商业版才有实际授权逻辑;仓库还 vendor 了其他项目的源码(如完整的 xiaohongshu-mcp Go 代码、说人话项目),二次分发时这些第三方代码的协议合规也得单独核。综合看,开源是获客入口,商业授权才是作者预留的变现通道——这不丢人,但使用者应当在知情的前提下决策。
六、判断:谁该现在用,谁该等
现在就值得试:
- 个人公众号创作者,尤其是 Windows 用户:本地部署、个人使用落在 NOTICE 允许范围内,一条流水线确实能省下五六个工具的订阅和搬运时间;
- 想研究 CrewAI 多智能体内容编排、或「规则+模型」混合管线设计的开发者:1026 行的编排器和三层 humanizer 都值得读;
- 需要小说连载管理(剧情摘要防漂移)或漫画分镜生成的人,仓库
novels/里有一个 30 章的完整实例可参考。
应该再等或绕行:
- 有商业使用、二次分发或 SaaS 部署计划的团队:先解决 NOTICE 授权,别被 Apache 2.0 的标签误导;
- 目标是小红书/抖音等非微信平台自动化的用户:除微信外的适配器目前多为格式化入口,别期待开箱即用;
- macOS/Linux 重度用户:启动脚本和打包链路明显以 Windows 为中心(.ps1/.bat/exe),需要自己趟环境。
内容生产工具的终极竞争力其实就两件事:链路是否真的少搬几次家,以及产物是否真的像人写的。HelpWriting 在这两点上都拿出了工程化的答案,八段管线不是 PPT;但它同时用一份 NOTICE 明确告诉你——这是一个可以看、可以自用、但不能随便拿走做生意的项目。知道这条边界,你就知道该不该上车了。
项目 GitHub: https://github.com/lfdc-code/helpWriteing(记得切到 master-pro 分支)