读完 2379 行源码:这个 29 Star 的开源工作台,把 AI 出图和出视频装进了同一个网页
读完 2379 行源码:这个 29 Star 的开源工作台,把 AI 出图和出视频装进了同一个网页
项目地址: https://github.com/you-want/agnes-image-tool 仓库全名:
you-want/agnes-image-tool版本: 未显式打 tag | 创建: 2026-06-23 | 最近推送: 2026-07-29 技术栈: Python 3.10 + Gradio + Requests + OpenAI SDK,MIT 协议 写作时数据: 29 Star / 9 Fork / 0 open issues
做短视频素材的人大概率经历过这种分裂:图片在一个网页工具里生成,视频要换另一个平台,图生视频还得先把图片传到某个图床拿到公网链接;想省钱自己搭,ComfyUI 的节点画布学一下午,本地显卡还未必跑得动。
这周翻到的 agnes-image-tool 给了另一种答案:不跑模型,只做一个 Gradio 网页工作台,把模型厂商(Agnes AI,OpenAI 兼容接口)的图像和视频 API 全部收进 localhost:7860 这一个页面。29 Star,体量很小,核心代码只有四个 Python 文件。我把仓库 clone 下来通读了全部 2379 行 Python 源码(含三个测试文件),又看了它的 Docker 配置和一个藏在 web/ 目录里的 Next.js 重写版。这篇文章不讲 README 上的漂亮话,只回答三个问题:它到底封装了什么、源码里有哪些非显而易见的设计、以及什么人现在就该装。
一、它到底是什么:一个「API 操作台」,不是模型项目
先把预期摆正:这个仓库里没有任何模型权重,也不需要 GPU。requirements.txt 全部内容只有四行——gradio、openai、requests、pillow。真正的推理发生在 https://apihub.agnes-ai.com/v1,本地进程干的活是:拼请求参数、把本地图片转 Base64、轮询视频任务状态、把结果下载到 outputs/ 目录。
这意味着它的部署成本极低(免费的 Hugging Face Spaces CPU 档就能跑),但也意味着它的能力上限和稳定性完全绑定 Agnes AI 这家 API 服务商。README 宣称可以在 agnes-ai.com 免费领取 API Key,免费额度的具体规则我没有用真实 Key 验证(标注为未验证),打算长期用的人需要自己先确认计费策略。
项目主界面是 7 个标签页,我逐个对照了 app.py 里的 gr.TabItem 定义,真实能力如下:
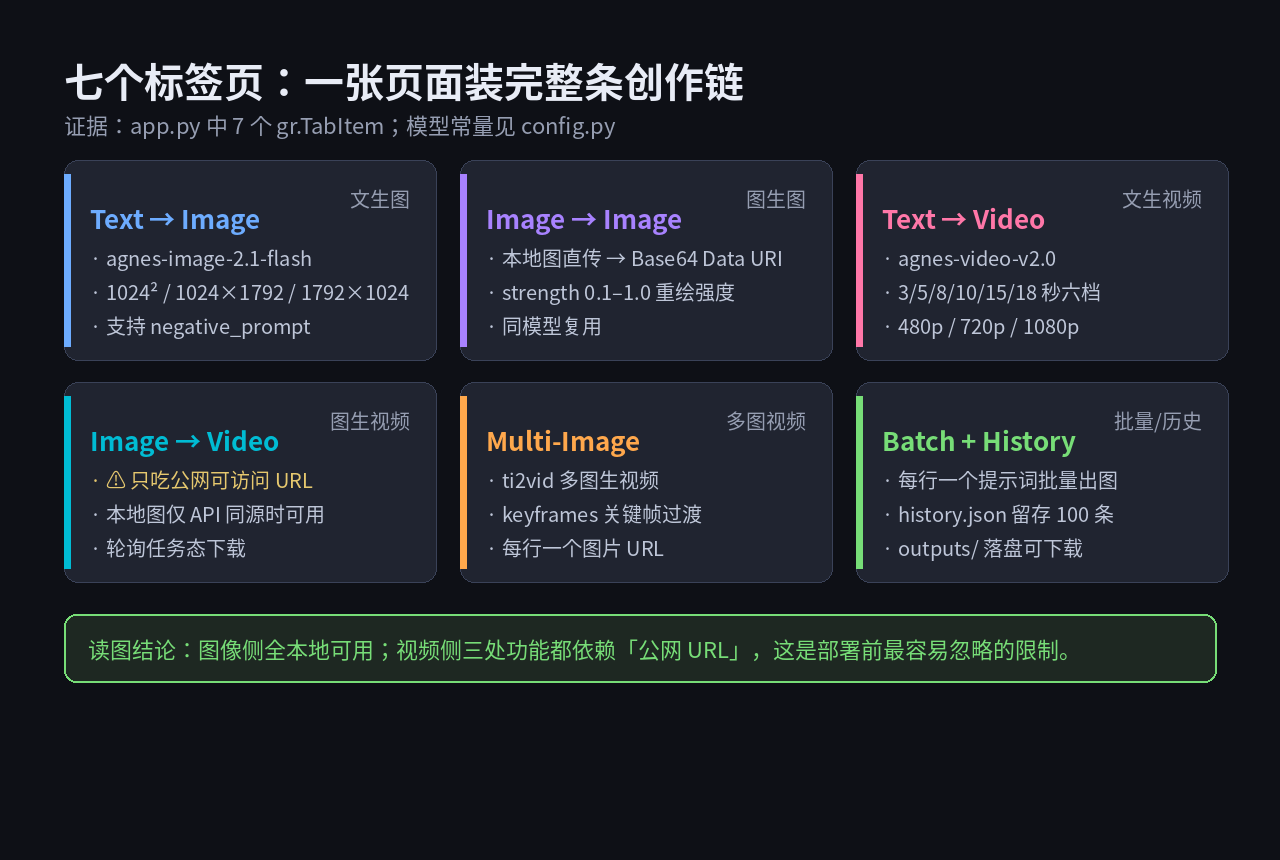
值得注意的是,README 功能表诚实地给三个视频功能标了「⚠ 需公网URL」,这种在自己 README 里主动写限制的做法在小项目里不多见。具体原因后面工程分析里讲。
二、最小上手路径:五分钟,四个依赖
git clone https://github.com/you-want/agnes-image-tool.git
cd agnes-image-tool
pip install -r requirements.txt
export AGNES_API_KEY="你的密钥"   # Windows PowerShell 用 $env:AGNES_API_KEY="..."
python app.py
启动后监听 http://localhost:7860。密钥还可以写进 .env,或者在网页设置里存到 .config.json(config.py 里有读取逻辑,优先级是环境变量优先于配置文件)。文生图在「Text → Image」页输入提示词、选尺寸、点生成即可;图生图多一个「重绘强度」滑块(0.1–1.0,对应 API 的 strength 参数,越高偏离原图越远)。
我没有真实 API Key,没有触发实际扣费调用,因此生成质量、出图速度、免费额度均为未验证项——这点和纯开箱文章的区别先讲清楚。
三、工程洞察一:视频帧数为什么被写死成 8n+1
通读 config.py 时最先引起我注意的是这张时长映射表:
DURATION_TO_FRAMES = {
    3: 81, 5: 121, 8: 201, 10: 241, 15: 361, 18: 441
}
六个数字全部满足 8n+1:81=8×10+1、121=8×15+1、……、441=8×55+1。这不是巧合。api_client.py 在真正发请求前还有一道「按分辨率最大帧数截断、再重新对齐到最近的 8n+1」的逻辑。
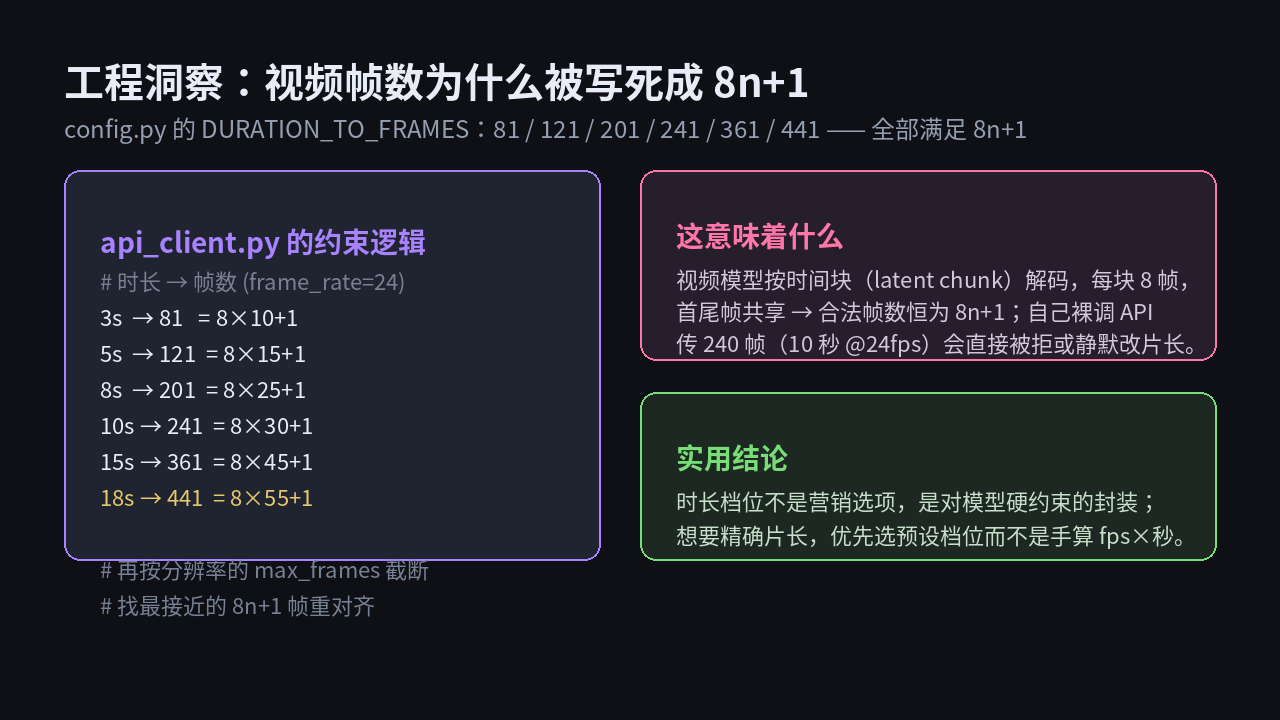
这是类视频扩散模型的典型硬约束:模型在隐空间按时间块(latent chunk)解码,每个时间块覆盖 8 帧,相邻块共享边界帧,所以 n 个连续块的合法帧数就是 8n+1。如果你绕过这个工作台直接裸调 API,按常识传「10 秒 × 24fps = 240 帧」,240 不满足 8n+1,请求要么被拒,要么被服务端静默改成别的片长。
这个小项目的价值就在这里:界面上的「3/5/8/10/15/18 秒」六个时长按钮不是营销设计,是对模型底层约束的一层封装。 想要精确片长,用预设档位比自己手算帧数靠谱。
分辨率侧还有一个容易被忽略的细节:RATIO_TO_SIZE 的默认生成尺寸是 768 宽度档(16:9 对应 1152×768),而 README 宣传的 1080p 是通过 VIDEO_RESOLUTION_PRESETS 在提交时换算的;三档分辨率(480p/720p/1080p)还各有 max_frames 上限,高分辨率选长时长会自动被截断——这也是 api_client.py 里那道对齐逻辑存在的原因。
四、工程洞察二:图片能传本地,视频只认公网 URL
另一个不一致的设计藏在输入处理里:
- 图生图(
image_to_image):直接open(image_path, "rb")读本地文件,转成data:image/png;base64,...Data URI 发给 API。也就是说本地图片开箱即用。 - 图生视频 / 多图视频:参数是图片 URL,
app.py界面里明确提示「视频API需要公网可访问的图片URL」。README 写了一句「替代方式(仅当API服务器在本地时可用)」——源码里本地图片分支拼的是服务端相对地址,只有你自己部署的 API 服务和这个工作台同源时才成立。接官方 SaaS 端点时,这个分支等于不存在。
为什么图像接口收 Data URI、视频接口只收 URL?工程上的原因很现实:视频生成是异步任务,你提交后服务器要在接下来的几分钟里反复拉取参考图;请求里塞 Base64 会让任务载荷过大且无法重试,传 URL 让服务端自己下载更稳。代价就是用户必须先有图床。
这是部署前最容易踩的坑:你在公司内网或 localhost 把服务跑起来,文生图、图生图一切正常,到了图生视频 Tab 才发现根本喂不进图。README 在显著位置标了警告,但很多人(包括我第一次扫读时)会跳过表格。
顺带一提,视频轮询逻辑(_generate_video)写得比较扎实:提交后每 5 秒轮询一次,失败按指数退避重试最多 10 次,单次最长等待时间随重试次数增长、上限 30 秒,拿到视频地址后再下载落盘。这也是自托管时 Nginx 必须把 proxy_read_timeout 拉长(README 给的配置是 86400 秒)的原因——生成一个 18 秒视频官方建议预留 1–10 分钟。
五、四条部署路径:它不耗 GPU,免费档就能挂公网
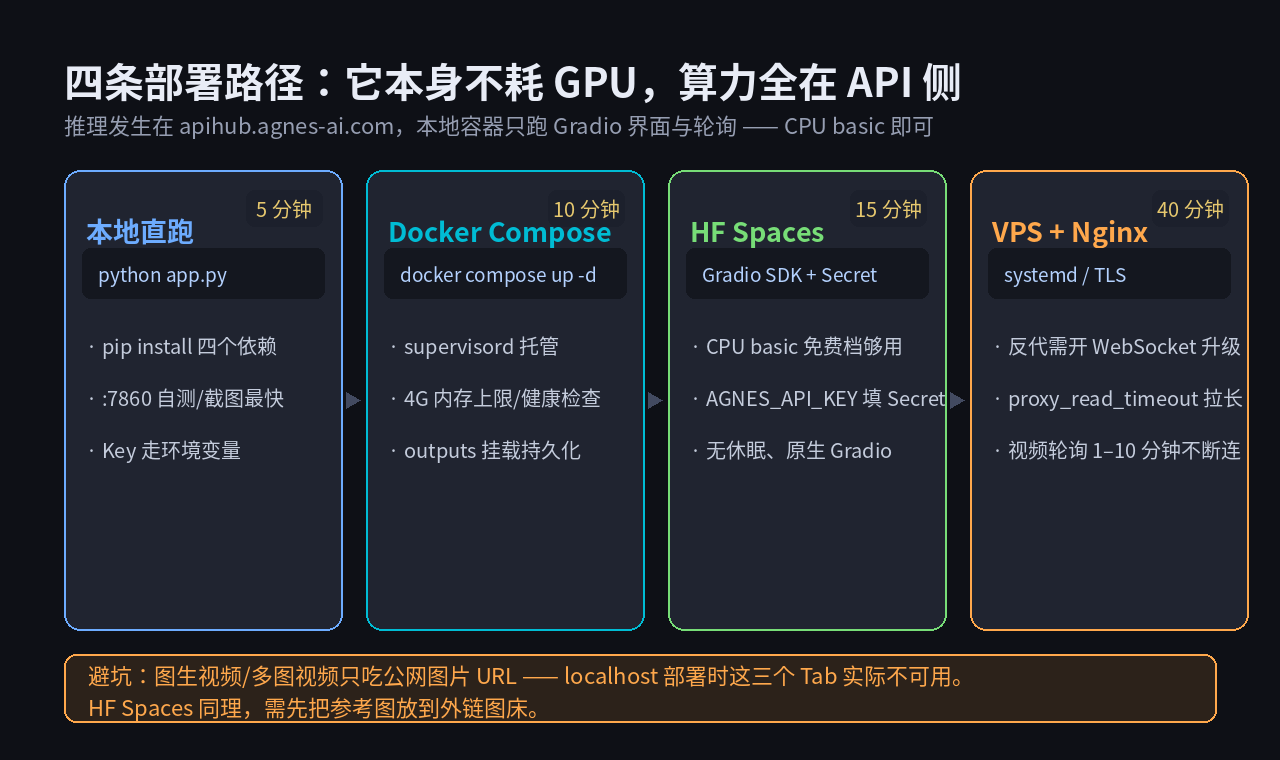
我的建议排序:
- 本地直跑:自测和截图最快,五分钟。
- Hugging Face Spaces:公网使用的首选。Gradio 是 Spaces 的原生 SDK,CPU basic 免费档零休眠,把
AGNES_API_KEY填进 Space 的 Secret 即可。README 给了完整的五步骤。需要注意:Space 跑在公网,正好满足视频接口「公网回调」的网络环境,但参考图本身仍要公网可访问——Spaces 不会自动帮你托管输入图。 - Docker Compose:
Dockerfile基于python:3.10-slim,用 supervisord 托管进程,compose 里设了 4G 内存上限、健康检查(curl -f http://localhost:7860/)和outputs/、history.json的挂载持久化,像模像样。 - VPS + Nginx:生产化必须处理两件事——WebSocket 升级头(Gradio 实时日志依赖)和长超时(视频轮询)。README 的 Nginx 配置两段都写对了,外加 Let’s Encrypt 证书和 systemd 模板,抄作业即可。
README 还覆盖了 Replit、Render 两个免费平台,并附了免费平台休眠策略对比表。对一个 29 Star 的项目来说,这份部署文档的完成度明显超标。
六、仓库里还藏着一个 Next.js 重写版
容易漏掉的是 web/ 目录:这是一个独立的 Next.js 15 + React 19 项目(包名 agnes-forge,端口 3017),带 ESLint、Vitest 测试、i18n locales 和 framer-motion,DEPLOY.md 指向 Vercel 部署。也就是说作者同时在做两套界面:Python/Gradio 版追求一键自托管,Next.js 版追求产品化体验。
我没有深入审计 web/src(这篇文章的主角是 Gradio 版),但从依赖里出现 https-proxy-agent 看,Next.js 版大概率把 API 调用放在了服务端路由里以隐藏 Key——这是 Gradio 直连架构做不到的:Gradio 版的请求从浏览器所在的后端直接发出,Key 存在部署者自己机器上没问题,但挂到公网 Space 时,任何能打开你 Space 的人都在共用你的 Key 和额度。 公网部署务必自己加访问控制,或接受 Key 被共用的风险。
七、和同类项目的边界:它是「轻工作台」,不是「平台」
昨天我刚拆过另一个同样封装 Agnes API 的项目 Agnes-AI-Platform(Vue 3 + FastAPI,162 个后端接口、无限画布、MCP Server、社区广场)。两者对照着看,选型反而清晰:
| 维度 | agnes-image-tool(本篇) | Agnes-AI-Platform |
|---|---|---|
| 形态 | Gradio 单文件工作台 | Vue + FastAPI 全栈平台 |
| 核心代码量 | 约 1800 行 Python(不含测试) | 475 个文件 |
| 部署门槛 | 4 个依赖 / 免费 CPU 档 | 需要正经部署前后端 |
| 适合 | 个人快速出素材、API 能力验证 | 多人使用、要账号体系和素材管理 |
| 多用户 | 无鉴权,Key 共用 | 有用户体系 |
要「十分钟有个能用的全模态操作台」,选本篇这个;要给团队搭内部平台,去看 Agnes-AI-Platform。
八、判断:谁现在就装,谁先等等
适合现在装的人:
- 已经在用或愿意试 Agnes AI API,想要一个比 curl/Postman 舒服、比裸写 SDK 省事的图形操作台;
- 做短视频/自媒体素材,需要文生图、图生图、文生视频一条龙,且有顺手的公网图床(对象存储、imgbb 之类)解决视频参考图问题;
- 想学习「OpenAI 兼容多模态 API 怎么封装成产品界面」的 Python 开发者——
api_client.py的请求拼装、任务轮询、错误处理是一份干净的参考实现。
建议先等等的人:
- 期待本地离线出图/出视频的人:这是纯 API 客户端,断网即停,免费额度和厂商策略都要自己先核实;
- 要做对公网多人开放服务的人:Gradio 版没有鉴权,公网部署等于请所有人共用你的 Key,应优先评估它的 Next.js 版或带账号体系的同类平台;
- 对生成质量有硬性要求的生产场景:我未能用真实 Key 验证
agnes-image-2.1-flash和agnes-video-v2.0的出片质量,建议先小额试用再决定。
最后留个观察:这个项目最后一次推送停在 2026-07-29,距今约七周,issue 区是零开放状态——不确定是稳定无人提 bug,还是用户量本就很小。用在自己工作流里没问题,押注成长期依赖前,先观察作者的更新节奏。