2 万 star、392 张图、0 行代码:我逐章核查了 Alex Xu《系统设计面试》最火的开源笔记,告诉你该怎么用
2 万 star、392 张图、0 行代码:我逐章核查了 Alex Xu《系统设计面试》最火的开源笔记,告诉你该怎么用
准备系统设计面试的人,大概率刷到过这样一类资料:标题写着「System Design Interview Notes」,点进去是几十章 Markdown 和大量架构图。这其中 star 数最高的之一,是 liquidslr/system-design-notes——截至我写这篇文章时 20,056 star、3,765 fork,内容是 Alex Xu 那两卷畅销书《System Design Interview: An Insider’s Guide》(卷一 + 卷二第二版)的全套读书笔记。
但「star 多」不等于「适合你」。一个高频的质疑是:这不过是把付费书抄了一遍,凭什么值 2 万星?另一个极端则是把它当标准答案背诵。为了回答这个问题,我把仓库完整克隆到本地,逐章统计了 28 个目录的词数和图片数,通读了代表性章节的原文与配图。这篇文章只讲三件事:这份笔记里到底有什么、它最值钱的东西是什么、以及它明确的边界在哪里。
一、仓库体检:数字都是我逐个目录数出来的
先上硬证据,全部来自本地克隆(最新提交停在 2026-08-12)的实际统计,不是 README 的宣传语:
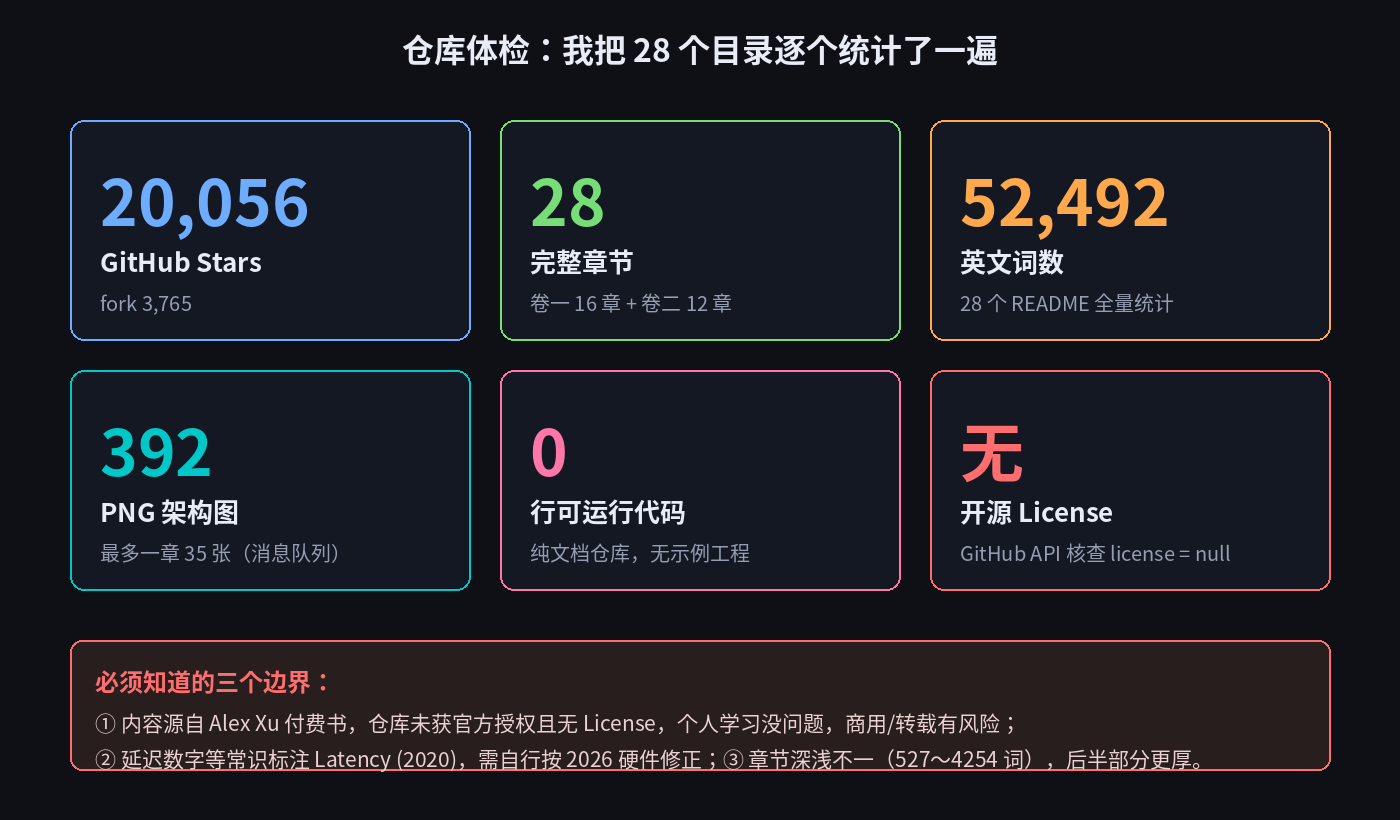
- 28 个章节,对应原书两卷:卷一 16 章(Ch1–16),卷二 12 章(Ch17–28)。
- 52,492 个英文单词,全部装在 28 个
README.md里——这是个纯 Markdown 文档仓库,没有任何配套工程。 - 392 张 PNG 架构图,全部内嵌在笔记里。章节配图密度差异很大:消息队列一章 35 张、S3 对象存储 23 张、证券交易所 24 张;而最早的基础章节只有 1 张。
- 0 行可运行代码:没有
.py、.java、.go,没有任何示例实现。它教的是设计推演,不是写代码。 - 没有 LICENSE 文件:GitHub API 返回的
license字段是null。这一点非常关键,后面单独讲。
章节篇幅也不均匀:最短的「唯一 ID 生成器」约 527 词,最长的「分布式消息队列」约 4,254 词,相差 8 倍。后半部分(卷二案例)普遍更厚。
二、28 章到底覆盖什么:一张地图看懂结构
很多人一上来从 Ch1 顺序读到 Ch28,这是效率最低的吃法。我把 28 章按性质重组成三层,你会发现它其实是一门设计好的课程:
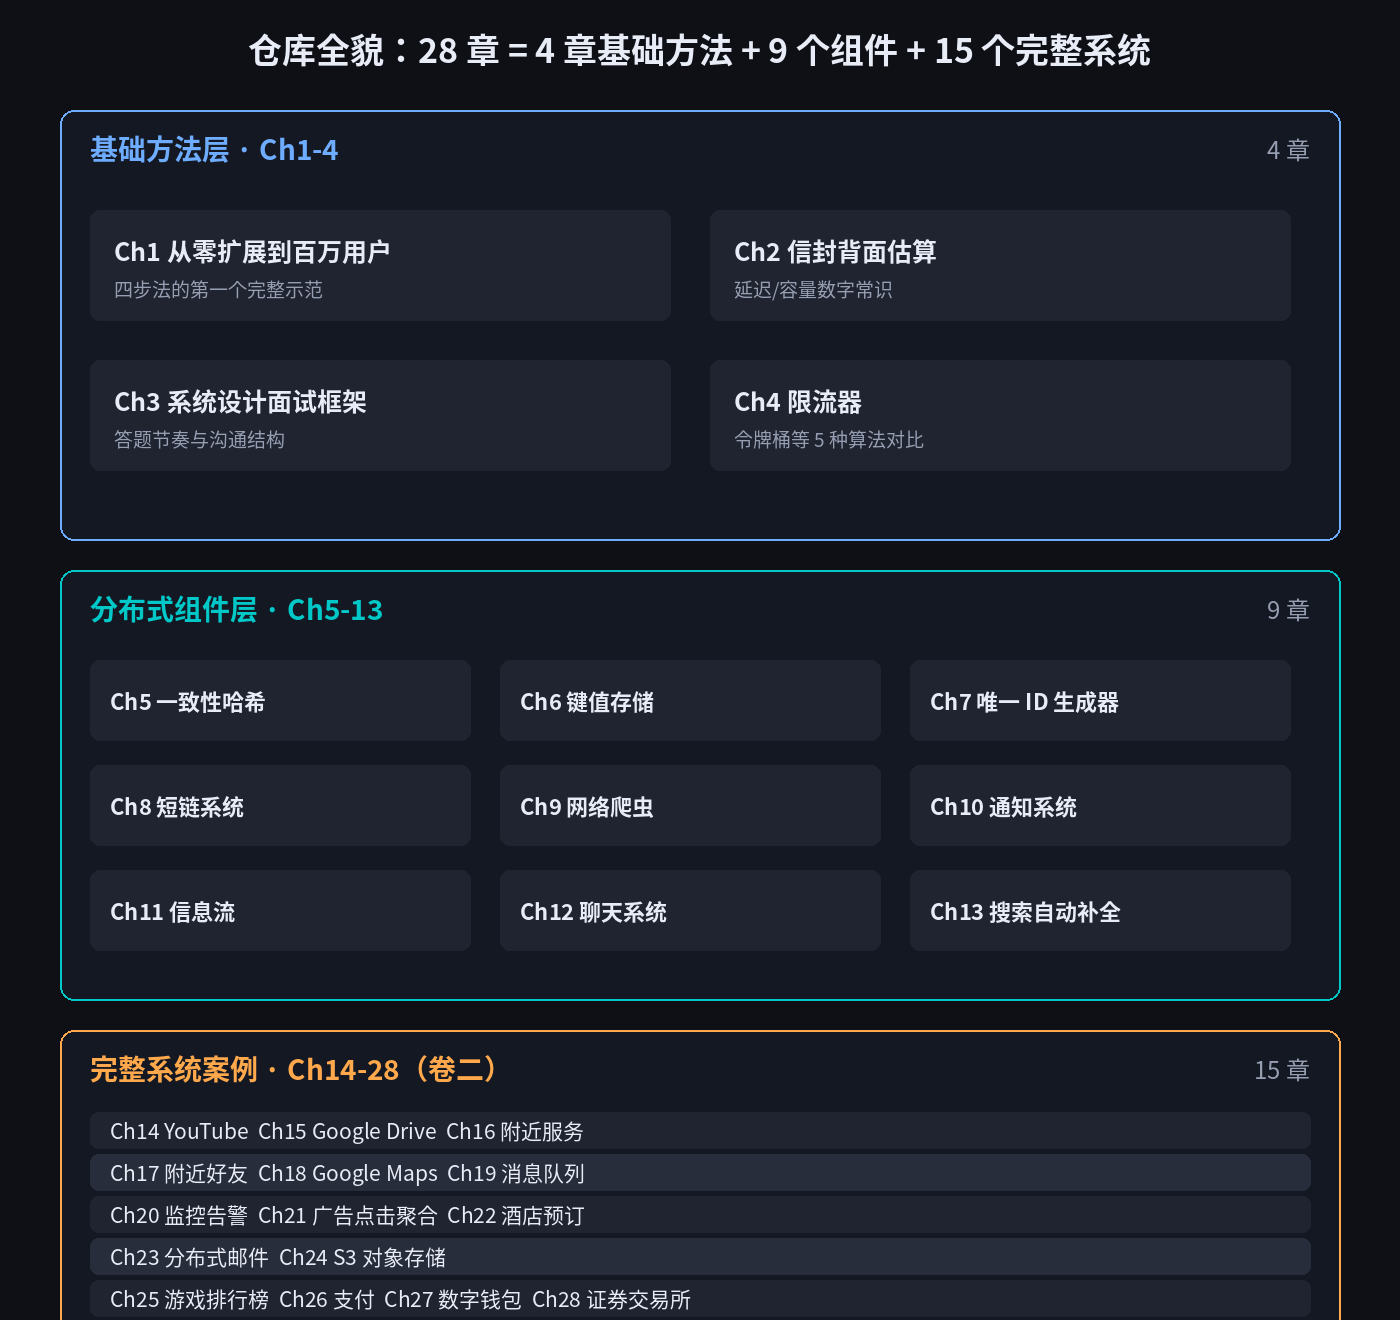
第一层是基础方法(Ch1–4):从零扩展到百万用户(单机→负载均衡→数据库复制→缓存→消息队列的演进套路)、信封背面估算(2 的幂、延迟常识表、可用性几个九)、系统设计面试框架,以及限流器。这 4 章不教具体系统,教的是「怎么开始一场设计面试」。
第二层是分布式组件积木(Ch5–13):一致性哈希、键值存储、唯一 ID 生成器、短链、网络爬虫、通知系统、信息流、聊天系统、搜索自动补全。这些是任何大系统都会复用的零件,其中 Ch5 一致性哈希和 Ch6 键值存储是全仓最核心的两章,讲了 gossip、向量时钟、Merkle tree、quorum、sloppy quorum 一整套 Dynamo/Cassandra 谱系的机制。
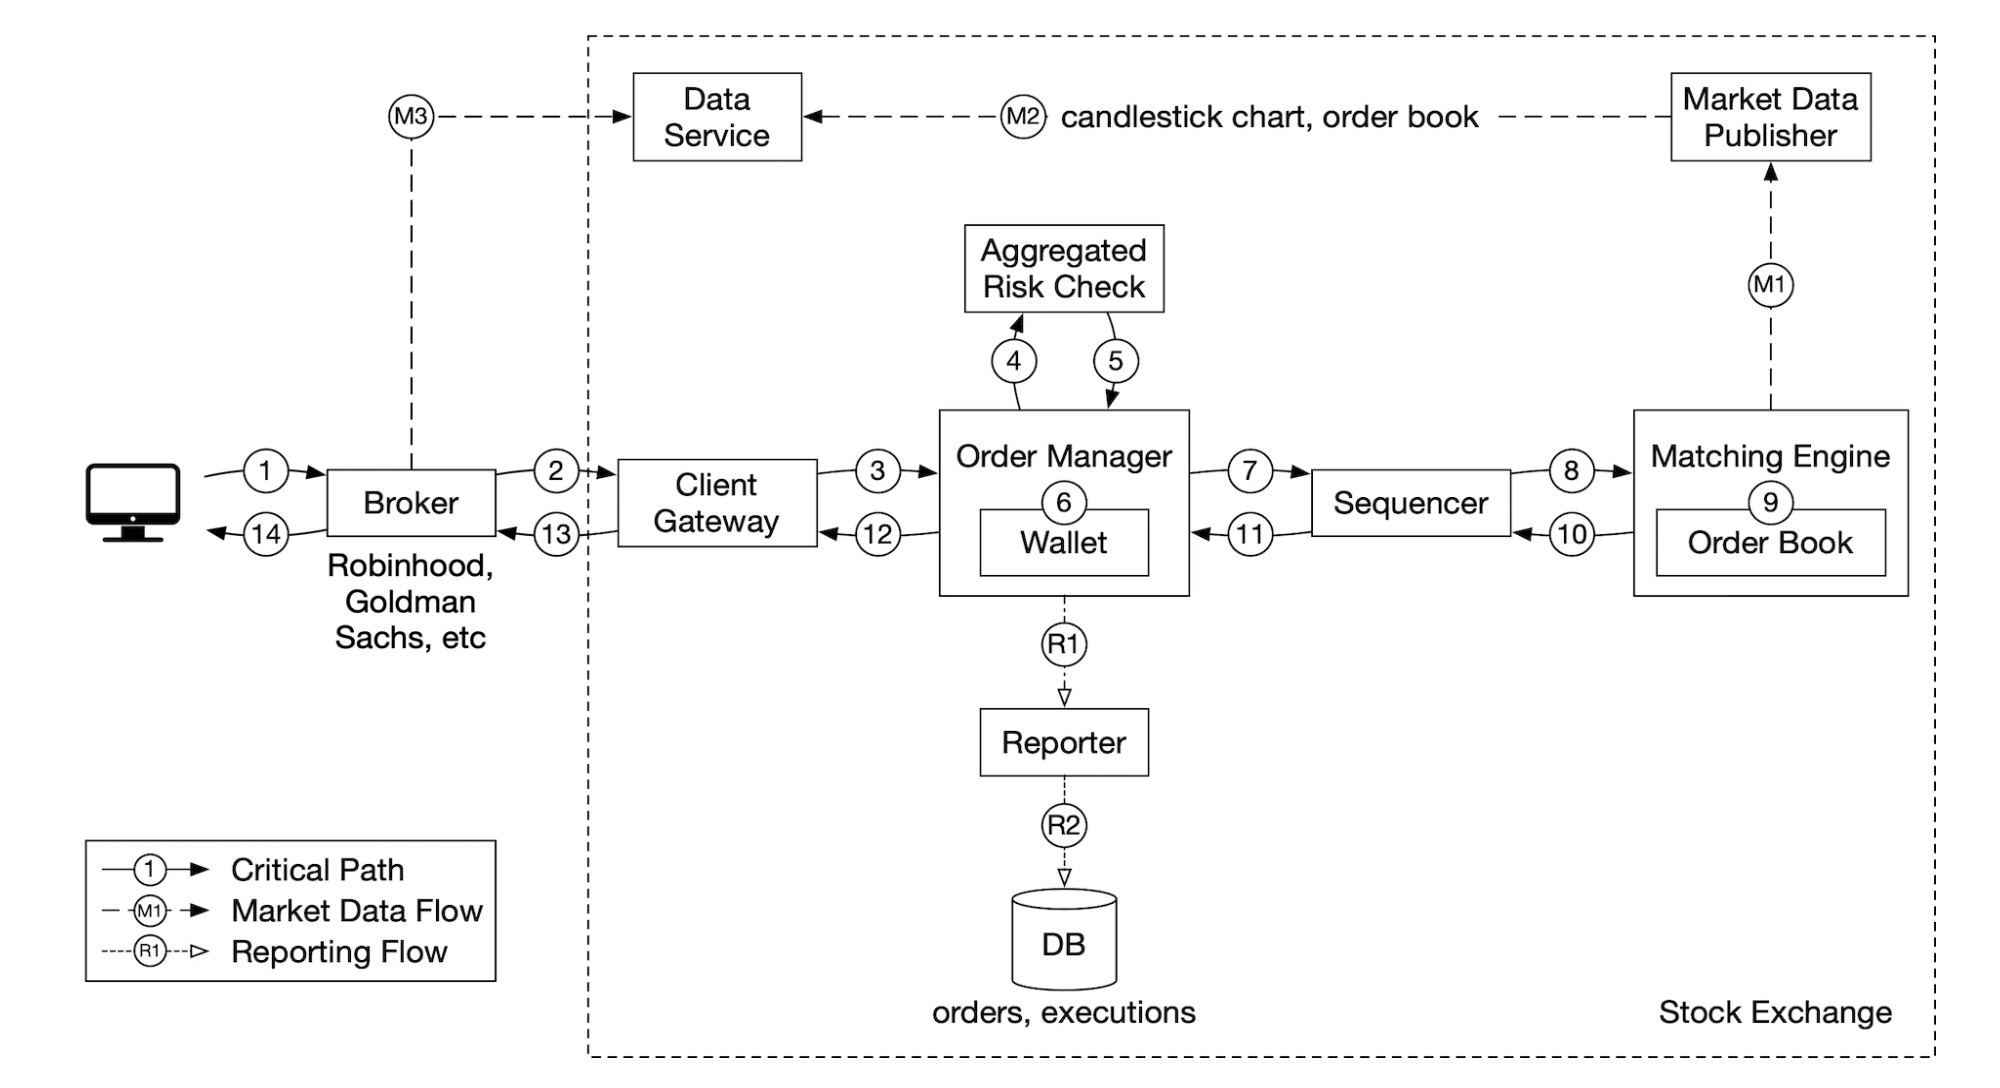
第三层是完整系统案例(Ch14–28,即卷二):YouTube、Google Drive、附近服务/附近好友/Google Maps、消息队列、监控告警、广告点击聚合、酒店预订、分布式邮件、S3 对象存储、游戏排行榜、支付、数字钱包、证券交易所。越往后越硬核——Ch28 证券交易所直接讨论单线程撮合事件循环、事件溯源和时序确定性。
三、最值钱的不是答案,是每章同一套「四步推演法」
通读后我的判断是:这份笔记真正价值 80% 来自它的结构一致性,而不是任何单章的结论。28 章全部按同一个骨架展开,以 Ch28 证券交易所为例:
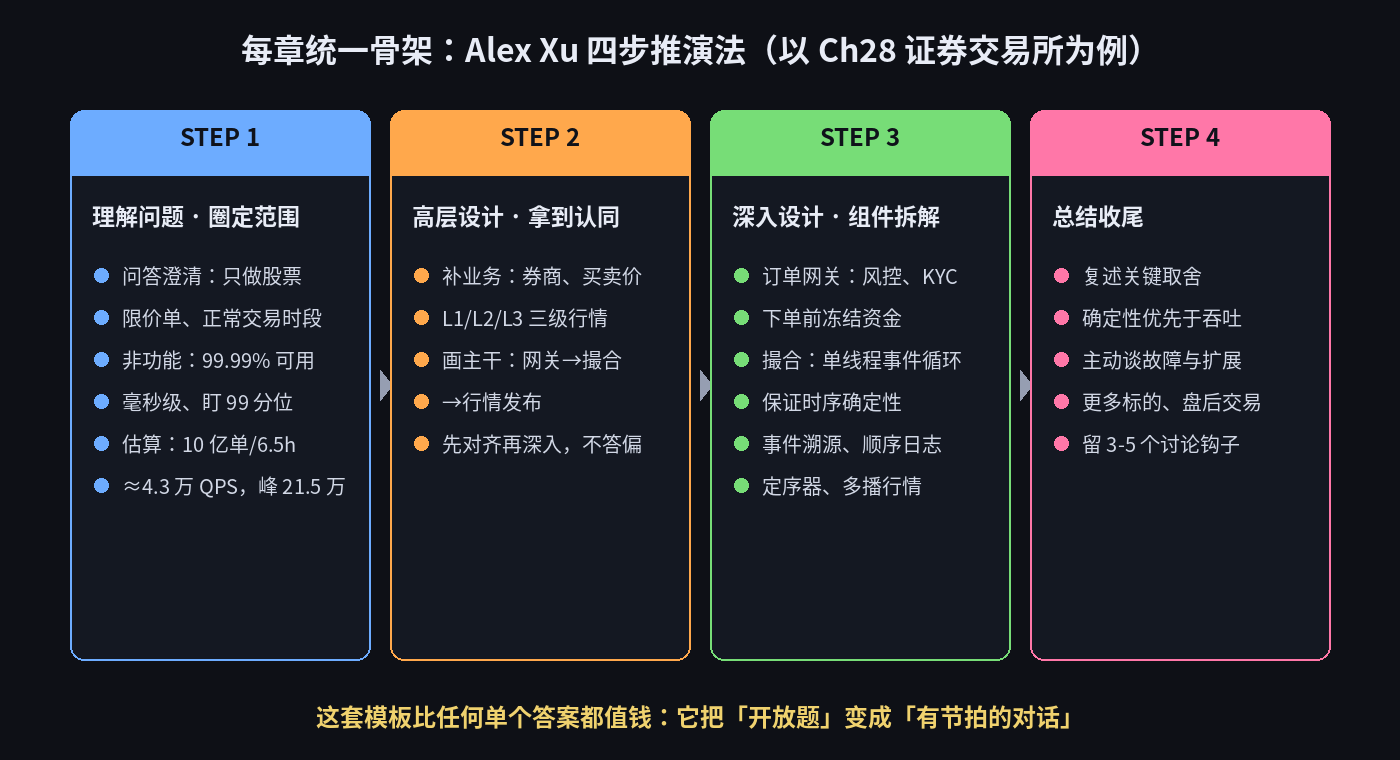
Step 1 理解问题、圈定范围。 笔记直接用面试官(C)和候选人(I)的问答体开场:支持哪些证券?——先只做股票;支持哪些订单类型?——只考虑限价单、只支持正常交易时段。然后是非功能指标:99.99% 可用性、毫秒级往返、重点盯 99 分位延迟。最后是信封估算:10 亿订单 / 6.5 交易小时 ≈ 4.3 万 QPS,开盘峰值按 5 倍算是 21.5 万。这一步的意义是把一个无限开放的问题锁成一个有边界的问题。
Step 2 高层设计、先拿认同。 它会先补业务常识(券商是什么、bid/ask、L1/L2/L3 三级行情),然后画一条端到端主干:客户端网关 → 撮合引擎 → 行情发布。原书反复强调的纪律是:在深入任何组件之前,先让面试官认可大方向,否则后面画得越细错得越远。
Step 3 深入设计、组件拆解。 这是篇幅最大的部分:订单网关负责风控、KYC 和下单前资金冻结;撮合引擎用单线程事件循环保证撮合顺序的确定性;底层是事件溯源(event sourcing)、只追加的顺序日志、定序器,以及可靠多播推送行情。
Step 4 总结收尾。 复述核心取舍(这个场景下确定性优先于吞吐)、主动谈故障恢复和未来扩展(更多标的、盘后交易),并留出 3–5 个可以继续深入的讨论钩子。
这个模板在 28 章里重复了 28 遍,重复到你会形成肌肉记忆——这恰好是系统设计面试最需要的东西:它本质是一场有节拍的协作对话,而不是一场闭卷默写。
四、配图质量:它比绝大多数付费专栏画得清楚
392 张图是这份笔记第二个硬价值。我抽查了多张,确认它们是专门为教学设计重绘的矢量风格示意图,而不是截图堆砌:
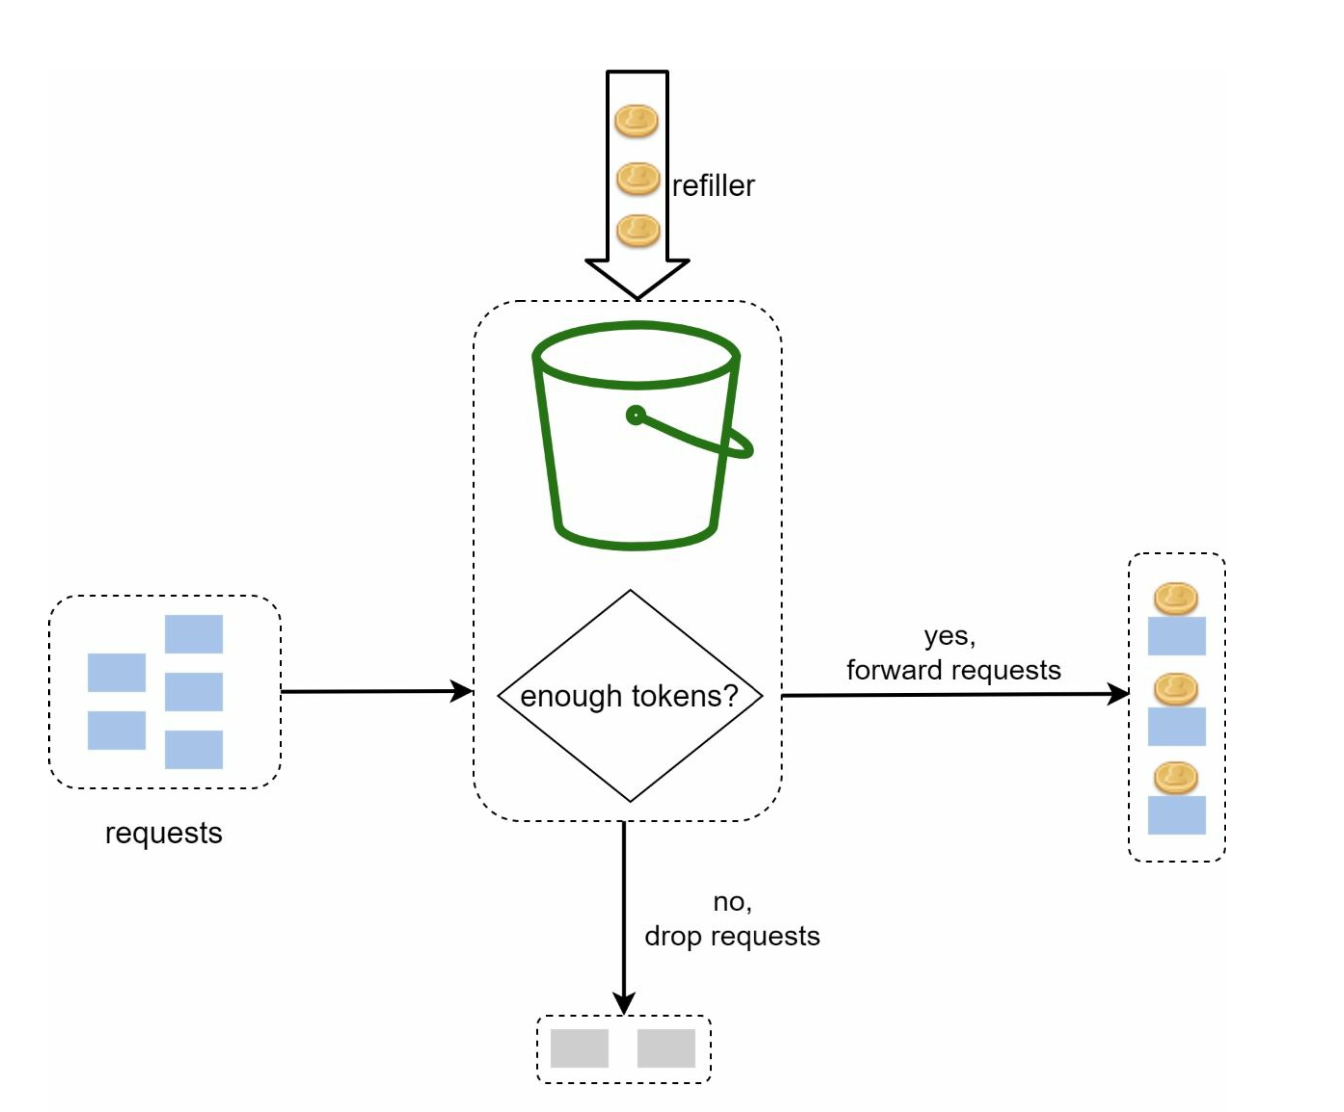
- Ch4 限流器把令牌桶、漏桶、固定窗口、滑动窗口日志、滑动窗口计数器五种算法各画了一张流程对比图,连「固定窗口在边界处放过两倍流量」这个经典坑都单独配图(
fixed-window-issue.png)。
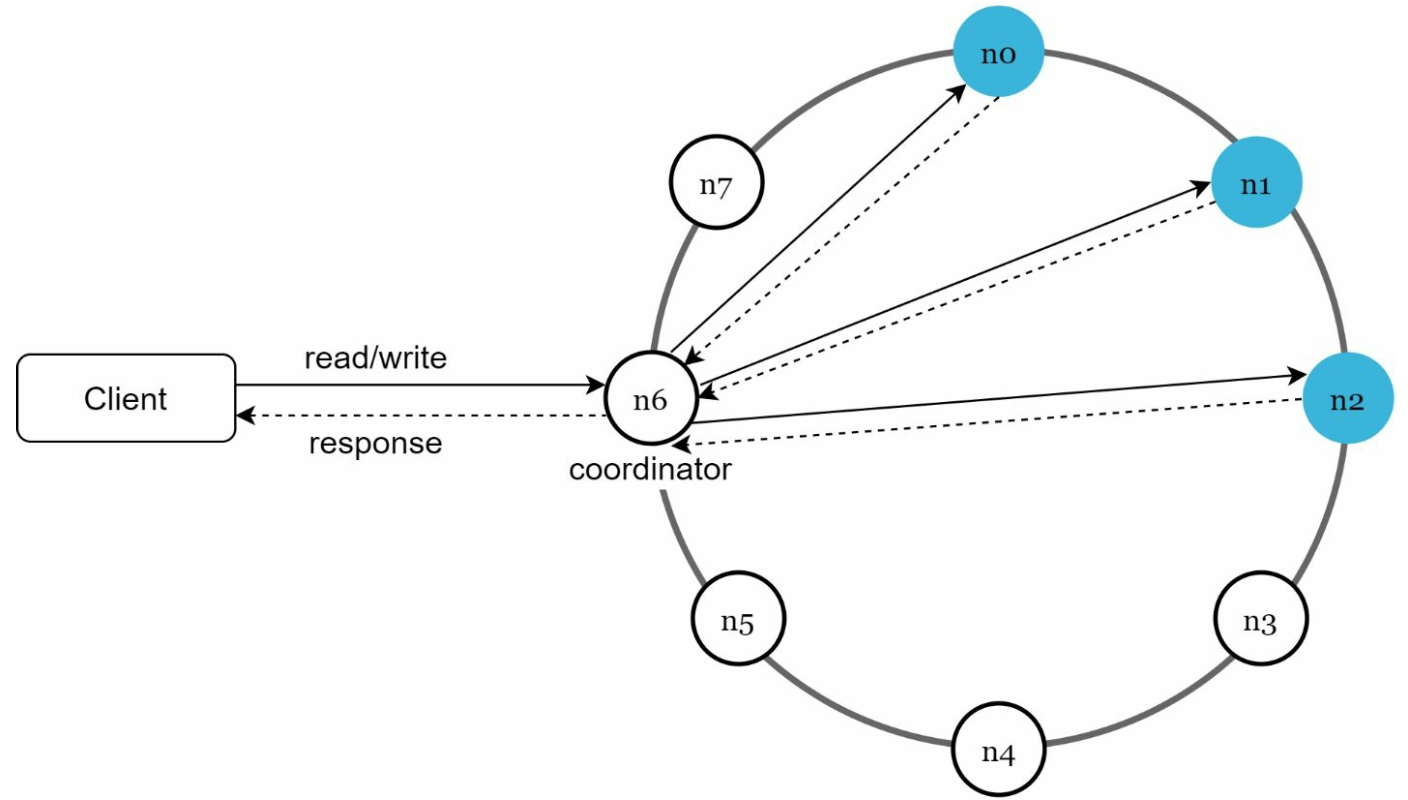
- Ch6 键值存储用 17 张图把一个 Dynamo 风格系统从哈希分桶、一致性哈希环、gossip、向量时钟、Merkle tree、quorum 一路画到最终架构。下面这张图完整表达了「协调者节点 n6 向环上 n0/n1/n2 三个副本转发读写、按 quorum 收回响应」的完整路径。
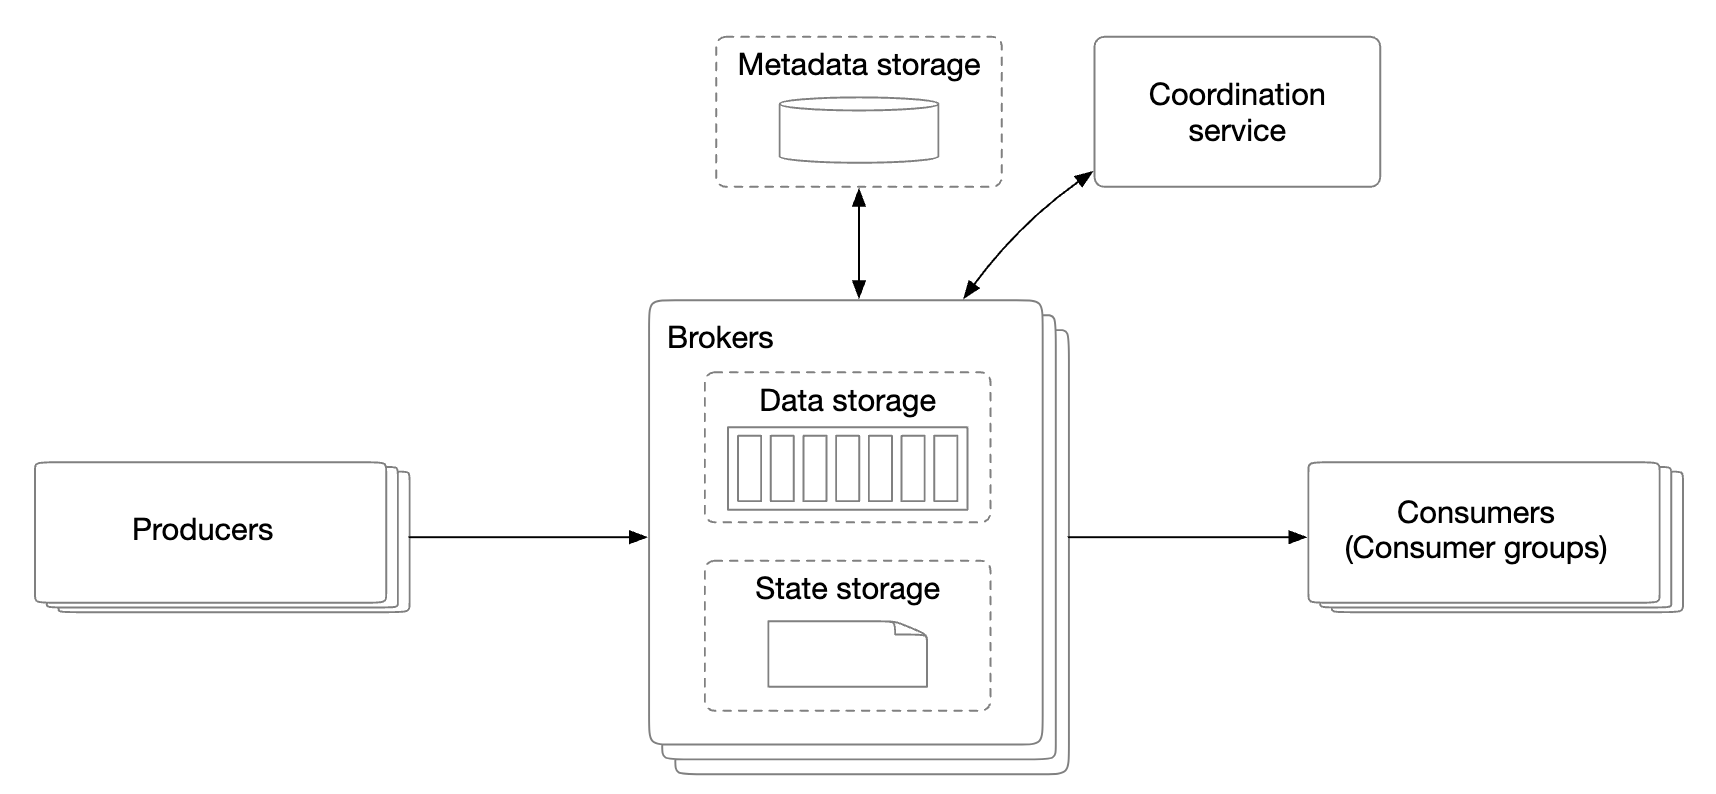
- Ch19 消息队列用 35 张图覆盖点对点/发布订阅模型、分区、消费者组重平衡(还专门画了「消费者无心跳被踢」「成员加入/离开」的时序)、ISR、WAL、三种投递语义(at-most-once / at-least-once / exactly-once)、批大小对吞吐和延迟的权衡。
对面试场景来说,这种图的价值在于:你不需要画得和它一样,但你可以直接借用它的抽象方式——哪些框是无状态服务、哪些圆柱是存储、虚线和实线分别代表响应和请求。能把图讲清楚,系统设计面试就赢了一半。
五、三个必须讲清的边界(别急着 star 完就背)
这是大多数推荐帖不会告诉你、但你必须知道的部分:
第一,没有 License,而且内容源自付费书。 仓库 README 第一行就注明笔记基于 Alex Xu 的两本《System Design Interview》,GitHub API 核查 license = null。这意味着:个人学习、私下对照完全没问题;但把它的图文搬运到自己的公众号、付费专栏、课程或商用材料里,存在明确的版权风险,fork 或二次发布同样不受开源协议保护。作者 liquidslr 还提供了一个 pagefy.io 的在线阅读版,在线浏览即可。
第二,它是二手笔记,不是原书的完整替代,更不是代码教程。 笔记是提炼版,原书里的许多推导细节、案例背景和习题被压缩;而且全仓库 0 行代码,指望学完就能手写一个 KV 存储或限流器是不现实的——动手实现要去对照 Ch6 引用的 Dynamo 论文、Cassandra 文档,或 Ch4 引用的 Uber ratelimit 源码。README 的 Additional Resources 区其实已经把每章对应的一手论文(Snowflake、Maglev、Bigtable、Dynamo 等)列好了,顺着这些链接读原文,才是正确的进阶姿势。
第三,部分常识数据有年代感。 Ch2 的延迟表标题明确写着 Latency (2020):L1 缓存 0.5ns、内存 100ns、SSD 随机读 150µs、HDD 寻道 10ms、机房内往返 500µs、跨地域 150ms。相对量级(内存比磁盘快五个数量级、跨洲网络是本地访问的百万倍)到 2026 年依然成立,也是面试估算唯一真正需要的东西;但如果你要在面试里引用具体绝对值,最好补一眼当代 NVMe(普遍十几到几十微秒甚至更低)和云厂商的最新 EBS 数据,免得被追问时露怯。
六、建议吃法:三周冲刺路线
这份资料最大的使用错误是「从 Ch1 顺序啃到 Ch28」。按它自身的三层结构,我建议的顺序是:
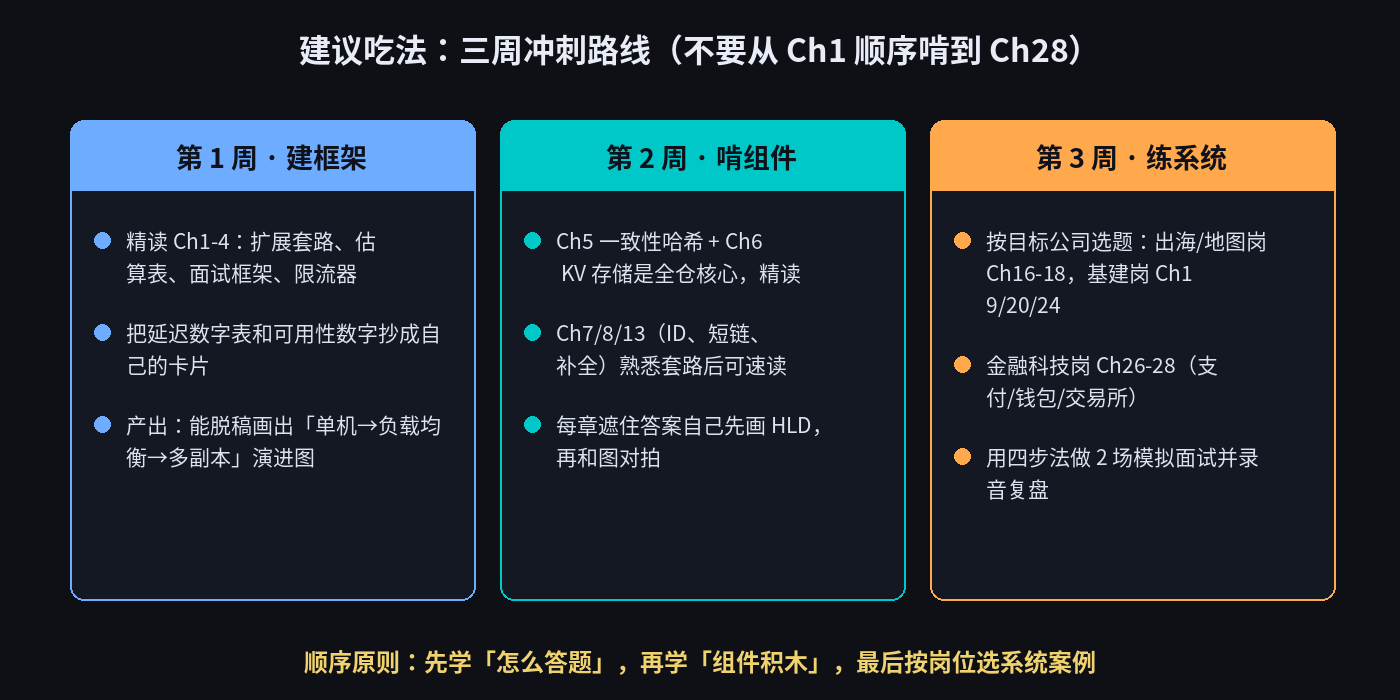
第 1 周建框架:精读 Ch1–4,把延迟表和可用性几个九抄成自己的速查卡,目标是能脱稿画出「单机 → 负载均衡 → 无状态化 → 多副本/缓存/队列」的演进图,并把四步法的节拍练熟。
第 2 周啃组件:Ch5、Ch6 精读(这是密度最高、复用性最强的两章),Ch7/8/13(ID、短链、补全)掌握套路后速读。关键方法是主动回忆:每章先遮住笔记自己画高层设计,再翻图对拍,差异处就是你的知识缺口。
第 3 周按岗位练系统:投出海/地图/LBS 岗重点看 Ch16–18;投基础架构/中间件岗重点看 Ch19、20、24;投金融科技岗重点看 Ch26–28(支付、数字钱包、证券交易所)。最后用四步法做两场完整模拟面试并录音复盘。
七、谁该用,谁该等
现在就值得收藏并投入时间的:
- 有 1–5 年后端经验、即将面对中高级/资深工程师系统设计轮,但脑子里的知识还是零散八股、缺一条统一推演主线的人——这份笔记的四步骨架就是为你准备的。
- 已经看过一些零散面试题、想要一张「分布式组件全景图」查漏补缺的人,Ch5–13 的组件层性价比极高。
- 英语阅读技术文档还行、但啃不下整本英文原书的人,5.2 万词的提炼版是合理的脚手架(读完仍建议按需补原书或论文)。
建议先等等或另找资料的:
- 零基础、连基本的数据库索引、HTTP、缓存概念都还不熟的新人——它默认你已经有这些底子,直接上会被术语劝退,先补基础再来。
- 想看真实大厂今天的生产架构(多租户、Kubernetes 上的容量规划、服务网格、AI 系统设计)的人——书的案例刻意保持经典和中立,不追新,卷一内容尤其如此。
- 想要可运行代码、可直接抄进项目的实现的人——0 行代码,这个仓库满足不了你,去找 DDIA 配套实现或具体开源项目源码。
结语
system-design-notes 被点到 2 万 star,靠的不是信息稀缺——Alex Xu 的书谁都能买——而是把一套优秀的推演结构重复、整齐、配图充分地铺到了 28 个题目上,让「怎么回答一个开放设计题」第一次变得可以模仿。它最像的东西不是一本答案集,而是一本带图的习字帖:临的是笔法,不是字本身。
所以正确的打开方式是:学它的四步节拍、借它的图的抽象方式、顺着它给的论文链接走向一手资料,同时对版权、零代码和 2020 年的数据保持清醒。把它当脚手架而不是终点,这份 2 万 star 的笔记才真正对得起它的星数。
项目 GitHub 地址:https://github.com/liquidslr/system-design-notes