不用 Chromium,网页是怎么被渲染出来的?我把 Obscura 0.2.2 真跑了一遍,还翻了它 7.3 万行渲染代码
不用 Chromium,网页是怎么被渲染出来的?我把 Obscura 0.2.2 真跑了一遍,还翻了它 7.3 万行渲染代码
「无头浏览器」这四个字,过去十年基本等于「再塞一个 Chromium」。Puppeteer、Playwright 本质上都是驾驶一个完整的 Chrome 内核——几百兆二进制、两百兆起步的内存、两秒启动。有没有人认真试过另一条路:不要 Blink、不要 Skia、不要合成器,自己把网页从 HTML 一路画成像素?
有。Obscura 这个 Rust 开源项目最近冲进了 Trendshift,Cloudflare 在开发它的 agent 浏览器 Kitesurf 时,第一个原型就是把 Obscura 移植到 Workers 上(Cloudflare 工程博客有记载)。本站 9 月 4 日介绍过它「30MB 内存平替 Chromium」的轻量特性,那篇偏功能速览;这篇我不重复参数表,只回答一个更硬的问题:一个不用 Chromium 的浏览器,渲染到底靠不靠谱?
我没有停留在 README。我下载了官方 0.2.2 的 x86_64-linux 发行二进制在本机真跑了一轮,又通读了仓库九个 crate 约 15.3 万行 Rust,特别是 7.3 万行的渲染层,以及它用来自证渲染正确性的 66 个像素级对拍夹具。这篇文章讲三件事:它的网页是怎么被画出来的、我实测的真实数字、以及什么场景能上、什么场景还得老实用 Chrome。
一、先看架构:九个 crate,从 CDP 帧到像素
Obscura 是一个 Cargo workspace,九个 crate 分层非常清楚。我按数据流画了一张图:
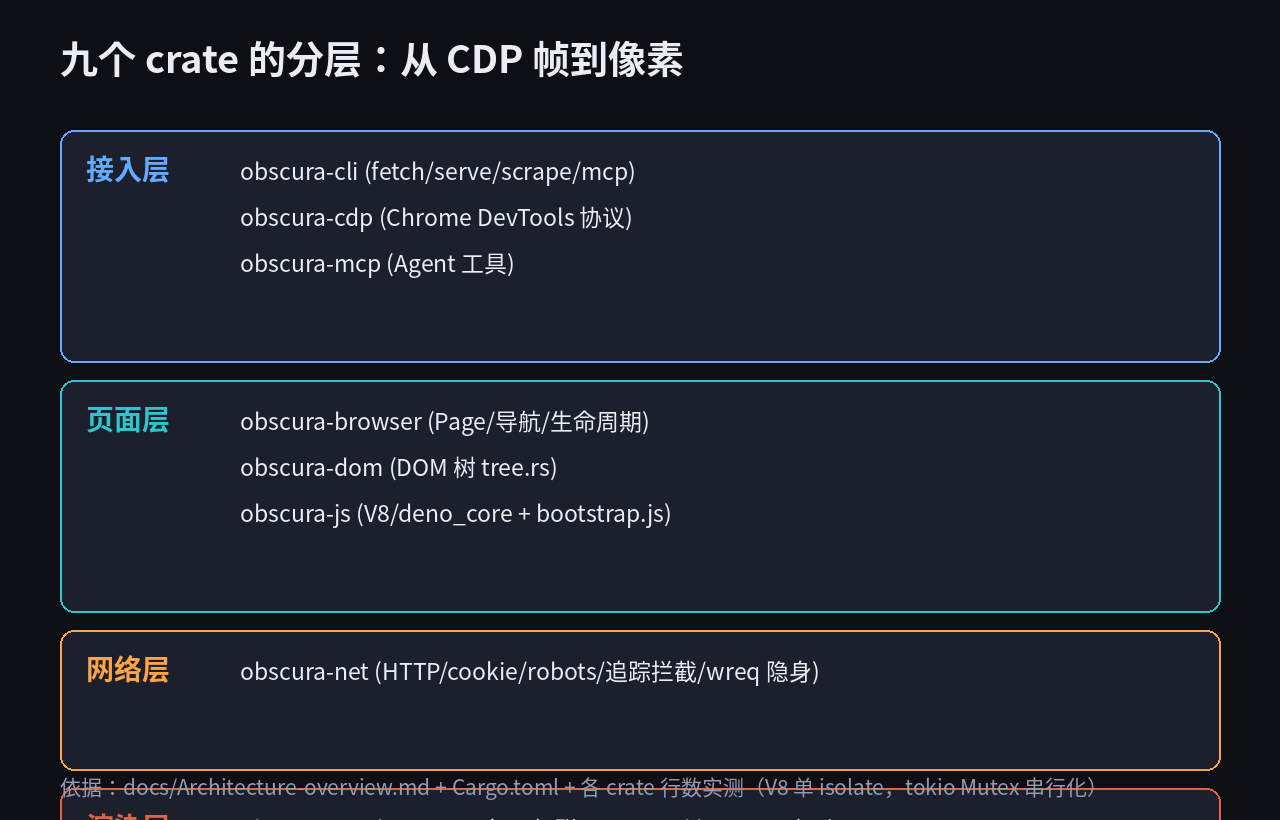
一个来自 Puppeteer 的 CDP(Chrome DevTools Protocol)请求,旅程是这样的:
- obscura-cdp(约 1.9 万行)实现了 Chrome DevTools Protocol 的 WebSocket 服务端,
server.rs收帧、dispatch.rs按 sessionId 路由。 - obscura-browser(约 1.1 万行)的
Page负责导航与生命周期。 - obscura-net 用 reqwest(rustls)发 HTTP,自己管 CookieJar、robots 缓存和追踪域名拦截;隐身构建则切换到 wreq/BoringSSL 传输。
- obscura-dom 用 html5ever 把 HTML 解析成一棵自己的 DOM 树(
tree.rs)。 - obscura-js(约 3.0 万行,是最厚的一层)通过
deno_core嵌入真正的 V8 引擎,js/bootstrap.js在 JS 世界里垫片出document、window、navigator、fetch、indexedDB等浏览器全局对象,Rust 侧的ops.rs把 DOM 操作桥接回 Rust。 - obscura-render(约 7.3 万行,全仓最重)负责 CSS 级联、计算样式、retained layout(保留式布局)、文本塑形和 CPU 绘制。
这里最能看出作者取舍的一点:JavaScript 是真的,渲染是自研的。 它没有假装自己能解释 JS——直接用 V8;但网页排版这块 Chromium 最复杂、最吃人力的地方,它选择自己写。排版基座是纯 Rust 的 Taffy(flex/grid),绘制用 CPU-only 的 tiny-skia,字形栅格化用 ab_glyph,复杂文本排版用 cosmic-text(后两者还以 patch/vendor 形式跟在仓库里)。也就是说,一个网页在 Obscura 里被画出来的路径是:
HTML ──html5ever──▶ DOM 树 ──▶ CSS 级联/计算样式
                                  │
JS ──V8/deno_core──▶ 改 DOM ◀──────┘
                                  ▼
              Taffy flex/grid + 自研块级/浮动/表格排版
                                  ▼
           cosmic-text/ab_glyph 塑形 ──▶ tiny-skia CPU 绘制 ──▶ PNG/PDF
文档里有句话很关键:布局几何在多次截图之间是保留的(retained),只在 DOM、样式、视口、滚动、动画、字体或资源变化时失效重算,而且同一套几何同时驱动 DOM API(比如 getBoundingClientRect)和最终绘制。这意味着它不是「截一张图算一遍」的玩具,而是有一个真正意义上的渲染引擎内核——这也是它敢自称 engine 而不是 screenshot tool 的原因。
二、它怎么证明自己没瞎画:66 个像素级对拍夹具
自研渲染引擎最大的信任问题不是「能不能画」,而是「画得对不对」。CSS 二十多年攒下来的边角行为——margin collapse、BFC 清浮动、table 轨道几何、containing block 的判定——任何一个写错,截图就是错的。
我在仓库里发现了一个很能说明工程态度的目录:render-repros/。里面有 66 个专门构造的 HTML 夹具,每个夹具针对一个具体排版行为,配一个 checks.json 用颜色块坐标做断言。比如:
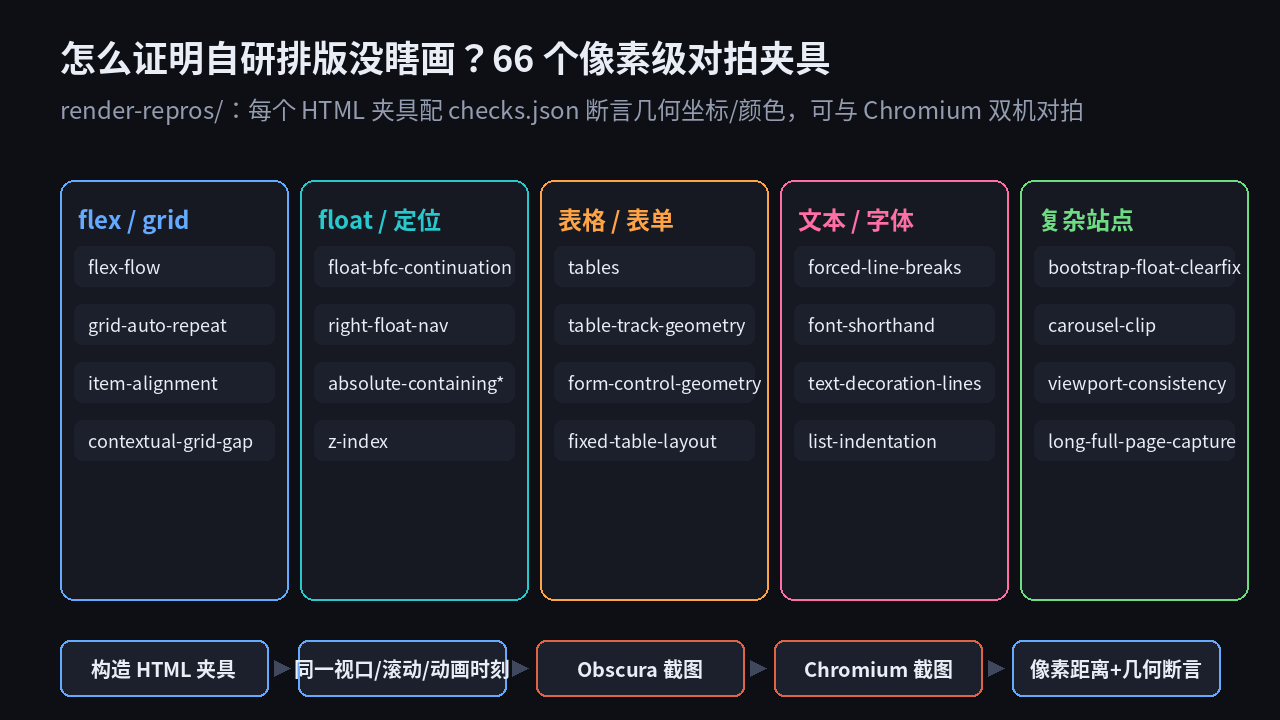
我翻了 checks.json,断言细到这种程度——对 absolute-containing-block.html,它要求「最近定位祖先」色块的精确坐标是 x:85 y:75 w:80 h:60,「fixed 视口包含块」必须在 x:520 y:40;对 block-auto-margins,它验证「两个 auto margin 让定宽块水平居中」「auto width 时 auto margin 归零」等五条规则。夹具覆盖五大类:flex/grid、float/定位、表格/表单、文本/字体,以及 Bootstrap 栅栏、轮播裁剪、长页面全截这类复杂站点场景。
更有意思的是它的对拍方法论(写在 AGENTS.md 里):同一视口、设备缩放、滚动位置、动画时刻、网络输入下,让 Obscura 和 Chromium 各截一张图做配对输出,先确认两边都导航成功、都非空白,再比对几何、文本流、裁剪边界、fixed/sticky 行为。作者明确告诫:像素距离只能当回归的「绊线」,不能单独当正确性判决;而且绝不为特定 hostname 写专属布局 hack——这是浏览器引擎和「适配型爬虫」的本质区别。
这套东西不是摆拍。仓库根目录的 build.log、render-repros/run.sh、paired-corpus.py、spot-sites.txt 都是可复跑的工具链;外部还有独立的 obscura-benchmark 仓库,里面有 33 个「障碍赛道」阶段,CI 要求保持 33/33 通过。对一个 0.x 版本的项目来说,这是我见过对「渲染正确性」最较真的自证方式之一。
三、我自己跑的数字:152ms、40MB,以及那些 README 没强调的细节
光读代码不够,我把官方二进制拉下来真跑了一遍(环境:Linux x86_64,发行包自带 obscura 与 obscura-worker,无需 Chrome、Node 或任何依赖)。
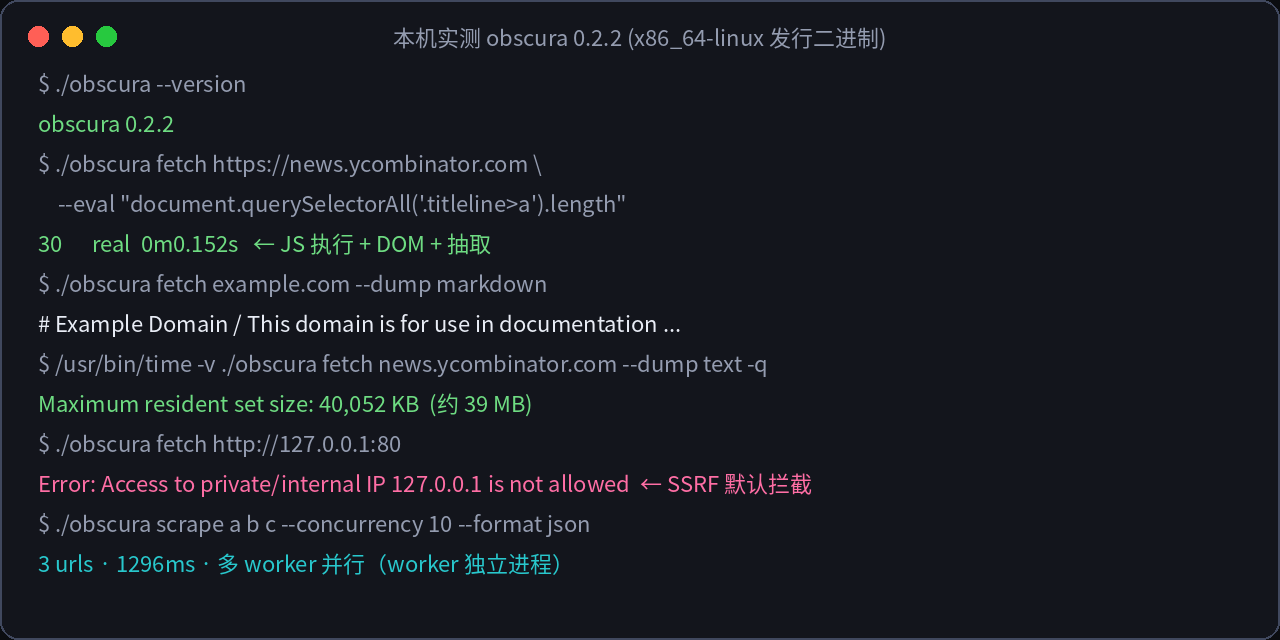
基础抓取真的快。 对 example.com 执行 JS 取 document.title,含进程启动的墙钟时间只有 0.176s;对 Hacker News 这种有真实 DOM 和脚本的页面,--eval 数出首页 30 条标题(document.querySelectorAll('.titleline>a').length 返回 30),墙钟 0.152s。README 标称静态页加载 51ms、框架页约为 Chrome 的 1/12,我的冷启动实测和这个量级一致。
内存实测 40MB。 我用 /usr/bin/time -v 量 HN 抓取的最大驻留集(Maximum RSS)是 40,052 KB,约 39MB——比 README 宣传的 30MB 略高(冷启动 + 真实页面),但对比 headless Chrome 的 200MB+ 仍然是一个数量级的差距。二进制本身 obscura 约 102MB、worker 约 92MB(debug 信息未裁,发行包压缩后约 70–80MiB)。
抽取能力是现成可用的:
./obscura fetch https://example.com --dump markdown
# → # Example Domain
#   This domain is for use in documentation examples ...
#   [Learn more](https://iana.org/domains/example)

./obscura fetch https://example.com --dump links     # 结构化链接
./obscura fetch https://example.com --dump assets    # NDJSON 子资源清单
对做 RAG、内容采集、AI agent 数据准备的人来说,--dump markdown 和 --dump assets 比「截图 + 自己解析」省掉整整一层。
并行 scrape 用多进程: 三个 URL、默认 10 并发,总耗时 1296ms,输出是带每个 worker、每条耗时的 JSON。这里有个架构细节值得讲:它的并发不是多线程共享引擎,而是 worker 独立进程(发行包里那个 obscura-worker)。原因在架构文档里——一个进程内所有页面共享单个 V8 isolate,而 isolate 设计上就是单线程的,用一把全局 tokio::sync::Mutex 把 JS 执行串行化。想要真正并行,就像浏览器开多进程那样开多个 worker。
安全默认值让我有点意外地放心。 我顺手抓了本机 127.0.0.1,直接被拒:
Error: Access to private/internal IP address 127.0.0.1 is not allowed
SSRF 防护默认开启(含 DNS 解析时检查),抓内网要显式加 --allow-private-network。对要把用户给的 URL 丢进浏览器的 agent 平台,这是个能挡住一类严重漏洞的默认项。健壮性上,架构文档还列了:V8 看门狗在独立线程里预算超时强杀(tokio::time::timeout 无法抢占同步 V8)、DOM op 用 catch_unwind 包裹不让 panic 穿过 FFI 炸进程、DOM 树拒绝成环的 reparent。这些都是「真被崩过才会写」的防御。
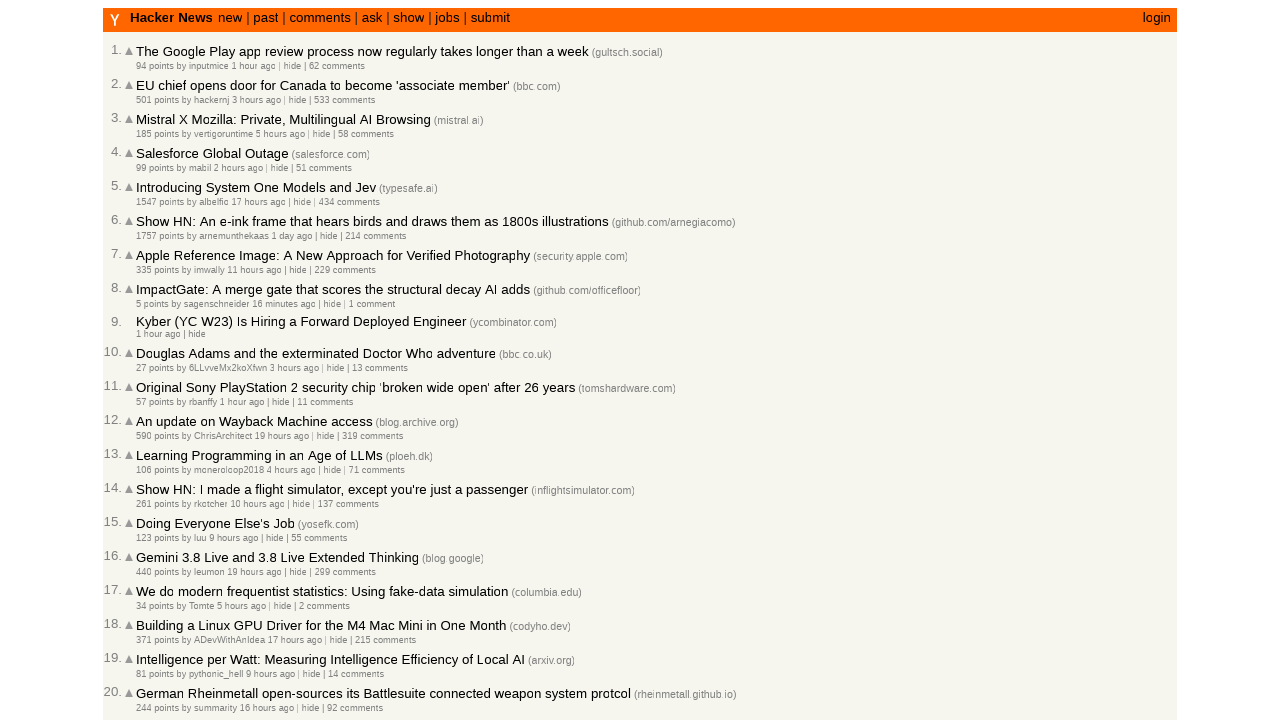
我也用它的自研引擎截了一张 HN 的全页 PNG(159KB),实际肉眼检查:橙色顶栏、30 条故事列表、投票箭头、两位数序号对齐、灰色元信息行全部正确,和 Chrome 截图几乎无差异,仅有极小字号里个别英文句点抗锯齿偏淡,不影响阅读。
四、隐身、CDP 兼容与它明确不支持的东西
隐身模式是编译期 feature(--features render,stealth),开启后做每会话指纹随机化(GPU/屏幕/canvas/音频/电池)、伪装高熵 navigator.userAgentData(Chrome 145)、让派发事件 isTrusted=true、Function.prototype.toString 返回 [native code]、把 navigator.webdriver 抹成真实 Chrome 的样子,并内置 3,520 个追踪域名的拦截。我在非隐身发行版上取 navigator.webdriver 得到 false。要注意:隐身额外编译 BoringSSL,需要 CMake/Clang/libclang,构建门槛比纯渲染版高。
CDP 兼容性覆盖 Target / Page / Runtime / DOM / Network / Fetch / IO / Storage / Input 等域,Puppeteer 用 puppeteer.connect({browserWSEndpoint})、Playwright 用 chromium.connectOverCDP() 可以直接接,文档还给了登录表单 POST + 302 + cookie 维持的完整示例。此外它自带 MCP server,能把截图/PDF 工具直接暴露给 Claude Desktop、Cursor 这类 agent。
但自研引擎的边界必须说清楚,README 自己也没藏着:
- 长尾 CSS、部分 Web API、媒体播放、合成器特效、平台字体栅格化可能与 Chromium 有差异。它当前覆盖 block/inline/flex/grid/table/float/positioning/overflow/transform/text/image/SVG/canvas/background/border/animation,但这是「持续演进的独立引擎」,不是 100% Blink。
- 我实测维基百科直连返回了它的
Wikimedia Error / Too Many Reqs限流页——这是数据中心 IP 被站点风控,和引擎无关(任何机房直连都会遇到),真实采集要配它支持的--proxy(HTTP/SOCKS5)或住宅代理。 - 重交互场景(复杂拖拽、WebRTC、视频播放、需要 GPU 合成的页面)目前不该指望它替代真 Chrome。
- 它仍是 0.x(二进制 0.2.2、workspace 包 0.1.0),且未发布到 crates.io,作为 Rust 库嵌入要用 git 依赖并本地编译 V8(首次约 5 分钟、几个 GB 磁盘)。
五、谁现在该换,谁继续用 Chrome
适合立刻上手的:
- 大规模内容采集 / RAG 数据准备:要抓成千上万个以文字和常规布局为主的页面,
--dump markdown/assets、40MB 内存、多 worker 并行、Docker 镜像基于 distroless 以非 root 运行(压缩约 57MB),密度和成本优势非常实在。 - AI agent 的受控浏览层:自带 MCP、SSRF 默认拦截、脚本预算看门狗、追踪拦截,这些是平台方真正关心的安全与稳定性开关。
- Serverless / 边缘 / 资源受限环境:Cloudflare 拿它做 Workers 原型本身就说明它的体积能塞进 Chromium 进不去的地方。
- CI 里的截图/PDF 流水线:无需装一整套 Chrome 依赖。
建议继续用真 Chrome 的:
- 需要像素级保真地渲染现代复杂 Web App、做跨浏览器视觉回归测试;
- 依赖视频、WebRTC、复杂表单交互、复杂指纹环境的场景;
- 团队没有能力在引擎出边角 bug 时自己定位或回退的(0.x 项目要有这个心理准备)。
结语
Obscura 真正值得看的,不是「30MB 对 200MB」这个数字,而是它回答了一个更大的问题:在 AI agent 成为浏览器主要使用者之一的时代,浏览器是不是还必须为「人盯着看的富交互页面」这个 1990 年代的目标,背负整套 Blink 的重量? 它给出的答案是——对一大批「取数据、截图、生成 PDF、让 agent 点按」的任务,一个 V8 加一套自研但有 66 个对拍夹具和 33 关障碍赛道守着的渲染引擎,已经够用,而且轻一个数量级。
它今天还不是 Chrome 的全面替代,作者也从没这么宣称;但它把「自研浏览器引擎」从「不可能的巨兽」拉回到「一个可验证、可嵌入、可在 40MB 内跑起来的开源组件」。这或许才是它被 Cloudflare 看中、冲上 Trendshift 的真正原因。
项目地址:https://github.com/h4ckf0r0day/obscura,文档站 docs.obscura.sh,建议从 Releases 直接下载二进制体验。