一条爆款视频 1.15 美元:我读完 Hypit 源码,看懂了「克隆视频」的新打法
一条爆款视频 1.15 美元:我读完 Hypit 源码,看懂了「克隆视频」的新打法
AI 视频工具这两年卷得厉害,但所有玩家其实都挤在同一条赛道上:输入一句话,吐出一段视频。Sora、可灵、即梦、Veo,比的是谁的单镜头更惊艳。可真正靠短视频吃饭的人——投流团队、TikTok Shop 卖家、矩阵号工作室——痛点根本不在这一头。他们的日常是:盯着一条已经跑出来的爆款,翻拍 50 个开头钩子、换 3 个主播、翻译成 10 种语言,两周后素材疲劳了再来一轮。一条视频不难,难的是把同一条结构跑一百遍。
这周我通读的开源项目 Hypit 直接把这件事翻译成了工程问题。它的口号很嚣张——「Clone any viral video with AI agents,1 command, 100 variants, 100M views」——但翻完仓库我得说,它的底气不是模型,而是一套语言:仓库 2026 年 7 月底才建仓,一个半月已经 1000+ star,当前 v0.1.8,monorepo 里拆了 100 多个 workspace 包,配套 VitePress 中英双语文档和三个制作资料完整的样片。这篇文章回答三个问题:它和文生视频工具到底差在哪、「一条片子 1 美元」的钱具体怎么花的,以及什么人现在就该上车、什么人应该再等等。
一、它不是文生视频工具,是给 AI Agent 的「视频编程语言」
先纠正最容易产生的误解。Hypit 本身不训练任何模型,你也不会在一个网页里点按钮。它的安装方式是这样的:
npx skills add hypit-ai/hypit -g
装的不是一个 App,而是一份给 Claude Code、Codex 这类 Coding Agent 用的 Skill(制作知识与工作流),加一个叫 hypit 的可执行发行版(工具链)。之后你在任意空目录里对 Agent 说:
/hypit Clone this video: /path/to/video.mp4
Agent 会调 WhisperX 把参考片拆成词级时间轴,分析片子为什么有效(钩子、字幕落点、B-roll 节奏),再用一种叫 SVML(Semantic Video Markup Language)的 XML 方言把视频写成一份可编辑、可重跑的「源代码」。README 里那张官方演示图最直观——左边是 SVML 源码,右边是实时渲染的画面:
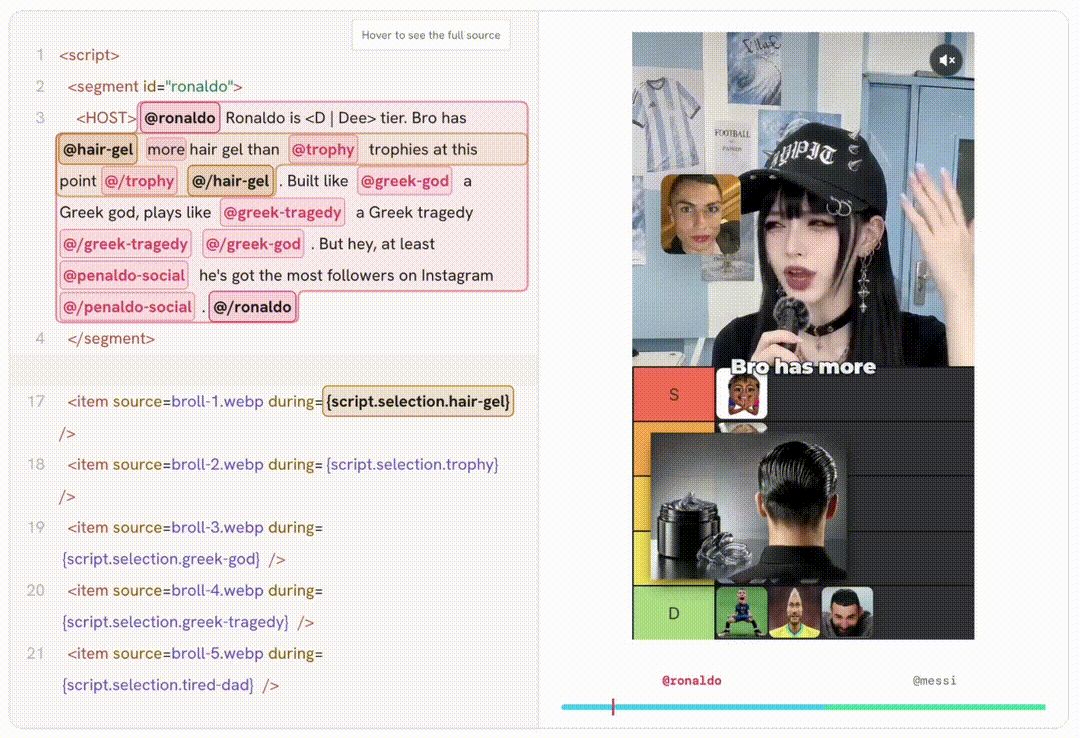
注意左边源码里那种写法:Bro has @hair-gel more hair gel than @trophy trophies ... @/trophy@/hair-gel。这不是字幕,这是在剧本里给「发胶」「奖杯」这些词打锚点,右边的搞怪 B-roll、榜单动画全部绑在锚点上。
这个设计引出了 Hypit 全文最重要的一句话,我认为也是它全部架构的地基,出自 docs/quickstart/script.md:Script 是 prose-first 的——没有时间码、没有媒体引用、没有样式、没有生成参数;流水线上的一切都读 Script,Script 什么都不读。
二、视频不是渲染出来的,是编译出来的
传统剪辑(剪映、CapCut、Premiere)活在秒的世界:字幕钉在 00:03.2,B-roll 钉在某个入点,音效钉在某个帧。台词改长两秒,后面全线错位,逐轨手动修。Sora 类工具换了个极端:整个画面都交给模型,一个视频文件出去,没有任何结构可以编辑——想改?重新生成,听天由命。
Hypit 选了第三条路:时间轴不是作者写的,是编译出来的。
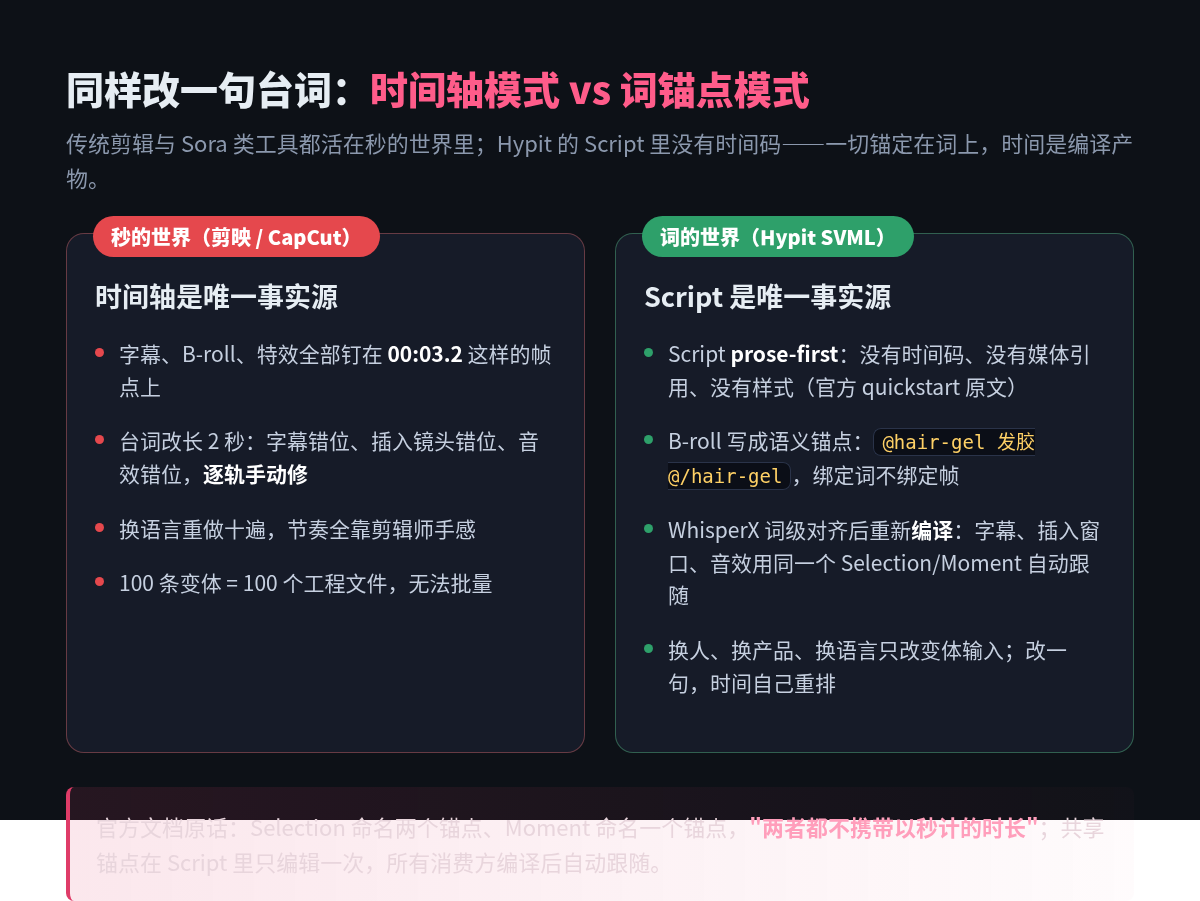
文档 packages/temporal-markup/EDITING.md 把这套语义写得很严谨:Selection 命名两个锚点、Moment 命名一个锚点,「两者都不携带以秒计的时长」。你说的话经 TTS 生成表演、经 WhisperX 对齐后,TemporalInstant 和 TemporalWindow 才被投影出来,字幕组件、榜单组件、音效各自消费自己需要的窗口。规则也给得很工程化:「一个共享的 Selection/Moment 在 Script 里只编辑一次,所有消费方编译后跟随;放进轨道并不会产生私有副本。」
这直接决定了「克隆」为什么成立。官方足球 Tier List 样片(examples/ranking-football/)自带三个变体目录:swap-host(主播换成香蕉猫)、swap-topic(球星换成科技大佬)、swap-effect。换主播不碰字幕,换语言时文档承诺「改写一行,时间自己重流(rewrite a line and the timing re-flows itself)」,因为所有东西挂在词上,而词的时间是每次构建重新算的。第二条视频几乎零成本,第一百条是一个循环——这是 README 的原话,也是这套语言真正的产品承诺。
顺带一个容易被忽略的设计:Dual Text。屏幕字幕和实际念白可以不一样,<SVML | semantic video markup language> 左边进字幕、右边进语音和 TTS,做本地化和口播差异时不用维护两份稿。
三、四层架构:100 多个包,把「制片厂」拆成岗位
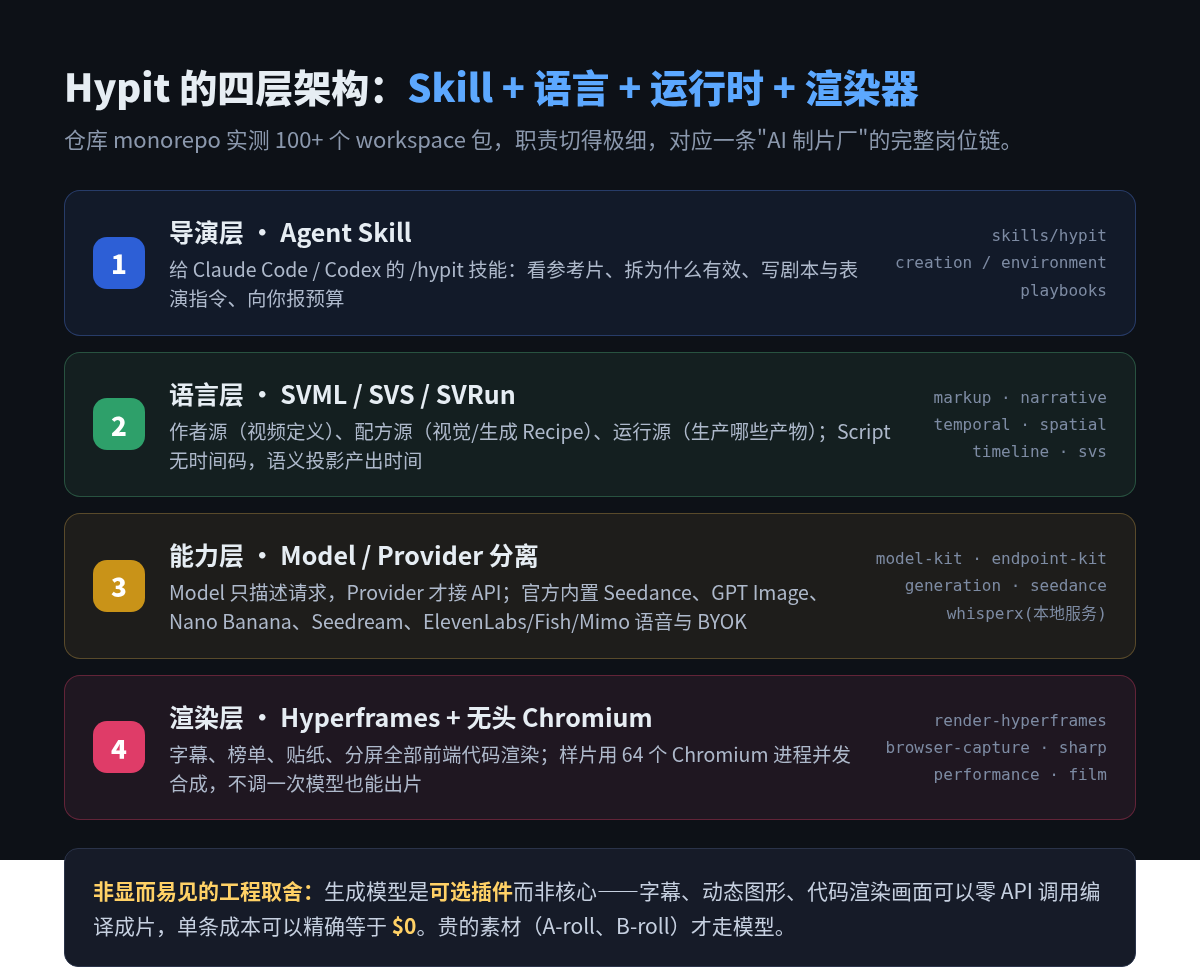
我数了 packages/ 目录,100 余个包按四层归位:
- 导演层 Skill:
skills/hypit/SKILL.md本身就是一篇相当克制的「导演手册」——要求 Agent 先看完整参考片、读出画面为何抓人,在花钱、装本机服务、涉及隐私素材前必须把选择权交还给用户。 - 语言层:
markup(SVML 编译)、narrative、temporal/spatial/timeline、svs(Recipe 配方)。三类源文件分工明确:.svml定义视频,.svs定义可复用的视觉/生成配方,.svrun声明这次要产出哪些结果。 - 能力层:这是我认为最值得抄的设计——Model 和 Provider 严格分离。Model 包只描述「我要一个 9:16、2K 的说话人视频」,Provider 包才知道怎么打 Seedance、GPT Image、ElevenLabs 的 API。官方自带 Seedance、Seedream、GPT Image、Nano Banana、Grok Imagine、MiniMax H3、ElevenLabs/Fish Audio/Mimo 语音,外加本地 WhisperX、yt-dlp、OpenCV 三个 Python 微服务(各自独立 uv 项目)。换模型、换 Key、换自建端点,改动半径锁在 Provider 里。
- 渲染层:
hyperframes+render-hyperframes+browser-capture。字幕、卡拉OK高亮、Tier 榜单、评论贴纸、分屏访谈全部是前端代码,用无头 Chromium 渲染。三个样片的制作说明里都写着同一句话:64 个无头 Chromium 进程并发渲染。
最后一点藏着一个非显而易见的工程取舍:生成模型在这个体系里是可选插件,不是核心依赖。 README 明确说,一条工作流可以只编译字幕、动态图形和代码渲染画面,不调任何一个模型——成本精确等于 0 美元。贵的只有 A-roll(会说话的人物镜头)和 B-roll 梗图,花多少钱完全由你的 .svrun 决定。
四、1.15 美元的账单,以及「先报价后花钱」的状态机
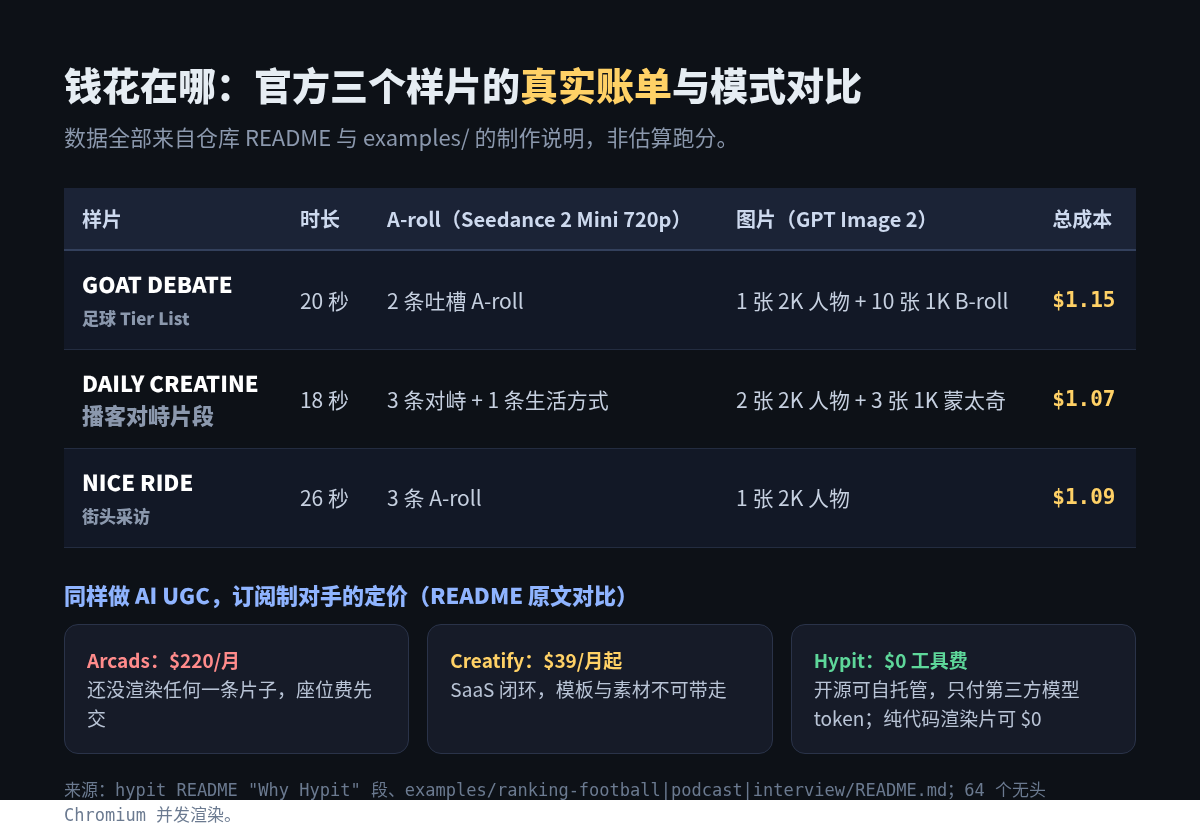
这些数字不是跑分估的,是 README 和每个 examples/*/README.md 里的制作记录:20 秒足球榜,2 条 Seedance 2 Mini 720p A-roll + 1 张 2K 人物 + 10 张 1K 梗图,1.15 美元;18 秒播客对峙,1.07 美元;26 秒街头采访(还接了 Google Video Intelligence 和 YOLOv8 AnimeFace 做人脸追踪字幕),1.09 美元。作为参照,README 直接点名 Arcads 220 美元/月、Creatify 39 美元/月——座位费,渲染前先交。
钱怎么控制?CLI 的工作流本身就是一道审批闸:
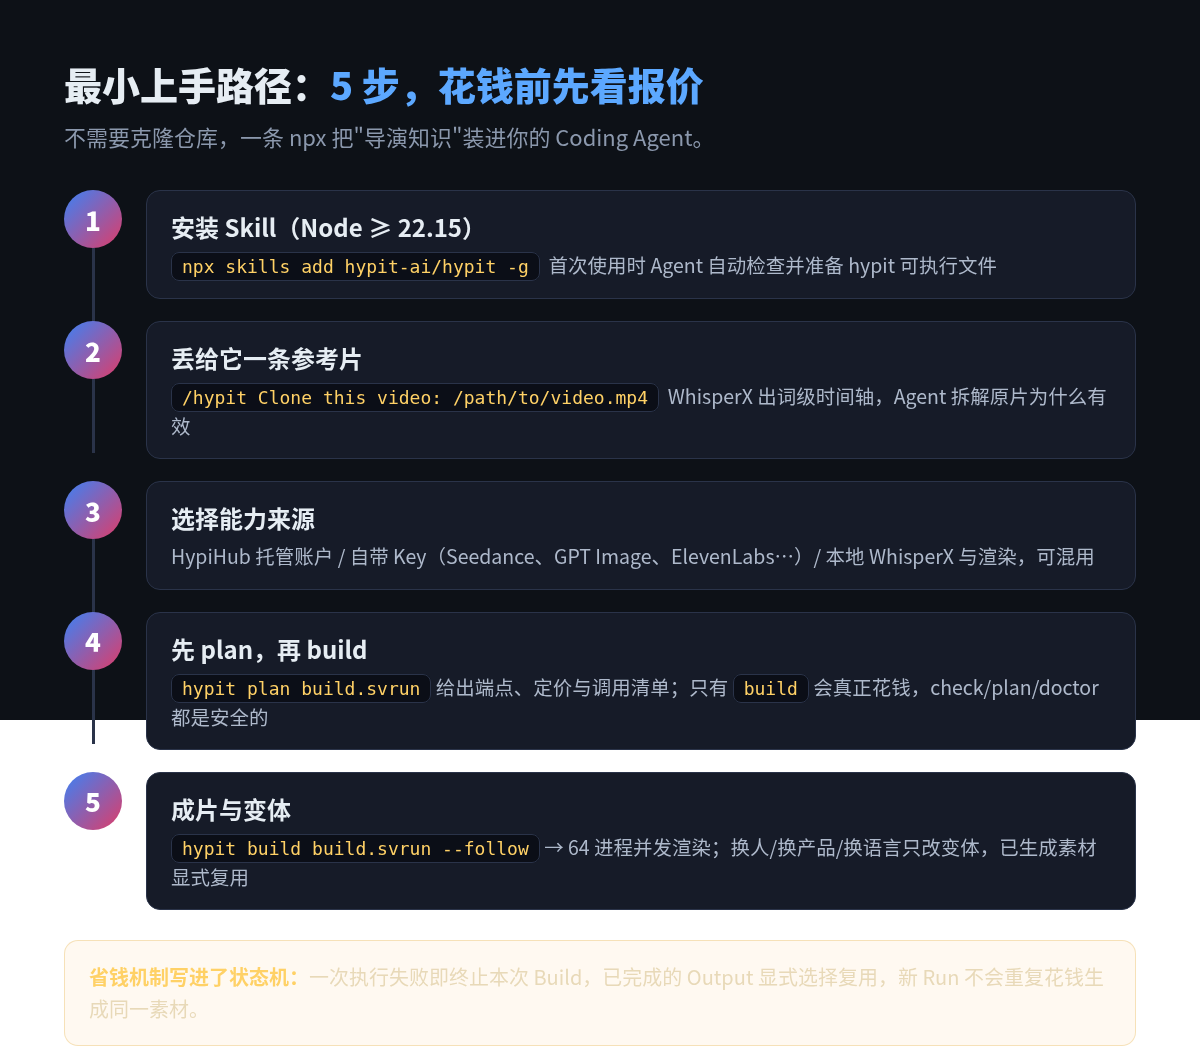
hypit check 是编辑辅助,hypit plan 只产出计划和端点定价,hypit doctor 是部署诊断——文档反复强调「只有 build 会提交工作、才会花钱」。Provider 可以读取实时费率并附上原始定价页出处,登录成功和授权花钱被明确区分成两件事。更实在的是 Build 状态机的失败语义(docs/guide/conventions.md):一次执行失败,本次 Build 立即终止;已完成的 Output 显式选择复用,新 Run 不会为同一段素材重复付费。跑矩阵号的人会懂这条值多少钱。
五、一个容易被忽略的副产品:Skill 本身就是「导演手册」
通读 skills/hypit/SKILL.md 时我有个额外收获:这份给 Agent 的指令写得不像工具文档,更像一份导演现场守则。它要求 Agent 先完整看完参考片、读出每个切点和贴图在「回应」剧本里的哪句话,再谈翻拍;A-roll 的表演指令要具体到表情转换和手势留白,而不是堆满形容词;等待模型生成时并行推进字幕与图形,而不是空等;在花钱、安装本机推理服务、使用隐私素材前必须暂停并把选择权交还用户。对任何想用 AI 批量生产视频的人来说,这份可自由阅读的 Skill 已经是一个浓缩的短视频工业知识包——哪怕不跑工具,拿它校准自己给模型下指令的方式都值回票价。
六、真实门槛:协议、环境、和「Agent 即操作员」
泼三盆冷水,都是仓库里能核实的:
- 这不是纯净 Apache-2.0。 LICENSE 是修改版:自己组织内部商用(包括给自家应用当渲染后端、给客户做单租户交付)允许;但多租户 SaaS、商业转售必须另外拿商业授权,CLI、运行报告里的名称 LOGO 不得去除。打算套壳开服务的,这条路协议上是堵死的。
- 本地环境不轻。 Node ≥ 22.15、pnpm 10.33;要做词级对齐建议备一台能跑 WhisperX 的机器或用 HypiHub 托管;64 进程并发渲染吃的是你自己的 CPU/内存。不想折腾就走 hypit.ai 的托管账户,但那样数据与账单就回到平台手里了。
- 操作员是 Agent,素材成本是模型账单。 它的上限和下限都取决于你用的 Claude Code/Codex 水平,以及 Seedance/GPT Image 们当天的发挥;样片里人物照片、音效 BGM 仍是自备素材,生成的只是其中一部分。项目极年轻(v0.1.8,issue 区几乎是空的),生产级稳定性要自己验。
七、判断:谁现在就用,谁再等等
建议立刻试的: 付费投流/带货团队,一条广告结构跑通后需要 50 个钩子变体的;做 TikTok、Reels、Shorts 矩阵、追求「同一结构换皮量产」的工作室;想把视频生成能力编排进自己流水线、对 Model/Provider 可插拔有刚需的开发者——这个 monorepo 的包边界和 SDK 设计(author-kit、model-kit、endpoint-kit)本身就是值得学的参考。
建议再等等的: 只想输入一句话出大片、不写代码也不养 Agent 的用户——它明确不是给你做的;对素材私密性要求极高、又没有自托管算力的团队;以及想直接套壳做成多租户 SaaS 的创业者,先谈商业授权。
我的总体判断:文生视频赛道卷的是「模型的一次灵感」,Hypit 押注的是**「结构的一百次复用」**。它把短视频里最不值钱的重复劳动(对齐、上字幕、换皮、重排时间轴)编译掉,把人和 Agent 的精力逼回到真正稀缺的事上——选题、钩子和品味。这条路线对不对,要看有多少跑量团队真的把工作流迁过来;但「视频是编译出来的」这个视角,值得每个做 AI 视频的人认真想一遍。
项目地址:https://github.com/hypit-ai/hypit ,文档站 hypit.ai,建议从 docs/zh/quickstart.md 和三个 examples/ 的制作笔记入手,比 README 信息量大得多。