一句话怎么变成分钟级长视频:我读完 12.4k star 的 ViMax 源码,拆清它的 13 个 Agent 导演组
一句话怎么变成分钟级长视频:我读完 12.4k star 的 ViMax 源码,拆清它的 13 个 Agent 导演组
单镜头 AI 视频早就不稀奇了。可灵、即梦、Veo 随手就能出一段 5 秒、10 秒的惊艳画面。真正的分水岭在另一头:当一条片子需要几十上百个镜头、横跨多个场景、同一批角色反复出场,怎么让他们不变脸、不换位、不穿帮? 这不是再调一个更强模型能解决的,它是个编排问题。
这周我通读的开源项目 ViMax 正盯着这块硬骨头。它出自香港大学数据科学实验室 HKUDS——也就是做出 LightRAG 的那个团队——GitHub 上 12373 star、1861 fork,有 arXiv 论文(2606.07649),MIT 协议,2025 年 3 月底建仓,当前版本 v1.2.0。它的自我定位是「Agentic Video Generation」:把一句话创意、一份剧本、甚至一部长篇小说,自动改编成叙事连贯、角色一致的分钟级视频。我把仓库克隆下来,通读了约 1.37 万行 Python(13 个专职 Agent、三条 pipeline、agent_runtime、Web UI 和测试),这篇回答三个问题:这「13 个 Agent 的导演组」具体怎么分工,源码里哪些设计是真功夫,以及哪些地方 README 说得比代码满。
一、它不是「一个大 Agent」,是一条分了岗位的制片厂流水线
README 给了四个入口能力:Idea2Video(创意成片)、Script2Video(剧本成片)、Novel2Video(小说改编)、AutoCameo(拿参考照片把真人/宠物融进故事)。但光看功能列表看不出门道,真正的结构在 agents/ 目录里——13 个职责单一的模块,像制片厂的岗位表:
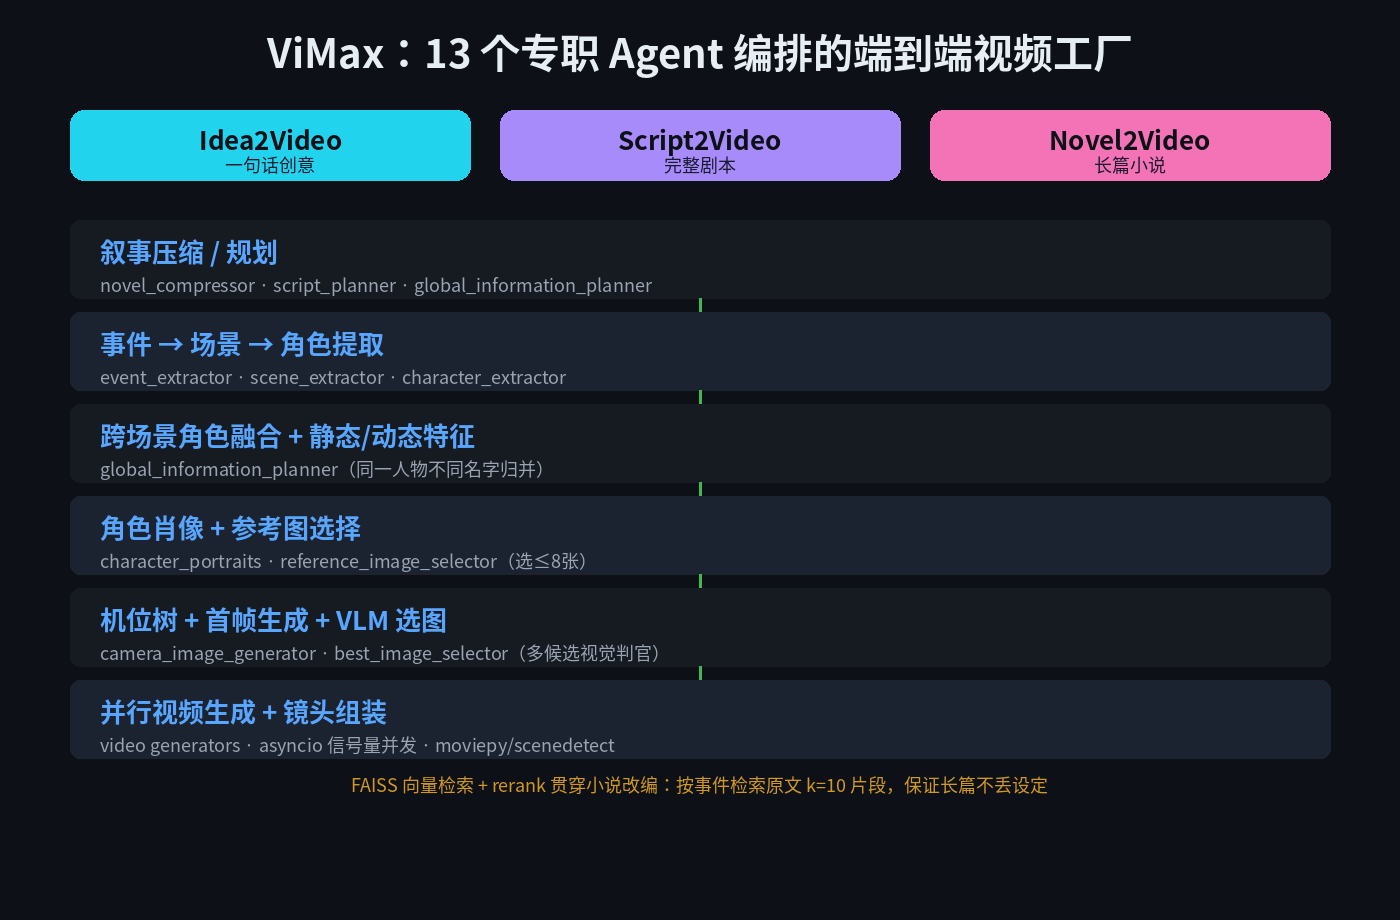
叙事侧有 novel_compressor(小说压缩)、script_planner / screenwriter / script_enhancer(剧本规划、编剧、强化)、global_information_planner(全局信息规划,368 行,是角色融合的核心);拆解侧有 event_extractor、scene_extractor、character_extractor(事件、场景、角色提取);视觉侧有 character_portraits_generator(角色肖像)、reference_image_selector(参考图选择,237 行)、camera_image_generator(机位树与首帧,273 行)、storyboard_artist(分镜,275 行)、best_image_selector(视觉判官,148 行)。
三条 pipeline 不是各写一套:novel2movie_pipeline.py(1010 行)和 idea2video_pipeline.py(271 行)最终都复用 822 行的 script2video_pipeline.py 作为渲染后端——也就是无论你从创意、剧本还是小说进来,到了「分镜→首帧→视频→组装」这一段走的是同一套代码。这是个很务实的收敛:三条入口只负责把不同形态的输入归一成结构化剧本,后面只有一条主干。
二、几百个镜头怎么不「变脸」:三层一致性机制
这是我最关心、也是 ViMax 最值得讲的部分。AI 长视频的崩坏几乎都发生在跨镜头:第 3 镜的男主和第 40 镜的男主像两个人,或者 A 明明在画面左边下一秒跑到了右边。ViMax 用三层机制叠加来压这个问题。
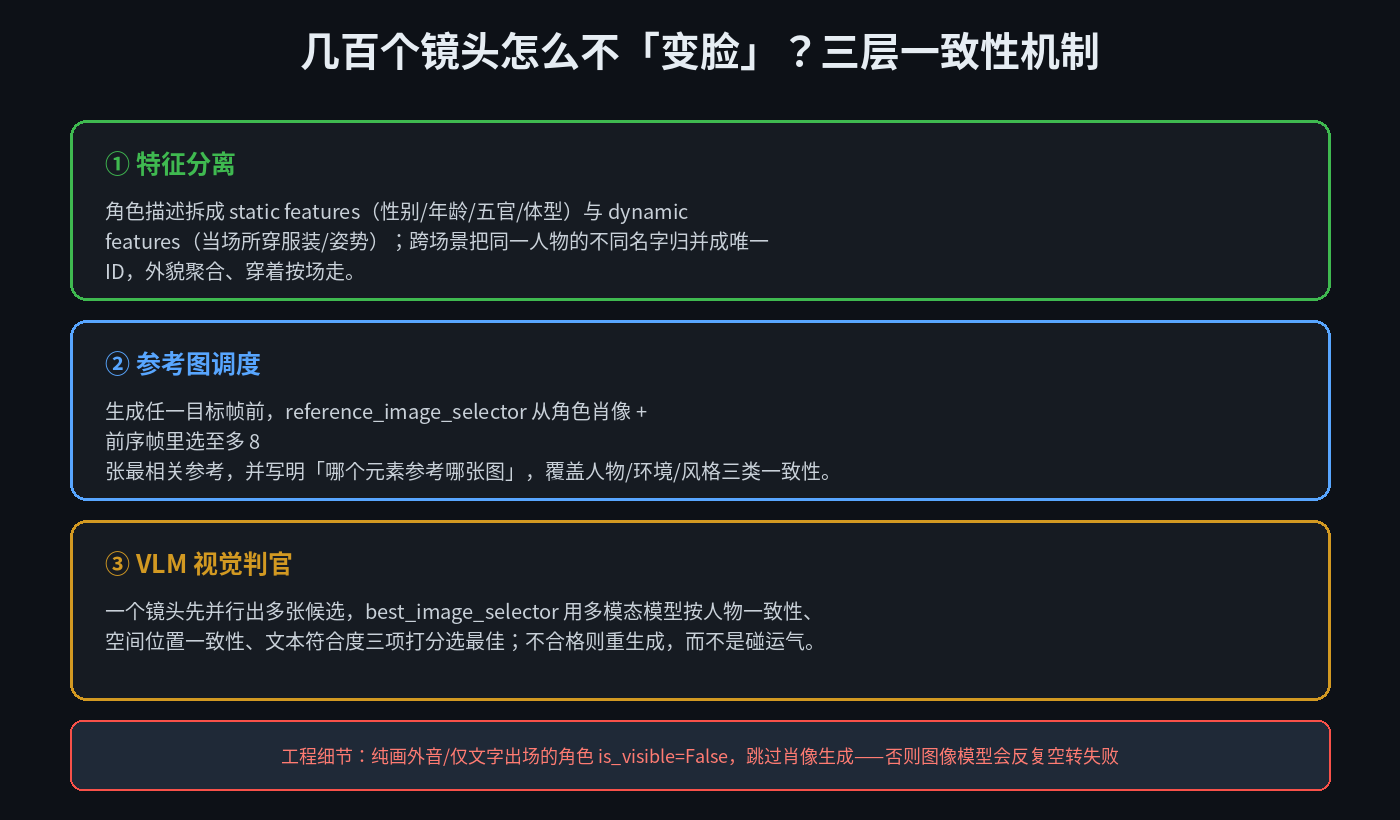
第一层,静态/动态特征分离 + 跨场景角色融合。 我读了 global_information_planner.py 的提示词,它要求把每个角色拆成 static features(性别、族裔、年龄、五官、体型、发型这类不变量)和 dynamic features(这一场穿什么、什么姿势、什么表情)。更有意思的是角色融合:小说里同一个人可能在不同场景被叫不同名字(「张三」「三哥」「老张」),它有专门的 merge 步骤,用语境、对话风格、人物关系判断哪些名字指向同一实体,归并成唯一 ID、聚合静态特征,同时记录每个场景里用的是哪个称呼。提示词里还有一条很懂叙事的规则:如果一个角色在场景 0 是小孩、场景 1 变成大人,那要拆成两个角色(相当于需要两个演员),不能强行合并。
第二层,参考图调度。 生成任何一个目标帧之前,reference_image_selector 会拿到当前帧的文字描述和一批「角色正面肖像 + 前序已生成帧」的描述,从中挑出至多 8 张最相关的参考图,并生成一段提示词,明确指定画面里哪个元素参考哪张图——同时约束人物一致性、环境一致性和风格一致性。这一步的本质是:不把全部历史帧塞进上下文(又长又贵又会分心),而是检索出最相关的少数视觉锚点。
第三层,VLM 视觉判官多候选选图。 这是我认为最「反侥幸」的设计。best_image_selector.py 不是生成一张就用,而是一个镜头先并行出多张候选图,再调多模态模型当裁判,从三个维度打分:人物一致性(七项外貌特征逐项对参考图)、空间一致性(角色相对左右位置、场景布局是否和参考一致)、文本符合度(候选图是否真的画出了目标描述,且把描述当结果而非编辑指令),最后只取最优的一张;都不达标就重生成。提示词里还专门交代:优先选没有白边、黑边或多余画框的图。等于把「抽卡」从碰运气变成了「批量生成 + 自动品控」。
长篇改编则靠检索兜住设定。novel2movie_pipeline.py 用 langchain 的 RecursiveCharacterTextSplitter 切块、FAISS.from_texts 建本地向量库,处理每个事件时 similarity_search(k=10) 取回原文片段,再过一遍 rerank_model(配置里是硅基流动的 BGE)重排。目的很直接:模型上下文塞不下整本小说,就按事件检索相关原文,避免长篇改编时丢掉早期埋下的设定。
三、机位树与首帧:把「镜头语言」变成数据结构
普通玩家写提示词只会描述画面,ViMax 把摄影本身结构化了。camera_image_generator.py 里有 CameraParentItem、CameraTreeResponse 这些模型和一个 _validate_camera_tree 校验函数——它把一场戏的多个机位组织成一棵树,先 construct_camera_tree 规划机位关系,再 generate_first_frame 为每个机位生成首帧。
参考图选择的提示词里能看到这种设计的实际形态:同一场超市相遇的戏被拆成 Camera 0(超市过道中景,两人侧影)、Camera 1(Alice 过肩镜头,只露肩膀在左下,Bob 在中右)、Camera 2(Bob 的反向过肩)。机位之间的人物朝向、左右位置被显式写死并互相引用,所以正反打不会跳轴。首帧定下来之后,视频生成器只需基于这张确定的首帧做图生视频,运动就有了稳定的起点。最后由 moviepy 组装、scenedetect 辅助检测镜头边界。
四、工程底座:分级信号量、多供应商、以及一组「防自己挂死」的测试
把几十上百个镜头跑下来,工程问题和算法问题一样多。ViMax 在这层的成熟度超出我对一个学术开源项目的预期。
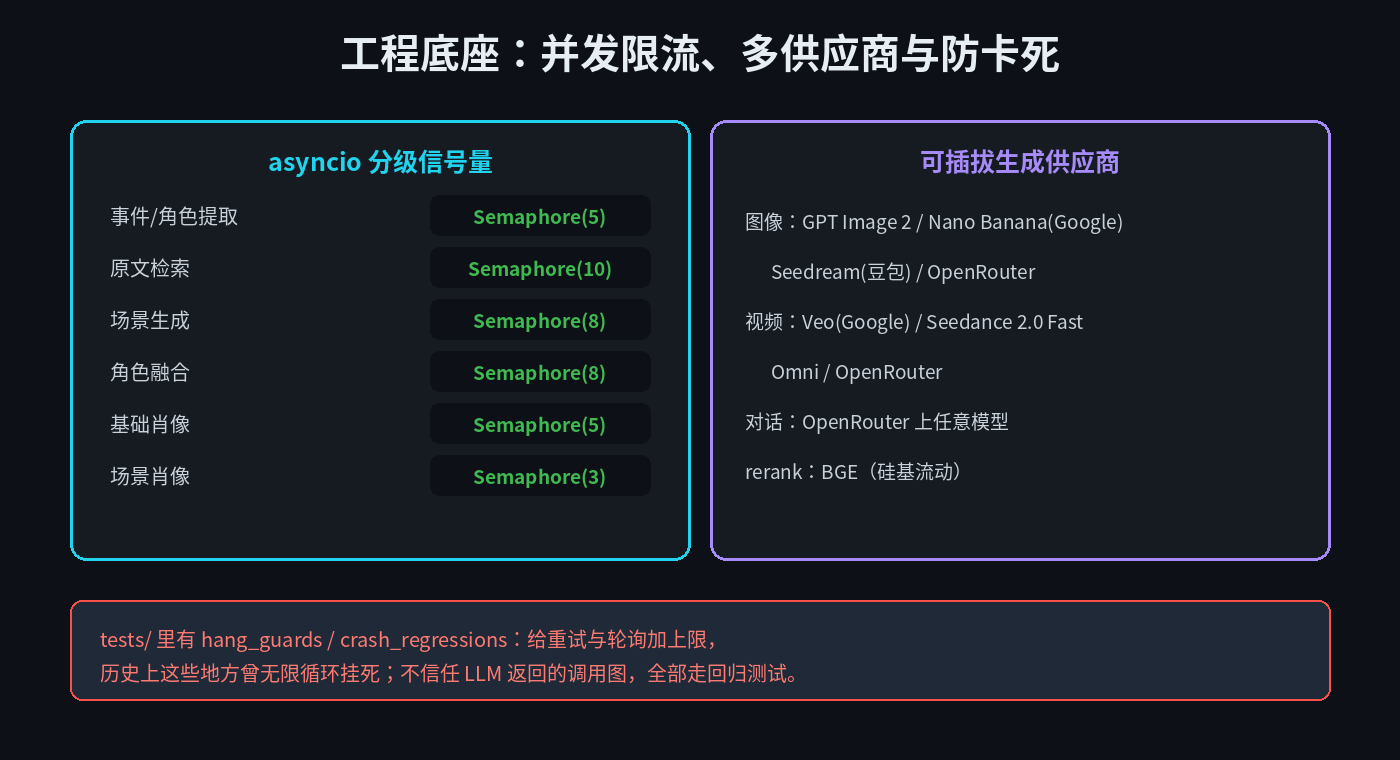
并发不是一把梭。 它用 asyncio,但对不同环节设了不同的信号量上限:事件/角色提取 5、原文检索 10、场景生成 8、角色融合 8、基础肖像 5、场景肖像压到 3。这组数字明显是按任务成本和上游 API 限流调过的——检索是轻量 IO 给 10,最贵的场景肖像只给 3,既压缩总时长又不至于打爆配额。README 宣传的「并行加速生成」在代码里是实打实的分级限流,而不是简单 gather 全部任务。
供应商全链路可插拔。 tools/ 里图像后端有 GPT Image 2(OpenRouter)、Google Nano Banana、豆包 Seedream;视频后端有 Google Veo、Seedance 2.0 Fast、Omni;对话模型走 OpenRouter 可接任意模型;rerank 用 BGE。配置文件甚至分了标准版和 _minimax 版。三家配置(chat_model / image_generator / video_generator)各自填 class_path 和 api_key,换模型就是改 YAML。
最打动我的是测试目录的命名。 test_hang_guards.py 文件头写得很直白:被测的 bug「以前会无限循环」,测试用的假对象在第 N 次调用后才成功,于是有 bug 的代码会快速断言失败(多调了或没抛异常),而不是把整个测试套件挂住。它给图片/视频下载的重试、视频生成的轮询都加了次数上限,并且明确「不信任 LLM 返回的调用图」。此外还有 test_image_orientation.py(图像方向)、test_hygiene_guards.py(卫生守卫)、test_crash_regressions.py(崩溃回归)。
一个很能说明细节用心程度的例子藏在 idea2video_pipeline.py 的注释里:纯画外音、只在对话里出现而从不出镜的角色,is_visible=False,会被跳过肖像生成——因为对一个没有外貌描写的声音角色去要正面/侧面/背面肖像,图像模型只会反复失败(finish_reason=IMAGE_OTHER、候选为空)。这种「知道模型会在哪里犯傻」的防御,是真跑过大量片子才写得出来的。
五、怎么跑:uv 起后端,Node 起 Web UI,成本要心里有数
安装走 uv(Python 3.12,PyTorch 走 cu128 源):
git clone https://github.com/HKUDS/ViMax.git
cd ViMax
uv sync
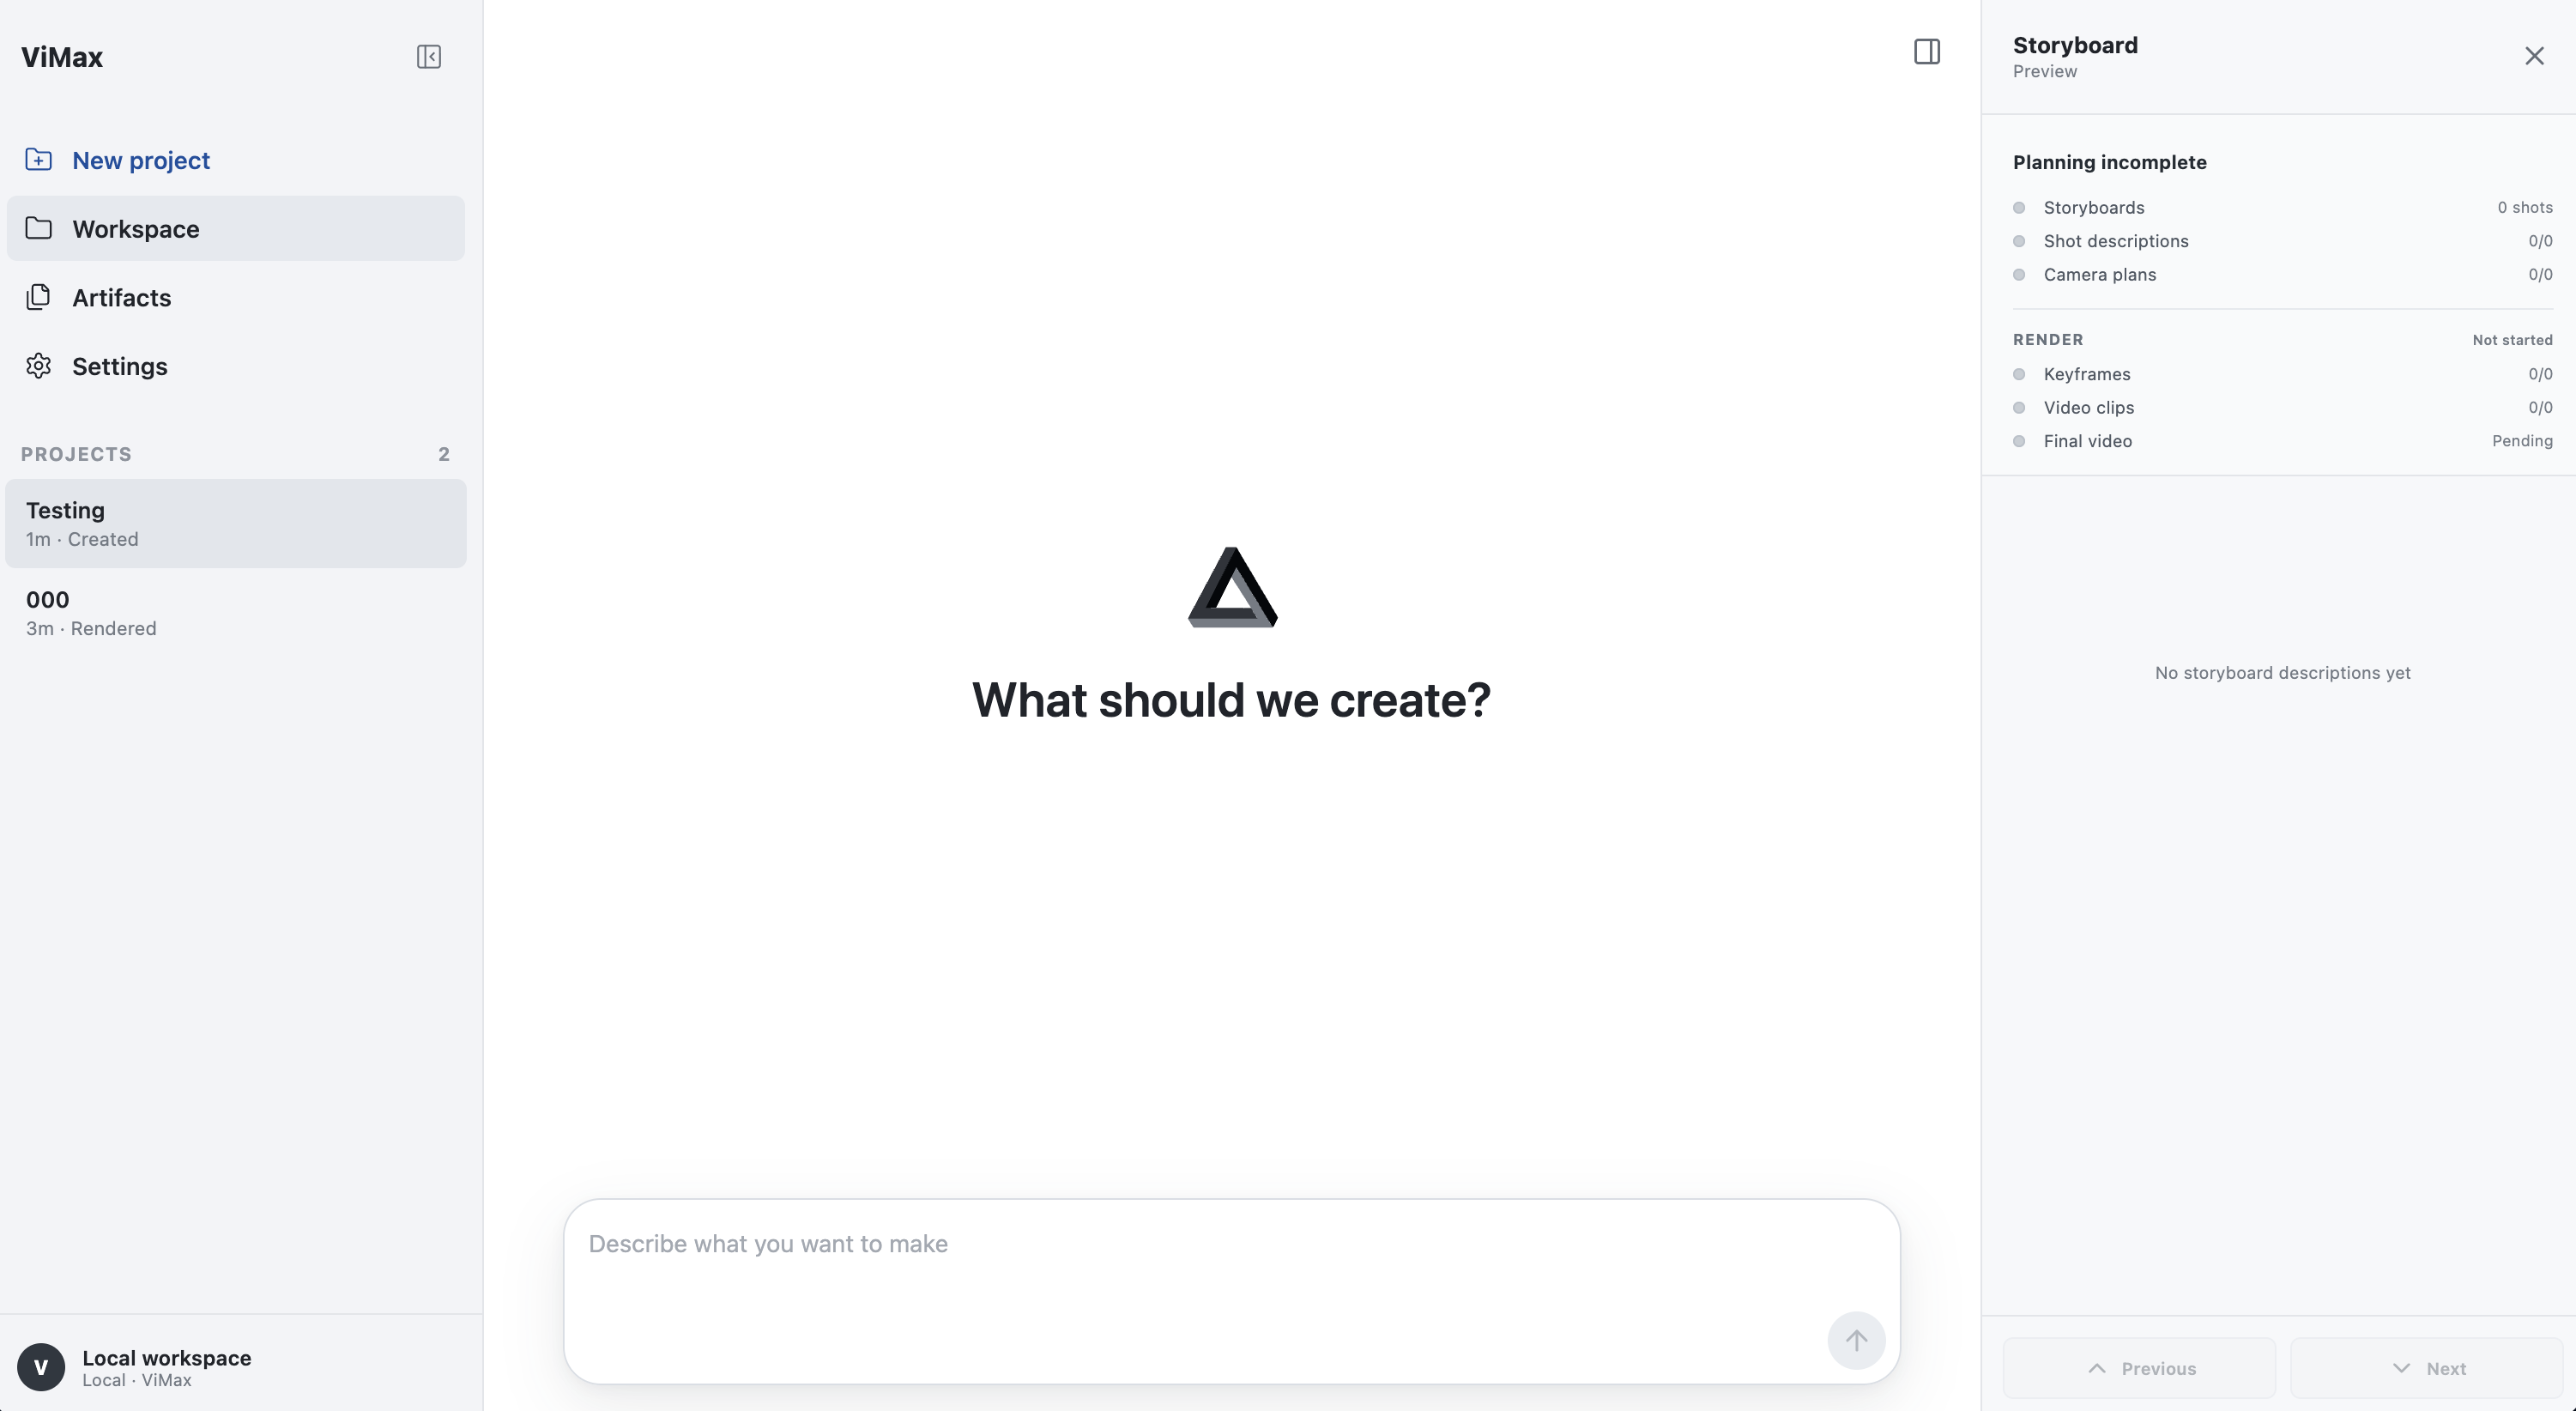
三种用法。脚本式:改 configs/idea2video.yaml 或 script2video.yaml,填 chat_model / image_generator / video_generator 三段的模型和 api_key,在对应的 main_*.py 里写创意或剧本,直接跑。交互式:cp configs/agent.example.yaml configs/agent.local.yaml 配好供应商后 vimax tui,支持 new / resume <session_id> 恢复会话。可视化(v1.2.0 新增):cd web && npm install && npm run dev,浏览器开 127.0.0.1:4173,支持命名项目、Agent 对话、斜杠命令、产物与分镜预览、渲染检查点、文件上传、供应商设置和深色模式;服务默认只监听本地,远程部署要自己做 SSH 端口转发。
成本必须说清楚:这不是本地白嫖的工具。它本身是个编排框架,真正的图像、视频、对话、rerank 全都调用外部付费 API(Google / 豆包 / OpenRouter)。一条几十个镜头、每镜头还要多候选选图的片子,会产生大量图像和视频生成调用,视频生成尤其贵。想试先从 README 那种「不超过 3 个场景」的小猫小狗创意开始,摸清单价再上长片。官方说明支持 Linux 和 Windows。
六、两个 README 没强调、但你该知道的落差
我在源码里发现一个必须如实指出的点:pipelines/novel2movie_pipeline.py 的第一行就写着 # TODO: NOT IMPLEMENTED YET,文件里第 943、946 行还留着中文吐槽注释,说角色匹配的数据结构没做好、「居然还要遍历查找」。需要说明的是,这个文件并非空壳——它有完整的文本规划、检索、场景提取、角色融合、肖像生成方法,agent_runtime 也把小说规划阶段接进了交互流程(plan_text_artifacts 有意在生成肖像和视频前停下,让 Agent Loop 介入)。但这行顶部标注说明:README 把 Novel2Video 和另外两条管线并列为四大能力之一,而代码作者自己认为它尚未完工。 想拿它改编整部长篇的人,要有踩坑和自己补代码的预期,别把它当稳定成品。
第二,README 顶部的演示视频和「电影级」「小时级」措辞是营销口径。仓库自带的是编排框架和一个 30+ 条目的 vimax_benchmark/(多是单场景/双人/三人的镜头级测试样例),真正的成片质量强依赖你配的外部模型和素材,且分钟级长片的 API 成本与人工校验时间都不低。它是一个强大的「生产系统骨架」,不是一键出大片的魔法按钮。
七、判断:谁该现在用,谁先等
适合现在上手的:
- 想系统研究「多 Agent 如何编排长流程生成任务」的工程师——这份代码比多数博客更有参考价值:单一职责 Agent、共享后端、检索增强、视觉品控、分级并发、防挂死测试,构成了一个完整范本;
- 有视频 API 预算、需要批量把剧本/概念做成带一致角色的分镜视频,且愿意在 Web UI 里逐镜审核的内容团队;
- 想自托管编排层、在多家图像/视频供应商之间自由切换的人(MIT 协议,商用友好)。
建议先等的:
- 期待本地零成本、一句话直接出成片的人——它靠外部付费 API,且需要配置和逐镜把关;
- 主要诉求是把整部小说稳定改编成视频的人——Novel2Video 源码自己标着未完成,等这条管线成熟或等你有能力补完再说;
- 没有 Linux/Windows 环境、不熟悉 Python/Node 和 YAML 配置的纯小白,门槛会比较陡。
读完整个仓库,我觉得 ViMax 真正的价值不在那些炫技演示,而在它把一个模糊的「AI 拍片」梦想拆成了可以工程化的问题:用单一职责的 Agent 分岗位、用特征分离和参考检索保人物、用视觉判官做品控、用机位树保镜头语言、用分级并发控成本、用回归测试防系统挂死。 这套方法论,哪怕你不做视频,拿去编排任何「长流程、强一致性、多步骤」的生成任务,都成立。
项目地址:github.com/HKUDS/ViMax,论文在 arXiv 2606.07649。想试的话,我的建议是先用 Idea2Video 跑一个 3 场景以内的小片子,把三段配置和单镜头成本跑通,再决定要不要上长片。