Agent 只产内容、不碰渲染:我读完 niwo-render-everything 的 Skill 定义,看它怎么把 PDF 变成短视频
Agent 只产内容、不碰渲染:我读完 niwo-render-everything 的 Skill 定义,看它怎么把 PDF 变成短视频
「帮我把这篇论文做成一条 90 秒科普短视频」——这句话你大概也对 AI 说过。普通对话框的回答通常是:给你一段口播稿,再附上一串素材链接,然后就没有然后了。图不会下载到本地,镜头不会裁,更不会有什么东西能直接拖进剪辑软件。
这周翻到的开源项目 niwo-render-everything(GitHub 约 130 star,2026 年 8 月 10 日建仓,9 月 4 日最近一次推送)想解决的就是「然后」这一段。它不是一个视频生成模型,也不是一个网页工具,而是一个装在 ChatGPT 工作模式、Codex、Cursor、Claude Code 这类能下文件、能跑命令的 Agent 里的 Skill。我把仓库克隆下来,通读了它 425 行的 Skill 主体定义、两份字段协议文档、689 行的本地校验脚本,这篇文章回答三个问题:它到底替你干了什么、协议设计里哪些地方是真功夫、以及你该不该现在就上车。
一、核心心智模型:把「做视频」切成两半
市面上大多数 AI 视频工具都想端到端:你喂内容,它直接吐成片。niwo-render-everything 反其道而行,在 README 第一屏就把边界画死了——Agent 产出的 zip 不是成片,而是 Niwo 渲染体系的输入。
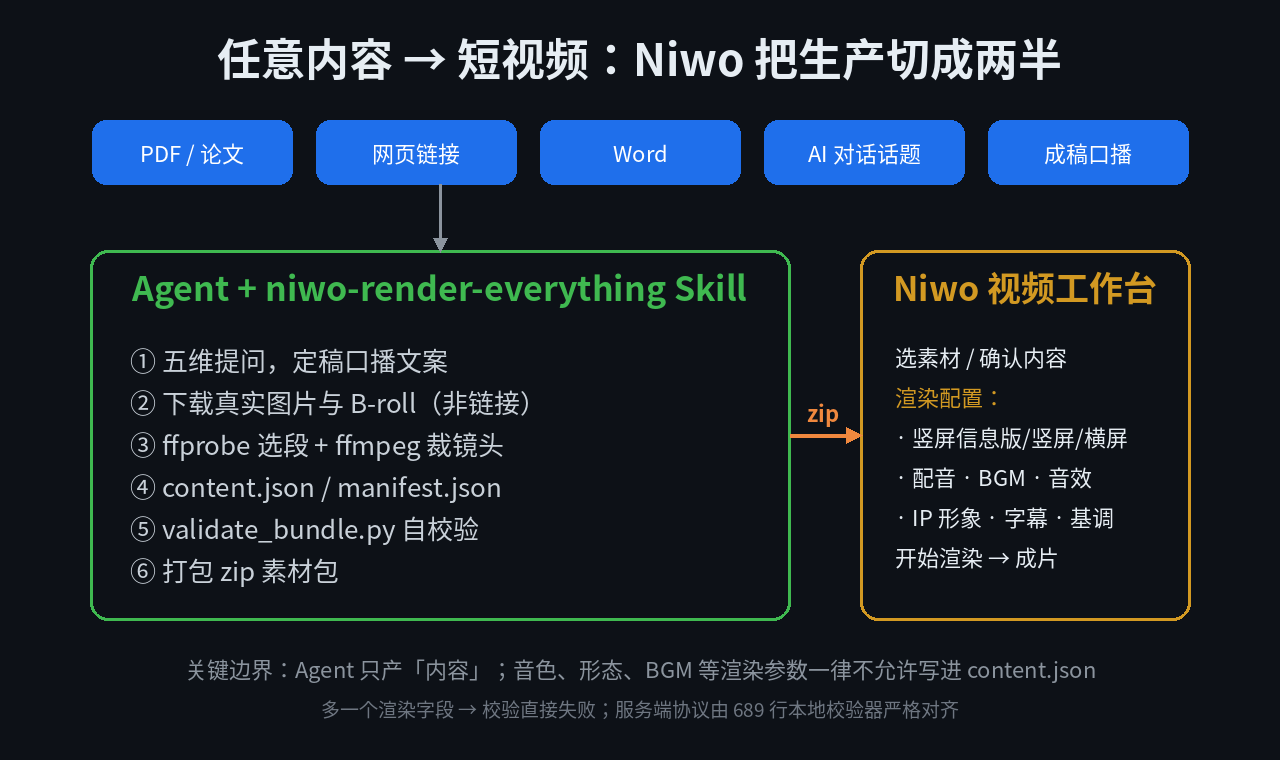
左半边发生在你的 Agent 里,一共六步:先提问定稿口播,再联网下载真实图片和 B-roll 视频(注意,是下载文件本体,不是甩链接),用 ffprobe 探时长、ffmpeg 裁成 8–12 秒的短镜头,写 content.json 和 manifest.json 两份协议文件,跑本地自校验,最后打包成 zip。右半边发生在 Niwo 视频工作台:你在网页里选素材、确认内容、配置成片形态/配音/BGM/智能音效/IP 形象/字幕,点「开始渲染」出成片。
这个切法不是随便画的。它对应一条清晰的工程判断:内容判断(讲什么、用什么画面)适合放在能读材料、能联网、能跑脚本的 Agent 里;而渲染参数(音色、画幅、模板、模型)既没有上下文依据,又变化频繁,应该留给带 UI 的产品端。 一个 Skill 包可以在工作台里渲染成竖屏信息版、竖屏、横屏三种完全不同的片子,内容生产一次、风格决策后置。
二、严格协议:content.json 只接受 7 个字段
真正让我觉得这个项目不是「提示词套壳」的,是它的协议约束。我读了 references/content-schema.md,content.json 的字段表是封闭的——除下面 7 个键之外,多写一个键直接校验失败:
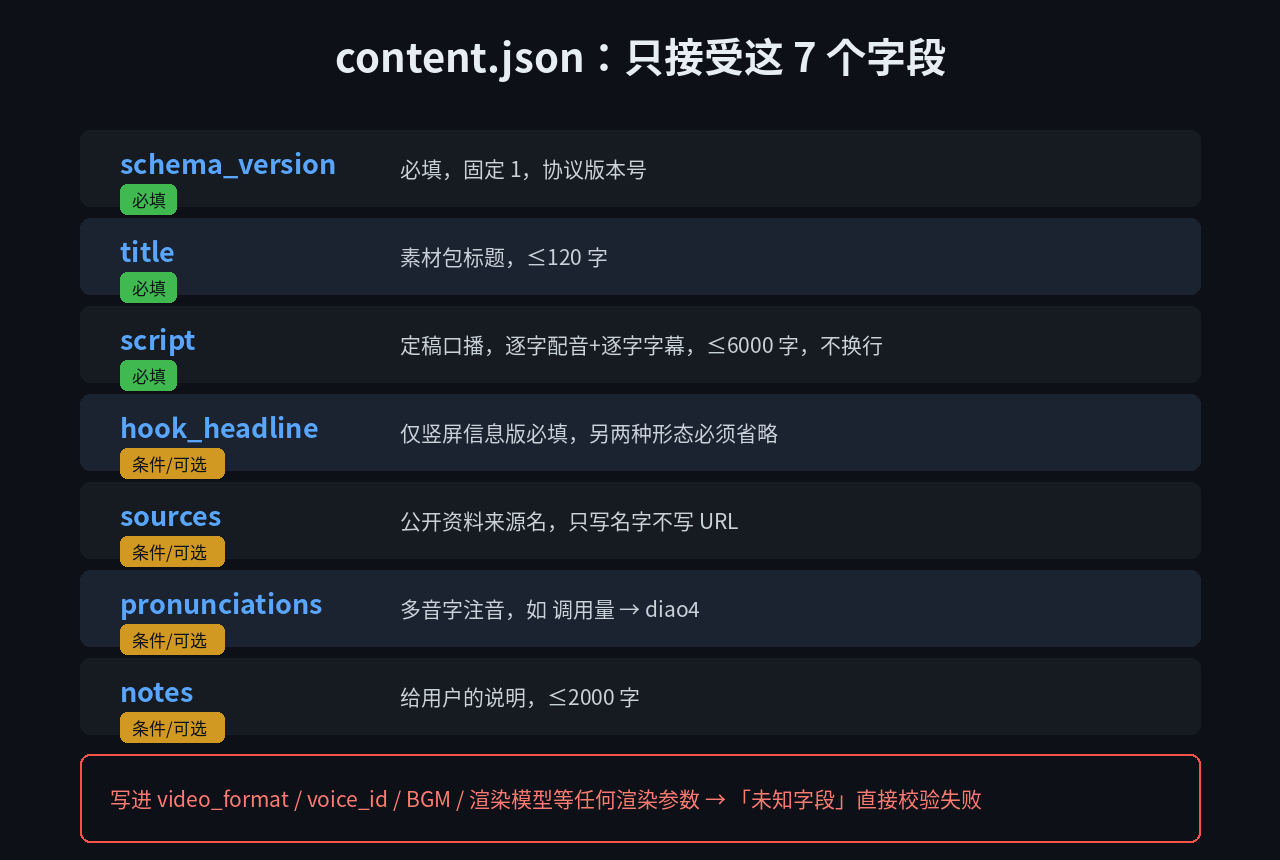
无条件必填只有三个:schema_version(固定为 1)、title(≤120 字)、script(定稿口播,一整段不换行,≤6000 字)。其余四个按条件出现:竖屏信息版才必须带 hook_headline;引用了公开资料就默认写 sources(只写来源名称、不写 URL,前缀由渲染端拼);pronunciations 处理多音字;notes 留给用户。
文档里有一句话值得划重点:成片形态、音色、语速、BGM、IP 形象、明暗基调、渲染模型,全部由用户在工作台选,选完由 Niwo 写进素材包里的 render.json——Agent 既没有判断依据,写了也只会被「未知字段」拒收。 你交付的包里甚至不应该出现 render.json。
script 的约束也很能说明它的产品化程度:这段文字会被逐字朗读成配音、逐字显示成字幕,Niwo 不会改写、润色或增删一个字,所以标题、镜头说明、emoji、括号舞台提示一律不许出现。成片时长没有任何别的旋钮,完全由配音朗读长度决定——中文口播原速约每秒 6 字,90 秒 ≈ 540 字,60 秒 ≈ 360–380 字。字数即时长,这是个很诚实的设计。
多音字注音的格式同样严格:键是文中出现的词,值是逐字对应的拼音,带声调数字,轻声用 5,ü 写成 v,不管的字用 - 占位,且一个词条不能全是 -。例子是「调用量」要注成 diao4 - -,否则 TTS 会把「调」读成 tiáo。
三、最容易写反的设计:钩子标题与成片形态双向绑定
三形态里,「竖屏信息版」是默认推荐:9:16 画布中间嵌一块 16:9 横屏内容,顶部有大标题带,下方是字幕和 IP 形象。另两种是 9:16 满屏的竖屏视频和 16:9 满屏的横屏视频。
hook_headline 只服务信息版顶部那条标题带,它和形态之间是双向绑定,两个方向都不能将就:
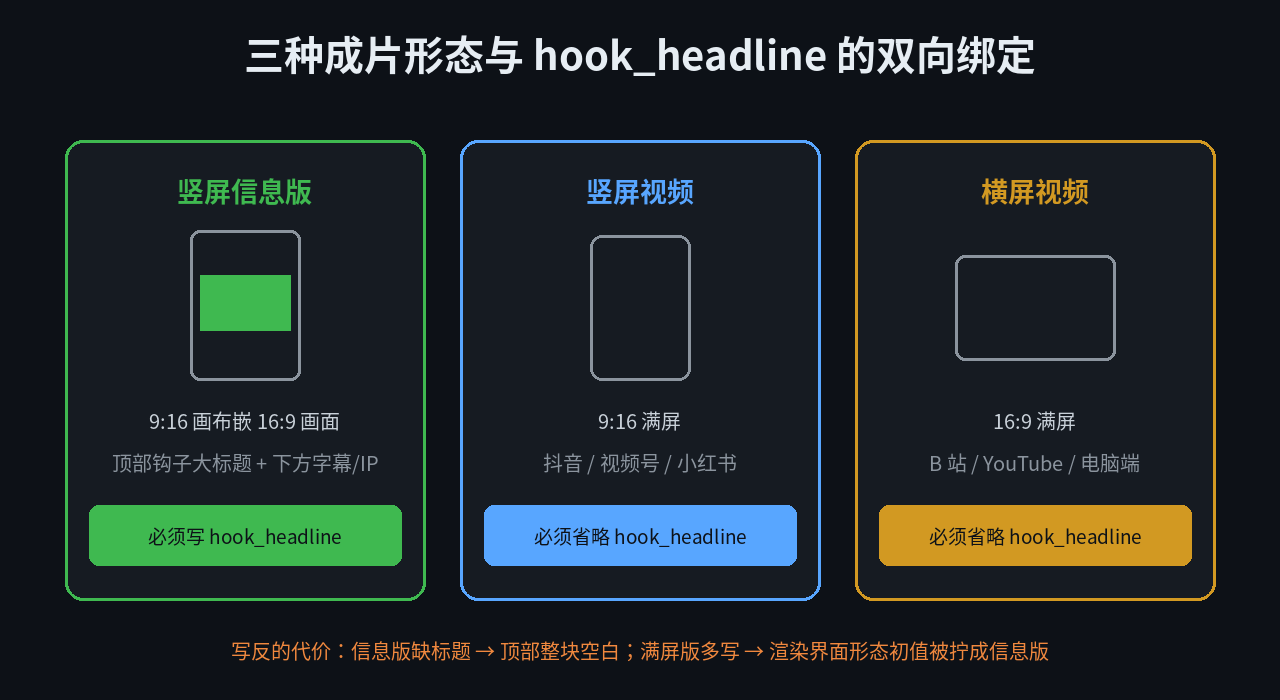
- 选信息版却漏写:标题带没有内容,开场顶部整块空白,Niwo 不会拿标题或口播去补,而且渲染界面的形态初值会退回竖屏视频;
- 选竖屏/横屏却多写:字段不出现在画面上,却会让界面把形态初值拧成信息版,和用户刚选的形态对着干。
标题写法本身也量化到了字宽:推荐两行,第一行铺垫、第二行给冲突,用 [[ ]] 圈出高亮词(每行至多 2 处、整条至少 1 处);长度按可见宽度而非字数算——中日韩字符占满宽,英文数字只算 0.56 个,超过 12 告警、超过 14 直接校验失败。所以 DeepSeek砸1.4亿 虽然 13 个字符,只折合约 8.2 个字宽。这套规则在 validate_bundle.py 里是用正则和宽度常量真刀真枪实现的,不是文档说说。
四、689 行校验器与版本自检:把服务端协议搬到本地
我看了 scripts/validate_bundle.py(689 行,纯标准库),文件开头写明它的规则与 Niwo 服务端严格协议对齐:报错的项服务端一定拒收,告警的项服务端容忍但可能影响成片质量。它检查字段合法性、manifest 与磁盘文件的一一对应、视频选段是否落在真实时长内,甚至能识破「下载失败拿到的是一个 HTML 错误页」这种情况;需要 ffprobe 的检查在缺 ffprobe 时自动跳过。
素材侧的协议(manifest.json)同样是封闭 schema:file 必须是相对路径且不能重复声明,summary 是单行中文、只描述画面里看得见的东西而不是你的解读,tags 2–5 个,script_anchor 从口播里原样摘一句表示建议配画位置。有个很实战的坑被写进了文档:交长原片时如果写了 summary 和 tags 却没填 clip_start_seconds/clip_end_seconds,Niwo 会认为你已挑好镜头,从第 0 秒开始取——大概率取到片头台标。
另一个让我意外的工程细节是版本自检的退出码协议。每次开工前跑一次 skill_update.py,用退出码而不是 stdout 传达结果,Agent 不许自由发挥:
| 退出码 | 含义 | 规定动作 |
|---|---|---|
| 0 | 已是最新 | 什么都不说,直接开工 |
| 3 | 离线/超时没检查成 | 当作最新,不提示、不重试 |
| 10 | 有新版,可选更新 | 告知用户改动点,问要不要更 |
| 20 | 低于最低兼容版本 | 必须先更新,否则旧包可能被拒收 |
而且明确规定「一次任务只检查一次」,素材下到一半不许中途更新——因为旧规则做出的半成品不会自动迁移到新协议。当前版本是 2026-09-04 发布的 1.0.0,min_compatible 也是 1.0.0。
五、怎么装、怎么跑:前提是「工作模式」
安装方式刻意设计成不碰终端:打开你的 Agent,切到能执行任务的工作模式,发一句「帮我安装这个 Skill:https://github.com/MontageAI/niwo-render-everything」,Agent 自行安装。命令行用户则可以 npx skills add MontageAI/niwo-render-everything(加 -g 全局、-a codex -a cursor 指定产品)。
环境三项能力缺一不可,Skill 开头就要求 Agent 自查并立刻告知用户:
- 能联网并把图片、视频下载到本地(普通聊天框和手机助手基本死在这一条);
- 能执行 shell,环境里有
ffmpeg和ffprobe(macOS:brew install ffmpeg); - 能把目录打包成 zip 交付。
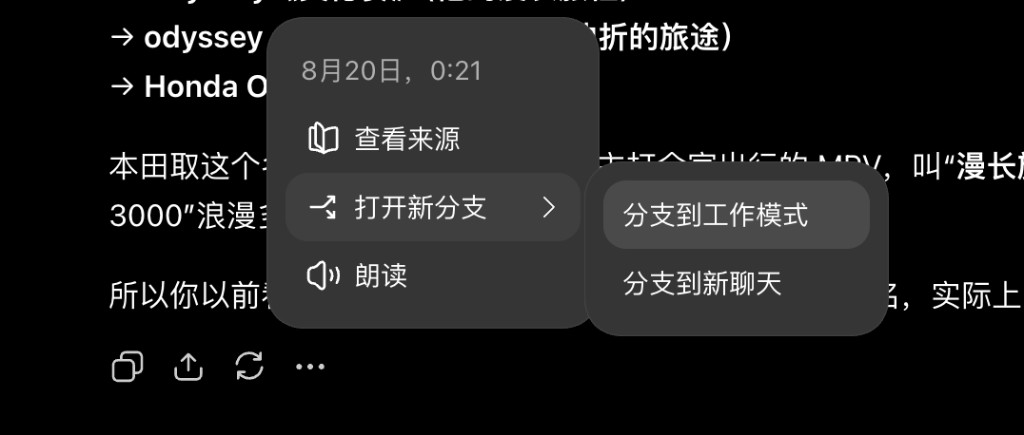
官方实测可用的是 ChatGPT 工作模式(首选)和 Codex;WorkBuddy、豆包工作模式、Cursor、Claude Code 标注为可用但未实测。如果你已经在 ChatGPT 普通聊天里聊了半天材料,正确做法不是硬做,而是在那条消息下点「… → 打开新分支 → 分支到工作模式」,上下文会带过去。
交互上还有个反「自作主张」的设计:开工前必须在同一轮问完五个独立维度——成片形态、目标时长、受众、风格口吻、必讲信息点,不许合并成组合选项,不许靠跨会话记忆替用户默认,只有用户明确说「你定」才能拍板,而且用了兜底值必须明说。素材量也给了经验值:1–1.5 分钟的片子通常 20–30 张图加 8–10 段视频。
zip 拿到后,下载到本地,上传到 Niwo 视频工作台,走「选素材 → 确认内容 → 渲染配置」三步即可。
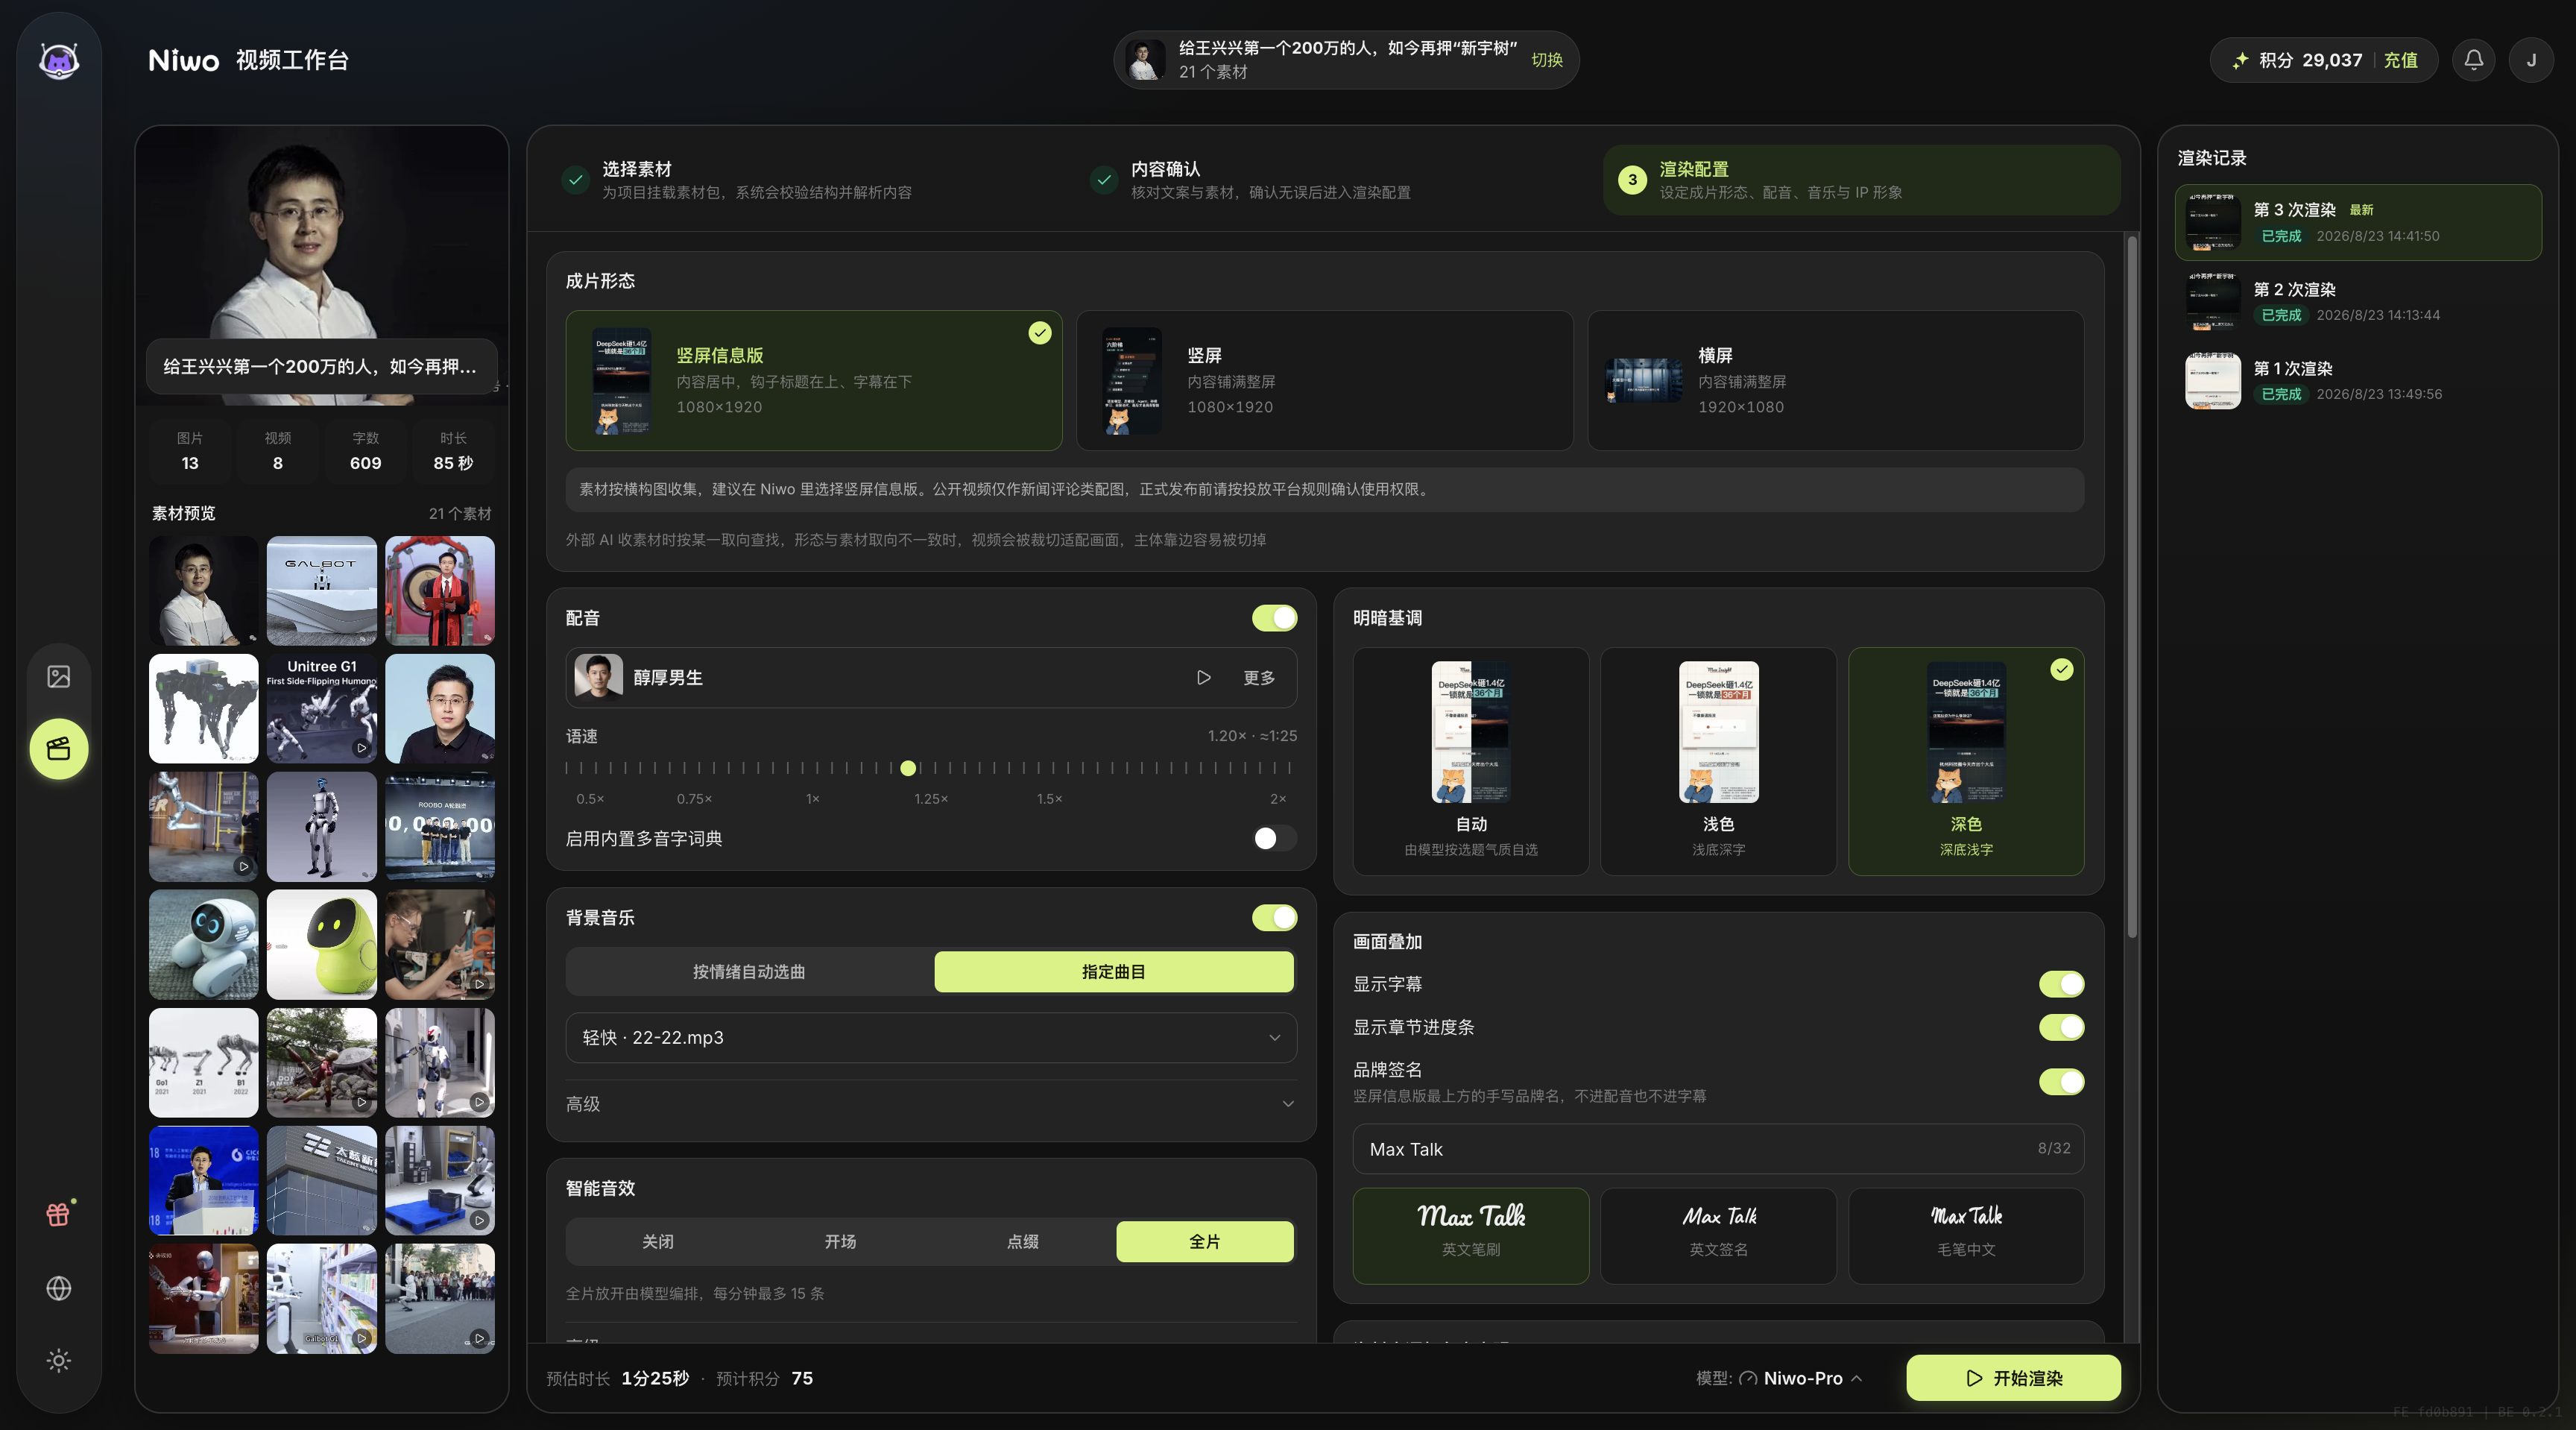
六、两个必须说清的限制
第一,工作台目前在内测,没有账号上传到 niwo.studio/video-studio 会直接卡住,需要先去 niwo.studio/contact 加入「用户领航团」领邀请码和试用积分。Skill 是 MIT 承诺(README 有徽章),但我克隆时仓库根目录没有 LICENSE 文件,GitHub API 的 license 字段也是 null——想商用或二改的话,建议先提 Issue 确认授权,这点我没法替它打包票。
第二,这个仓库是自动同步的镜像,不接受 Pull Request(提交会在下次同步被覆盖),反馈只能走 Issue 或领航团。另外 README 里宣传的「70+ agents 就绪」是生态兼容性徽章,不等于官方逐一实测,真正实测过的只有 ChatGPT 工作模式和 Codex。
七、判断:谁该现在用,谁先等
适合现在就试的:
- 已经在用 ChatGPT 工作模式 / Codex / Claude Code,且本机会装 ffmpeg 的人——安装零成本,一条口令的事;
- 需要把论文、研报、新闻链接批量转成口播短视频的内容团队,素材包可人工增删(多放的文件不写 manifest 也能用,Niwo 会自动补描述),人还能在渲染前卡一道;
- 重视「内容与渲染解耦」的工程型用户——同一份 zip 出三种形态,协议文件可读、可 diff、可校验。
建议先等的:
- 只有手机端或普通聊天框的用户,三项环境能力一条都满足不了,装了也跑不完;
- 期望「一句话全自动出成片、不想碰任何界面」的人——这个产品故意把渲染决策留给你,而且还要先过内测邀请;
- 需要确定性商用授权的团队,等 LICENSE 文件补齐、同步策略说明白再进场更稳。
我读完整个仓库最大的收获,反而不是「做视频更快了」,而是它示范了一种值得抄的 Agent Skill 设计范式:用封闭 schema 划清 Agent 能决定什么、不能碰什么,用本地校验器前置拦截协议错误,用退出码管理版本兼容性,用强制提问防止 Agent 替用户做产品决策。 哪怕你不做短视频,这四条对任何「Agent 产出结构化交付物」的场景都成立。
项目地址:github.com/MontageAI/niwo-render-everything。想试的话记得先确认 Agent 在工作模式、ffmpeg 已就位,以及你拿得到 Niwo 内测资格。